
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Языковой разрыв в проверке фактов удалось сократить, изменяя скрытые представления LLM во время ответа, а не переобучая модель. Работа пока не рецензирована, а все числа получили сами авторы: метод RoSh в среднем закрыл 75% разницы между английским и остальными языками. Для команд с доступом к внутренним активациям модели это предлагает более лёгкую альтернативу многоязычному дообучению.
Модель хранит ответ, но не всегда может его прочитать
Работа Muhammad Ahmad, Fatemeh Seyedin и коллег проверяет одну и ту же модель на одинаковых утверждениях, записанных на разных языках. Английский вариант стабильно получает более точную оценку, хотя содержание утверждения не меняется.
Эксперимент охватывает модели разных архитектур, 1 500 истинных и ложных утверждений и восемь языков: английский, португальский, польский, немецкий, арабский, китайский, русский и турецкий. Набор объединяет энциклопедические факты и новости, которые уже проверяли фактчекеры; неанглийские формулировки взяты из переведённого набора BMLAMA-53.
Разрыв особенно заметен на Llama-3B. Для арабских утверждений площадь под ROC-кривой — показатель того, насколько хорошо модель ранжирует истинные и ложные ответы, — составляет 0,523 против 0,857 на английском. Первый результат почти не отличается от случайного угадывания.
Линейный классификатор, подключённый к промежуточным активациям, при этом успешно извлекает истинность утверждения. Значит, часть ошибки возникает не потому, что модель не знает факт: выходной механизм хуже считывает уже закодированный сигнал, когда запрос написан не по-английски.
Поворот сохраняет информацию, а свободное отображение её искажает
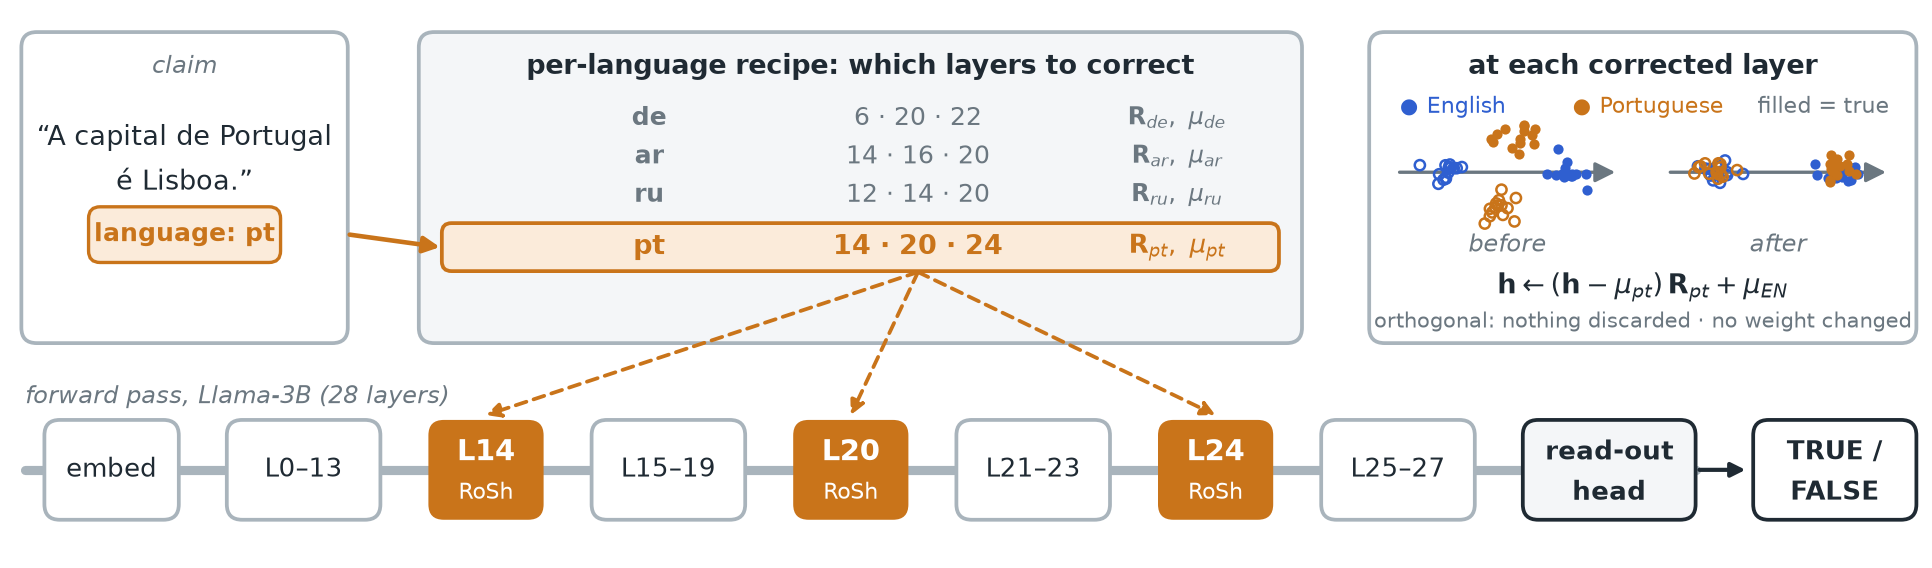
RoSh вмешивается в остаточный поток — вектор скрытого состояния, который проходит через блоки трансформера. Для каждого языка метод сопоставляет активации параллельных утверждений с английскими, сдвигает их к общему центру и поворачивает пространство так, чтобы соответствующие утверждения оказались ближе друг к другу.
Преобразование рассчитывают по 750 парам утверждений и применяют не более чем на трёх выбранных слоях. Градиенты не нужны, веса модели не меняются. Во время вывода система выбирает рецепт для языка и преобразует только состояние в позиции токена ответа.
Ключевое условие — ортогональность поворота. Такое преобразование сохраняет расстояния и углы между векторами, остаётся обратимым и не может улучшить результат за счёт удаления неудобной части сигнала. Оно лишь меняет систему координат, из которой выходной механизм читает ответ.
Свободное линейное отображение, обученное на тех же парах без этого ограничения, сработало хуже исходной модели. В пространстве с тысячами измерений оно подгоняется под установочные примеры и искажает отложенные активации. Проверки со случайными поворотами, сдвигами и перепутанными парами также уступили полному методу.
Само преобразование не использует метки истинности, но они нужны при выборе слоёв. Поэтому RoSh не стоит считать полностью безразметочным способом: параллельные тексты задают поворот, а размеченные примеры помогают решить, где его применять.
RoSh меняет план только при доступе к активациям
Метод подходит командам, которые разворачивают модель самостоятельно и могут менять её прямой проход. Для закрытого API он неприменим: сервис должен разрешать перехватывать и заменять внутреннее состояние на конкретных слоях.
В план работ придётся добавить сбор параллельного корпуса и отдельный рецепт для каждого языка. Зато не нужно хранить новую версию весов, запускать дообучение или рисковать качеством английских ответов: английский путь остаётся без изменений, а рецепты других языков включаются независимо.
Результат пока относится к короткой классификации, где модель выбирает между истинным и ложным утверждением по одному шаблону. Работа не проверяет цепочки рассуждений и открытые ответы, а исходные многоязычные утверждения переведены, а не написаны носителями. Поэтому переносить эффект на чат-бота общего назначения без отдельной проверки нельзя.
Перед внедрением также потребуется измерить задержку и расход памяти на целевом оборудовании. Статья описывает дополнительное матричное умножение в позиции ответа, но не приводит эксплуатационных замеров. Практический вывод уже виден: если многоязычная модель ошибается при чтении собственного знания, сначала стоит проверить её скрытые состояния, а не сразу планировать дообучение.
Источники
Иллюстрация: рисунок из статьи «Fair Fact-Checking: Closing the Cross-Lingual Gap in LLM Factual Judgement with RoSh», Muhammad Ahmad, Fatemeh Seyedin, Adrian Weller и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


