
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Модель научили улучшать собственные критерии оценки для открытых экспертных заданий, где нет единственного правильного ответа. В нерецензированном препринте MIT, Microsoft Research и Johns Hopkins University, где все числа получили сами авторы, метод RRI прибавил 10,9 балла к базовому самообучению модели с 9 млрд параметров. Подход позволяет готовить синтетические задания для медицины, права и финансов, не закрепляя очевидные лазейки в награде.
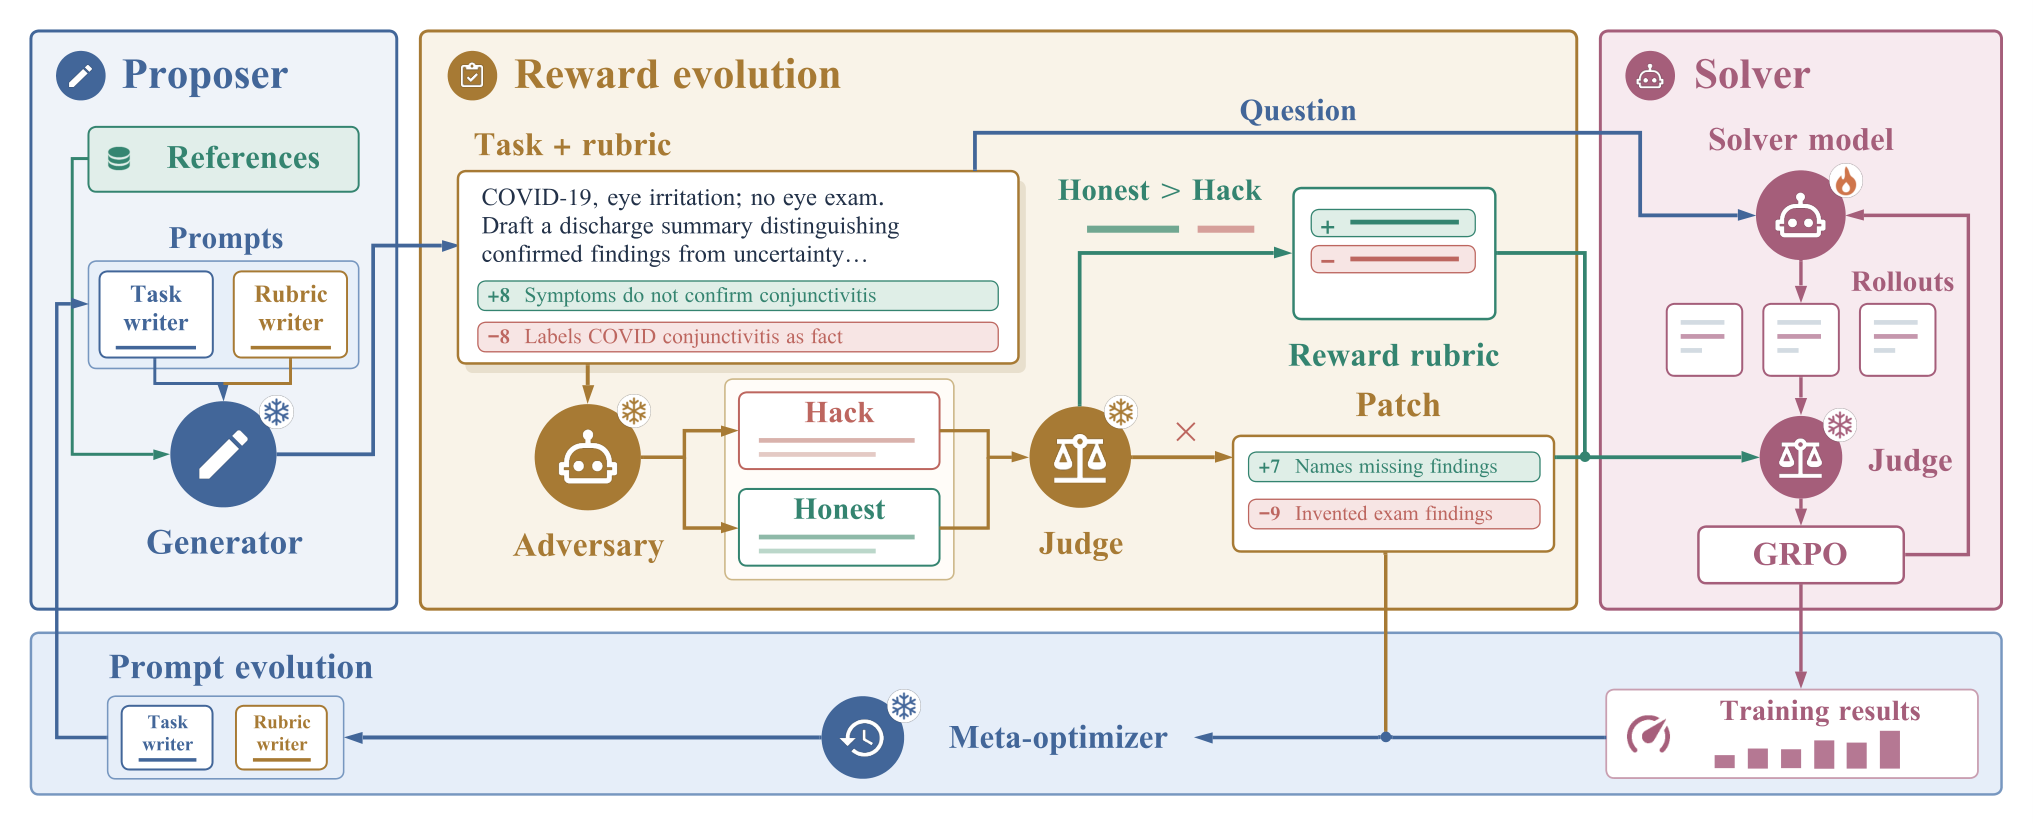
Обычный генератор пишет задание и набор взвешенных критериев, а решающая модель учится получать по ним высокий балл. Почти 99% таких пар «задание — критерии» допускали обман: ответ мог перечислить нужные темы без полезного содержания, не получить штраф за ошибочный факт или воспользоваться расплывчатой формулировкой.
RRI атакует критерии до обучения. Модель видит их и составляет бесполезный ответ, который формально набирает высокий балл; та же замороженная модель отдельно пишет честный ответ, не зная критериев. Затем система сохраняет только те поправки, которые повышают оценку честного ответа относительно уловки. После каждого исправления следует новая атака, всего допускается до двух попыток, а найденные лазейки меняют инструкции для генерации следующих заданий.
На модели с 27 млрд параметров RRI обошёл базовый вариант Generation Only на 12,4 балла. Проверка охватила 525 заданий HealthBench Professional, написанных врачами; обучение при этом использовало сгенерированные задания, а генератор получил только описание целевого набора и медицинские источники. Решатель учился по исправленным критериям, но не видел вредных ответов противника.
Перенос проверили на PRBench Hard и ProfBench с задачами по праву, финансам, естественным наукам и консалтингу. После обучения по описанию медицинского HealthBench Professional модель прибавила к исходной версии 6,6 и 8,0 балла соответственно. Это показывает, что атака на критерии может учить не только медицинским шаблонам, но результаты пока относятся к двум размерам Qwen и к оценке ответов другими языковыми моделями.
Источники
Иллюстрация: рисунок из статьи «Recursive Reward Improvement via Adversarial Meta-Prompt Evolution», Wei Dai, Qianchu Liu, Guanghui Qin и др., CC BY-SA 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


