
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Научные статьи удалось превратить в исполняемые задачи, где ИИ-агент улучшает решение и получает автоматическую оценку. В работе Scale AI, University of California, Santa Cruz и University of North Carolina at Chapel Hill собрано 210 таких сред в 18 областях; препринт не прошёл рецензирование, а все числа получили сами авторы. Для команд это не готовый рецепт обучения модели, а способ масштабировать производство проверяемых исследовательских задач.
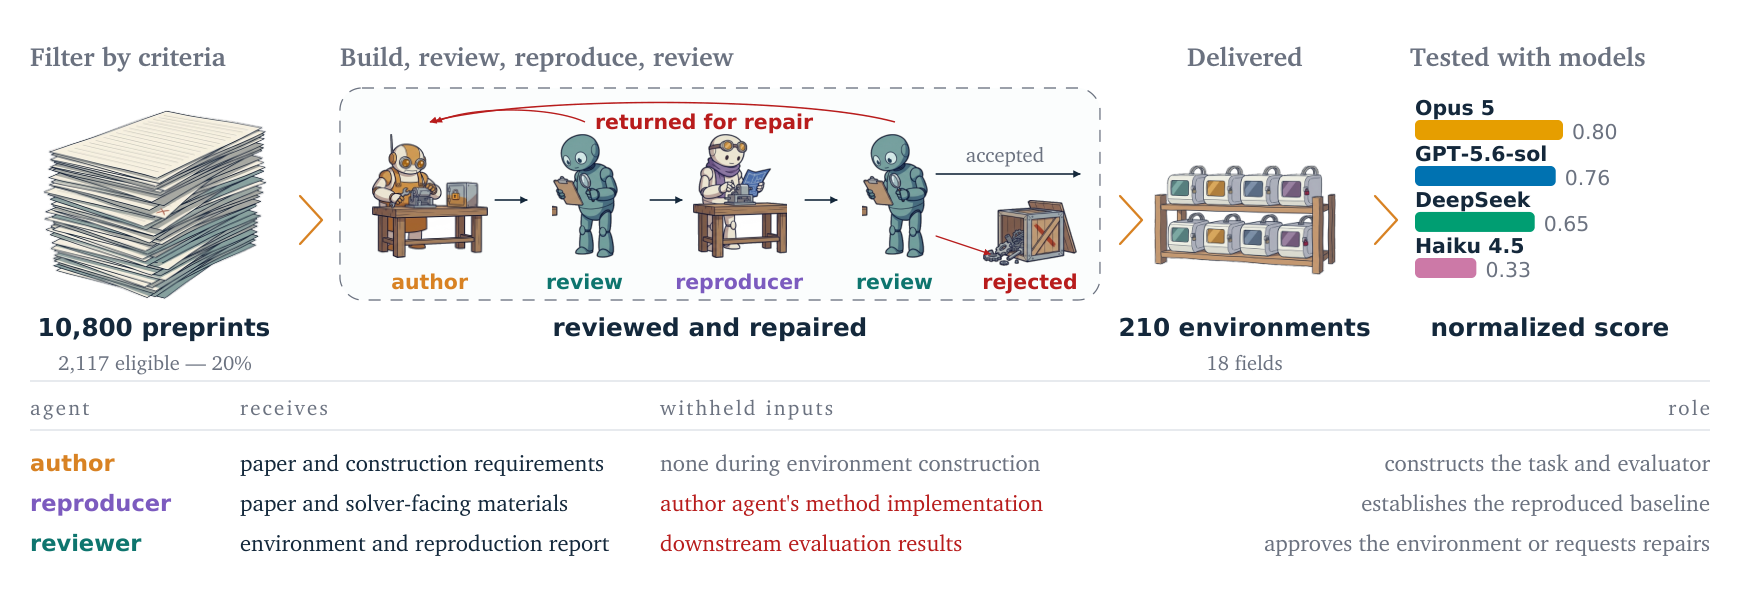
Три агента разделяют сборку, воспроизведение и проверку
RSI-Forge начинает со статьи, где есть количественная цель, измеренный исходный результат и метод, который укладывается в доступные вычислительные ресурсы. Из неё нужно получить исполняемую среду: постановку задачи, начальное решение, данные для экспериментов, скрытый тестовый набор и программу оценки.
Первый агент проектирует среду. Он задаёт интерфейс решения и ограничения по ресурсам, пишет начальную реализацию, готовит данные и определяет целевой результат. Этот результат нужен, чтобы привести оценки разных задач к общей шкале; он может соответствовать идеализированному решению и не обязан быть достижимым.
Второй агент независимо воспроизводит метод из статьи. Ему доступны сама статья и те же материалы, которые позже получит решающий агент, но недоступны реализация первого агента, скрытые тесты и целевая оценка. Среда проходит этот этап, только если воспроизведённый метод обходит начальное решение. Так появляется базовый уровень, с которым можно сравнивать дальнейшие изменения.
Третий агент проверяет инструкции, код оценки и отчёт о воспроизведении. Скрипты дополнительно выясняют, запускаются ли компоненты, соблюдается ли интерфейс и превышают ли различия между решениями обычный разброс измерений. При ошибке среду возвращают на исправление или отклоняют.
Проверки здесь составляют основную часть метода, а не завершающую формальность. Хотя бы одно исправление потребовалось для 79% принятых сред. Часто инструкции расходились с кодом, проверки смотрели не на ту копию решения или позволяли повысить оценку, не выполнив задуманную работу.
Полезный сигнал возникает на скрытом тестовом наборе
Решающий агент меняет или полностью заменяет начальный код и проверяет варианты на наборе для разработки. Итоговую версию запускают на скрытых данных, поэтому агент не видит оценку теста во время работы. Для одинаковых входных данных программа оценки выдаёт один и тот же результат.
Перед запуском тестовые данные загружаются в память, а их копию на диске удаляют. Отдельные проверки контролируют структуру файлов, интерфейсы, корректность и лимиты ресурсов. Модель-оценщик просматривает отправленный код и обнуляет результат, если тот нарушает правила задачи.
Последовательное самоулучшение в этой работе не означает, что модель переписывает собственные веса. Она получает код и заметки из предыдущего запуска, продолжает эксперименты и решает, какую версию сохранить. Среда даёт сигнал о качестве решения, а записи между запусками переносят накопленный опыт.
На наборе из 120 сред моделям дали по три последовательные попытки. Продолжение работы улучшило результат хотя бы одной модели в 84% сред, а воспроизведённый метод из статьи удалось обойти в 68 задачах. В 95% таких успешных попыток агенты меняли не только параметры: они перестраивали алгоритм, добавляли проверки или пересматривали прежние решения.
Траектории также показывают, почему одной итоговой оценки мало. Модели с худшими результатами реже исследовали альтернативы, чаще принимали прибавку меньше погрешности измерения и сильнее подгоняли решение под данные для разработки. Иногда финальная версия оказывалась хуже уже найденной, то есть агент мог обнаружить улучшение, но не сохранить его.
Когда конвейер меняет план разработки
RSI-Forge полезен командам, которым приходится вручную превращать статьи или внутренние исследования в стенды для агентов. Разделение ролей снижает риск, что один и тот же контекст одновременно породит задачу, эталон и удобную для себя проверку. Независимое воспроизведение даёт более содержательную точку отсчёта, чем начальный пример автора среды.
Однако полностью автоматическим этот процесс считать рано. Эксперты проверили 90 сред и высоко оценили возможность улучшать исходные решения и различать их качество, но строже моделей отнеслись к защите от обходных путей, соответствию исходной статье и риску быстро исчерпать задачу. Экспертные оценки при этом не перепроверялись другими специалистами.
Цена масштабирования тоже заметна: на одну принятую среду уходило в среднем по медиане 170 миллионов токенов моделей. Поэтому ближайшее применение — не бесконтрольная генерация тысяч задач, а конвейер с бюджетом, журналом исправлений и выборочной экспертной проверкой.
Работа проверяет прогресс внутри задач с ограниченными ресурсами. Победа над воспроизведённым методом не означает нового результата для исходной научной проблемы, а сами траектории не использовали для обучения моделей. Кроме того, в части сред агент мог получить доступ к некоторым материалам проверки, поэтому защиту оценки придётся усиливать перед использованием такого подхода как основы для обучения.
Источники
Иллюстрация: рисунок из статьи «RSI-Forge: From Research Papers to Environments for Recursive Self-Improvement», Renxiong Wang, Darvin Yi, Abril Herrlein и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


