
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
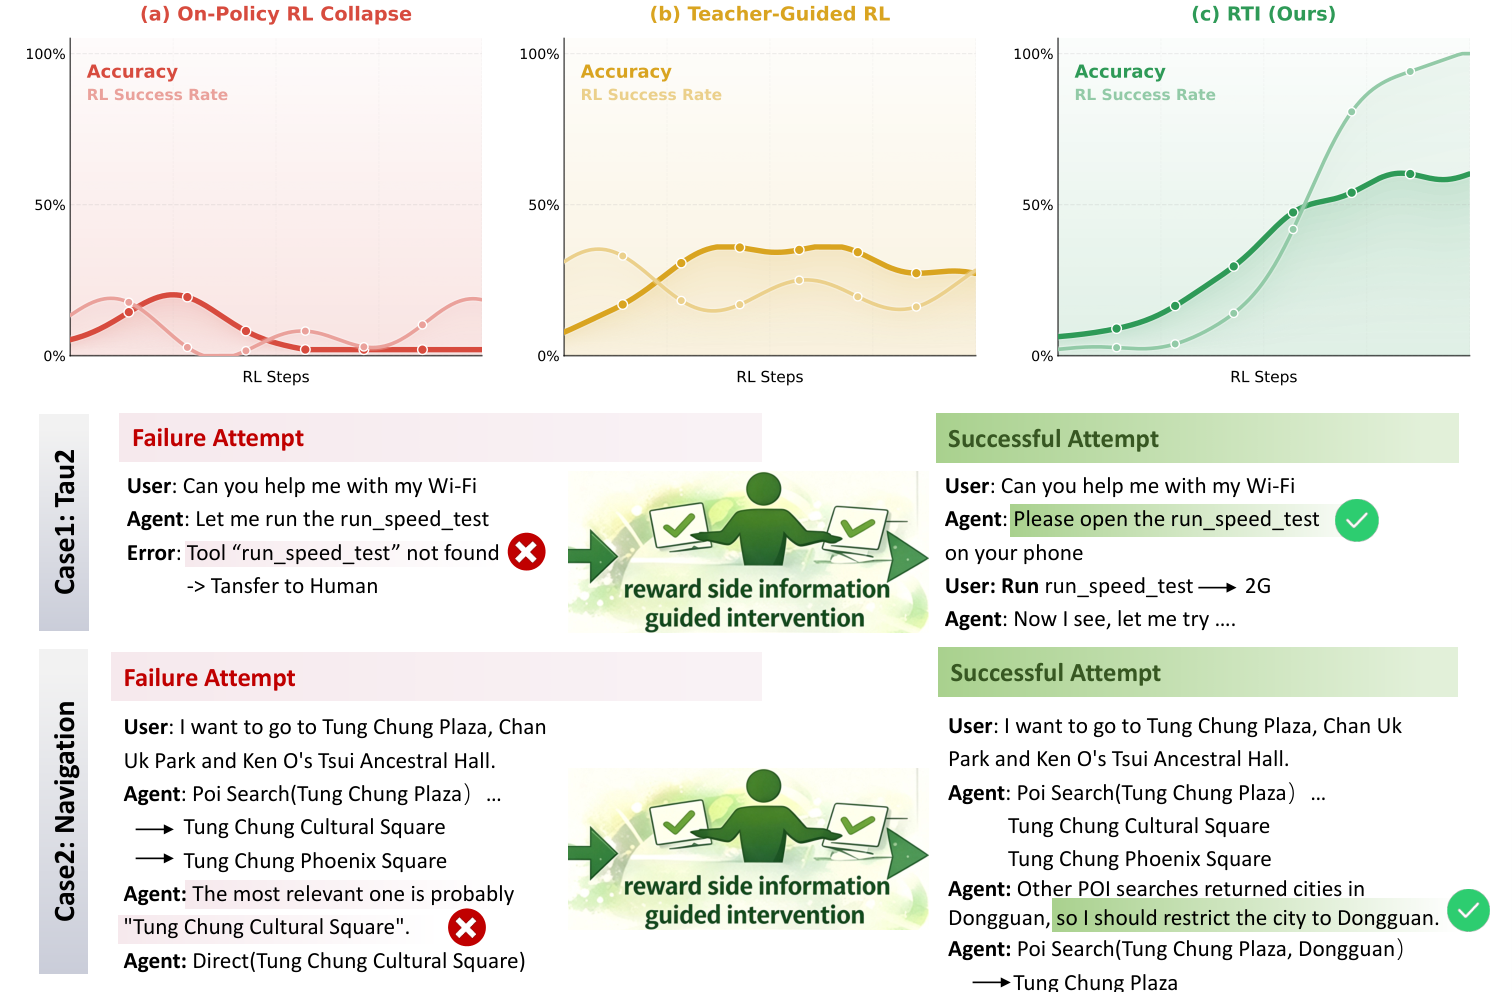
ИИ-агента научили осваивать задачи, которые его исходная политика почти не решает самостоятельно. В препринте Alibaba и HKUST, который не проходил рецензирование и где числа получили сами авторы, RTI поднял успех Qwen3-8B с первой попытки относительно GRPO на 24,56 процентного пункта в τ2-Telecom и на 22 пункта в Navigation. Для обучения сложным действиям это означает, что полезные примеры можно получать без более сильной модели-учителя.
Обычное обучение с подкреплением использует действия, которые текущая версия агента уже способна сгенерировать. Если все попытки провалились, сигнал для обучения исчезает. RTI вмешивается именно в такие группы попыток: один компонент находит критическую ошибку, второй минимально исправляет текущий шаг, а третий проверяет, что исправление не раскрывает ответ из критериев оценки и остаётся правдоподобным для самого агента.
Исправленная траектория отличается от естественного поведения модели, поэтому RTI отбрасывает слишком чуждые ей варианты. Близость оценивают через перплексию — меру того, насколько маловероятен текст для текущей политики. При обучении больший вес получают токены, которые изменили направление рассуждения, а не вся траектория целиком.
Фильтр оказался существенной частью метода: без него успех с первой попытки в τ2-Telecom снизился с 61,40% до 54,39%. При этом стандартный вариант RTI, где агент сам исправлял свои действия, превзошёл вариант с Qwen3.5-397B-A17B в роли корректора. Более сильный учитель предлагал траектории, которые сильнее отличались от поведения обучаемой модели и хуже усваивались.
Метод проверили на пяти наборах задач с Qwen3-8B и Qwen3.5-9B: навигации через реальные API Amap, трёх областях τ2-Bench и сложной части Claw-Eval. RTI сравнивали с GRPO, GSPO, AEPO, OPD и LUFFY. Такие условия покрывают многошаговые диалоги и работу с инструментами, но выводы относятся именно к двум моделям семейства Qwen и выбранным агентным средам.
Источники
Иллюстрация: рисунок из статьи «Rollout-Time Intervention: Unlocking Agentic Reinforcement Learning Beyond Policy Limits», Chen Xi, Ding Ruixue, Wang Zhigaoyuan и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


