
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Систему управления роботом с неизменяемой VLA-политикой научили отбрасывать действия, которые безопасны сейчас, но ведут в тупик. В препринте Tu Nguyen и соавторов, который не прошёл рецензирование и содержит замеры самих авторов, VICS-G снизил средний накопленный штраф за небезопасные действия до 57,5%. Это даёт командам промежуточный слой безопасности, который не требует переобучать основную модель.
Почему локально безопасное действие ведёт в тупик
Политика VLA связывает зрительное наблюдение, текстовую команду и действия робота. Она выбирает следующий блок команд по текущему изображению, инструкции и истории взаимодействия, но высокая вероятность действия означает лишь то, что политика предпочитает его при данных условиях.
Проверка локальной безопасности отвечает на другой узкий вопрос: столкнётся ли робот с препятствием или нарушит ли ограничение на ближайшем отрезке. Действие может пройти такую проверку, но поставить робота в положение, из которого эта же политика уже не умеет безопасно завершить задачу.
Так возникает разрыв между вероятностью и выполнимостью. Политика может снова выбирать движение вперёд после неудачной попытки, потому что само движение остаётся правдоподобным. Однако история исполнения уже показывает, что робот застрял и повторение не приближает его к цели.
Авторы рассматривают выполнимость относительно конкретной политики и динамики среды. Нулевая вероятность безопасного завершения не означает, что выхода нет вообще: другой контроллер мог бы его найти. Она означает, что после выбранного действия продолжения текущей политики не приводят к безопасному результату.
Как VICS учитывает оставшийся путь
Идеальное правило начинает с распределения полных траекторий, которые завершают задачу и укладываются в заданный лимит безопасности. Затем будущие шаги исключаются из расчёта, а для следующего блока действий остаются три компонента: предпочтение исходной политики, локальные награды и штрафы, а также масса допустимых будущих.
Эта масса показывает суммарный вес безопасных успешных продолжений после каждого кандидата. У неё есть две стороны. Поддержка отвечает, остаётся ли хотя бы один путь, доступный текущей политике; величина показывает, насколько вероятны и предпочтительны такие пути.
Точно рассчитать массу во время работы робота непрактично: пришлось бы учитывать скрытое состояние, ошибки исполнения, будущие наблюдения и последующие решения политики. Поэтому VICS-G использует конечный набор действий и приближённые признаки из монитора и истории — например, результаты недавних попыток, расстояние до цели и локальный запас безопасности.
Модуль работает выборочно. Сначала пропускает действие исходной политики через фильтр; повторное ранжирование запускается только при тревожном сигнале. После этого VICS-G сравнивает допустимых кандидатов, но заменяет исходное действие лишь при дополнительном разрешении.
Такой фильтр экономит вычисления, но создаёт отдельный риск: если он пропустит тупиковое действие, модуль повторного ранжирования его уже не исправит. Теоретическая гарантия тоже условна. Лучший жизнеспособный кандидат должен попасть в набор, а погрешность приближённой оценки должна быть меньше разрыва между ним и ближайшей альтернативой.
Когда добавлять VICS между политикой и роботом
Во всех проверенных конфигурациях Safety-CHORES VICS-G уменьшил штраф за небезопасные действия. Доля выполненных заданий осталась в пределах 2,5 процентного пункта от выбора из распределения исходной политики, а средняя продолжительность эпизода отличалась не более чем на 0,82 шага.
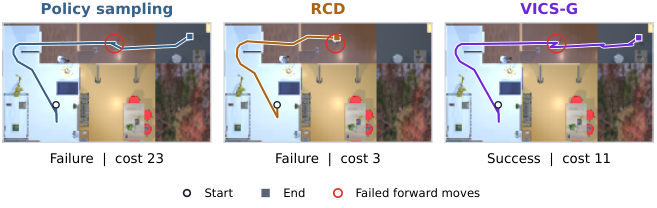
Один эпизод ObjectNav показывает, зачем измерять завершение вместе с безопасностью. Базовая политика не дошла до яблока и накопила штраф 23. RCD остановился раньше со штрафом 3, а VICS-G вышел из цикла неудачных движений, достиг цели и получил штраф 11.
Проверка охватывает симуляционные задачи PickUp, ObjectNav и Fetch, включая версии политик с усиленной настройкой безопасности. Реакцию на ошибки исполнения отдельно изучали при независимых и сохраняющихся в течение эпизода искажениях действий. Поэтому работа обосновывает прототипирование такого слоя в симуляторе, но не переносит полученный результат на физического робота.
Архитектурно работа предлагает не заменять VLA-политику отдельным планировщиком, а сохранить её как источник кандидатов и добавить границу принятия решений перед исполнительным контуром. Для интеграции нужны вероятности или оценки кандидатов, история фактически выполненных действий и монитор локальной безопасности.
Подход подходит системам, где политика уже умеет выполнять задачу, но зацикливается после неудачного действия или выбирает безопасный путь без продолжения. Если система выдаёт только готовую команду и не открывает альтернативы для сравнения, повторное ранжирование потребует менять интерфейс контура управления.
VICS-G не моделирует будущие траектории во время работы и не дообучает политику, поэтому его можно проверять отдельно от основного цикла обучения. При этом практическая оценка будущего остаётся эвристической и зависит от задачи: математический вывод задаёт правильную цель, но сам по себе не превращает приближение в сертификат безопасности.
Источники
Иллюстрация: рисунок из статьи «A Safe Action Is Not Enough: Feasible-Future Decoding for Vision-Language-Action Policies», Tu Nguyen, Matthieu Zimmer, Vu Anh Vu и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


