
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Безопасность LLM удалось усилить без заметной потери общих способностей. Команда из HKU, CAS, IEU и NTU сохранила 99,58% исходных возможностей моделей, хотя работа не рецензирована и приведённые числа получили сами авторы. Подход предлагает альтернативу настройке всей модели: сначала найти компоненты, отвечающие за отказ, а затем менять только их.
Как нашли цепь, которая отвечает за отказ
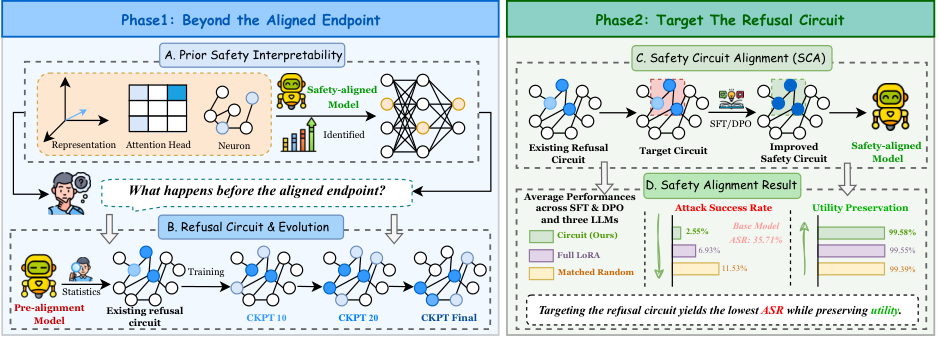
SafeEvo рассматривает отказ не как свойство отдельных нейронов, а как работу связанной группы компонентов. Такая цепь отказа (refusal circuit) представляет собой разреженный вычислительный подграф: его достаточно, чтобы модель отказалась выполнять вредный запрос.
Для поиска цепи метод назначает нейронам многослойных перцептронов обучаемые двоичные маски. Веса LLM при этом заморожены. Маска определяет, какие нейроны входят в цепь, а какие остаются в её дополнении.
Оптимизация одновременно решает две задачи. Выделенная часть модели должна воспроизводить безопасный отказ, а оставшаяся — сохранять способность сформировать вредный ответ. Дополнительный штраф сокращает число выбранных нейронов, чтобы алгоритм не объявил цепью почти всю модель.
На базовых Llama-3-8B, Qwen-2.5-7B и Mistral-7B-v0.1 найденные цепи занимали меньше 1% параметров. Работая изолированно, они отказывались отвечать на вредные запросы из BeaverTails, а их удаление из полной модели устраняло отказ. Случайное удаление такого же объёма параметров не давало сопоставимого эффекта.
Цепь при этом нельзя считать единственным постоянным модулем безопасности. Независимые запуски поиска находили подграфы, которые выполняли одну функцию, но совпадали в среднем лишь на 26%. Во время настройки их состав также постепенно менялся.
Работа связывает эту нестабильность с потерей общих способностей после настройки безопасности. Если обновления свободно переходят между несколькими возможными цепями, они могут затронуть параметры, которые нужны модели для других задач. Эксперимент поддерживает такое объяснение, но не доказывает, что именно этот механизм вызывает каждую просадку после выравнивания.
Что дала настройка только выбранных параметров
На основе найденного механизма команда собрала Safety Circuit Alignment, или SCA. Метод извлекает цепь до настройки, а затем разрешает обновлять только связанные с ней параметры. Его можно сочетать как с обучением на подготовленных ответах, так и с оптимизацией по парам предпочтений.
В среднем SCA снизил показатель вредоносности на 63,21% относительно обычной настройки безопасности. Частота необоснованных отказов на безвредные запросы сократилась на 58,44%. При этом модели сохранили уже упомянутую долю результатов на задачах, которые проверяют математику, знания и выбор правдоподобного продолжения текста.
Подход проверяли на трёх семействах моделей и двух алгоритмах настройки. Безопасность измеряли на HarmBench и AdvBench, лишние отказы — на XSTest, общие способности — на GSM8K, MMLU и HellaSwag. SCA также сравнили со случайным обновлением такого же объёма параметров и с методом, который выбирает отдельные нейроны безопасности; преимущество сохранялось при повторных запусках.
Эти границы существенны: опыт охватывает открытые модели близкого масштаба и конкретные наборы задач. Результат показывает, что целевая настройка работает в нескольких сочетаниях модели и алгоритма, но пока не устанавливает универсальную структуру отказа для любой LLM.
Меняет ли SafeEvo планы разработки
Для команды, которая обучает собственную модель с доступом к весам, работа добавляет практический эксперимент в план настройки безопасности. Вместо выбора только между полной настройкой и разреженным обновлением случайных параметров можно отдельно проверить цепь отказа и ограничить изменения ею.
Метод особенно уместен, когда обычная настройка ухудшает результаты на прикладных задачах или заставляет модель слишком часто отклонять нормальные запросы. В таком случае SCA предлагает измеримую гипотезу: проблема может зависеть не только от данных и функции потерь, но и от того, каким параметрам разрешено меняться.
Это не готовая замена существующему контуру оценки безопасности. Команде всё равно нужны собственные вредные и пограничные запросы, проверки полезности и сравнение с обычной настройкой. SafeEvo меняет место обновления весов, а не определяет требования продукта к допустимому поведению.
Для закрытой модели, доступной только через API, подход неприменим: поиск масок и последующая настройка требуют прямого доступа к весам и промежуточным компонентам. Поэтому работа влияет прежде всего на планы команд, которые обучают или дорабатывают открытые LLM, а не собирают продукт поверх внешнего API.
Источники
Иллюстрация: рисунок из статьи «SafeEvo: Deciphering the Safety Alignment Mechanism and Evolution in Language Models», Miao Yu, Hao Huang, Lu Yuan и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


