
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
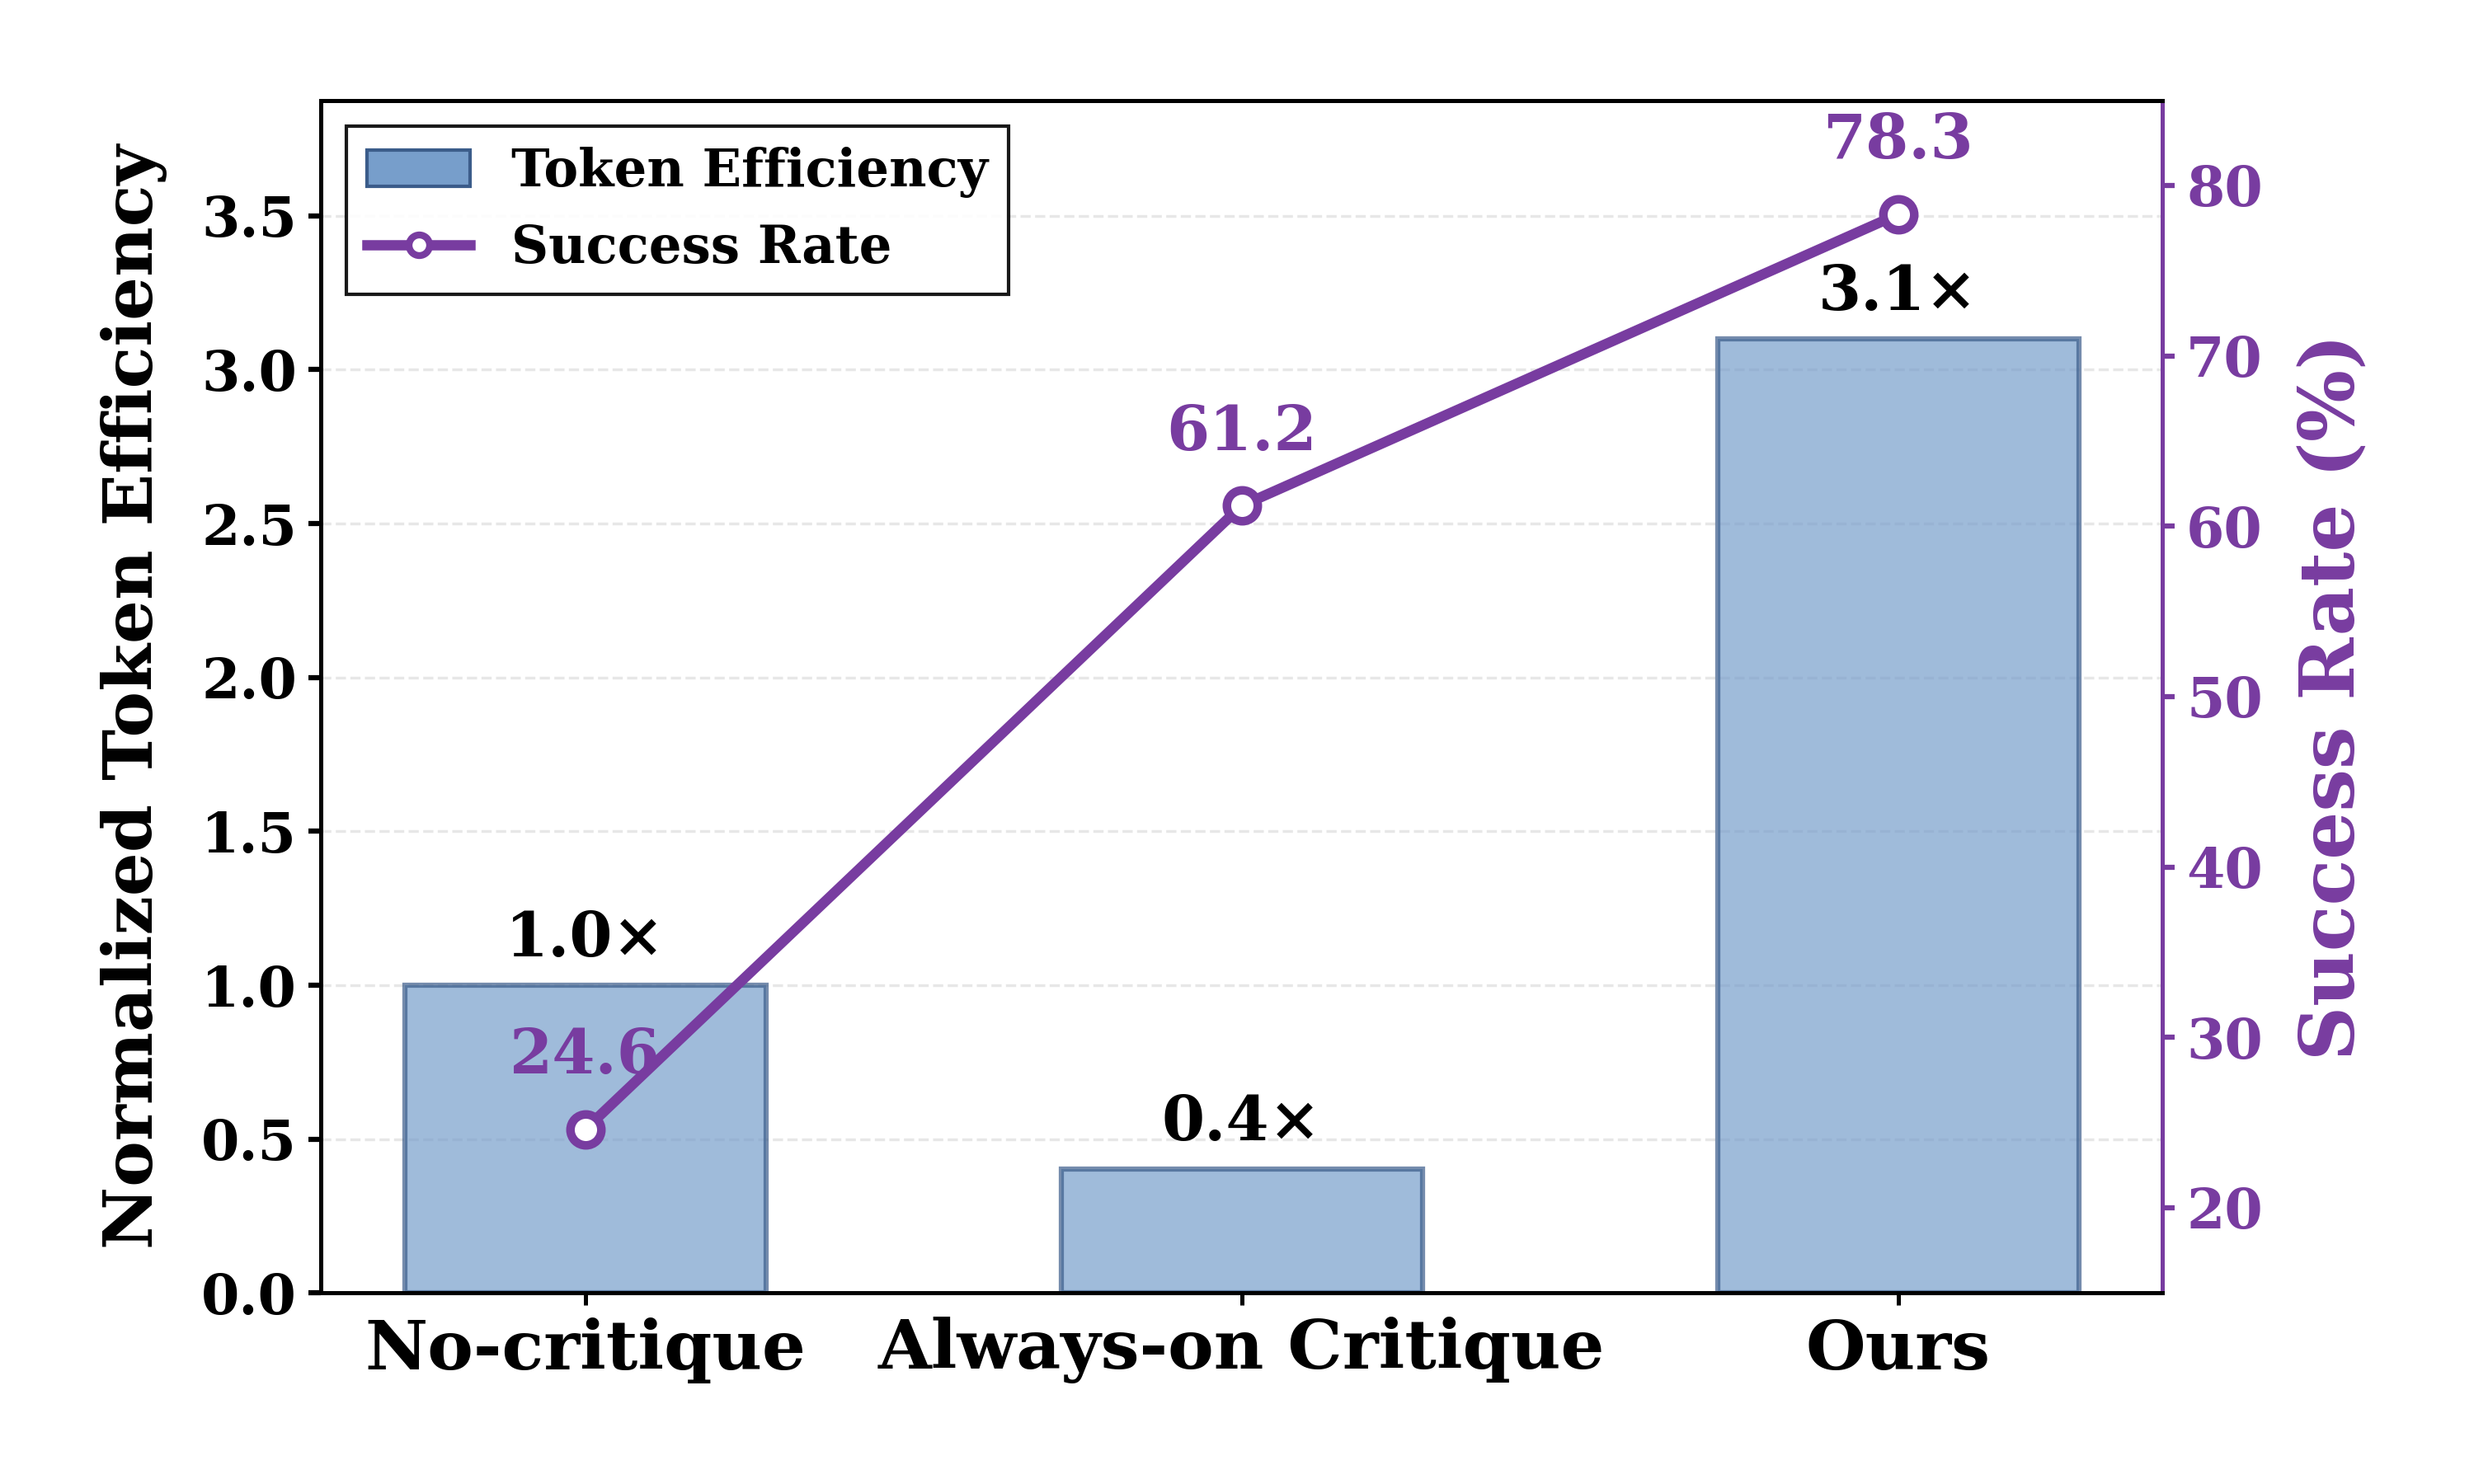
LLM-агента научили исправлять рискованные решения в длинных задачах, не проверяя каждый его шаг отдельной моделью. На ALFWorld доля успешно выполненных задач выросла с 24,6% до 78,3%, а эффективность расхода токенов — успех на заданный объём вычислений — оказалась в 3,1 раза выше ReAct, хотя препринт не рецензирован и числа получили сами авторы. Для агентных систем это предлагает альтернативу постоянной проверке: тратить дополнительные токены только перед неоднозначным действием.
Как агент оценивает пользу критики
Heewon Park, Somin Im и Minhae Kwon назвали подход SAG. В нём исполнитель сначала получает наблюдение, инструкцию, часть истории и список допустимых действий. Затем модель формирует рассуждение и оценивает каждое действие по средней логарифмической вероятности его токенов — так длина формулировки меньше влияет на выбор.
SAG ищет неоднозначность в получившемся распределении вероятностей. Нормированная энтропия показывает, насколько вероятность распределена по всему списку: если близкими выглядят многие варианты, риск ошибки выше. Разрыв между лучшим и следующим вариантом ловит другой случай, когда модель почти одинаково оценивает ближайших кандидатов, даже если остальные явно хуже.
Эти сигналы складываются в оценку, которую сравнивают с порогом. При низкой неоднозначности исполнитель сразу выбирает наиболее вероятное действие. При высокой система передаёт контекст, рассуждение и допустимые действия критику, а затем выполняет предложенный им вариант.
Критик не видит правильного ответа или награды среды и сам может ошибиться. В основных опытах исполнитель и критик работали на одной базовой модели, но получали разные инструкции. Если ответ критика нельзя преобразовать в допустимое действие, система возвращается к исходному выбору исполнителя.
Авторы описывают порог как приближение ценности дополнительной информации: критика оправдана, когда ожидаемая польза от исправления превышает вычислительную цену вызова. Сам механизм не требует отдельного обучения. Порог определяет компромисс между надёжностью и расходом токенов.
SAG также сохраняет действия из успешных траекторий и периодически дообучает на них исполнителя с учителем. В набор попадает выполненное действие, но не рассуждение, которое могло принадлежать исполнителю до вмешательства критика. При каждом обновлении обучение снова начинают с базовой модели, чтобы ошибки предыдущей версии не накапливались.
Постоянная проверка тратила больше токенов и чаще мешала
Подход проверяли на ALFWorld, BabyAI-Text и WebShop с несколькими базовыми моделями. SAG сравнивали с ReAct без критика, LAC с критикой на каждом шаге и вариантами с одинаковым протоколом онлайн-дообучения. Эти среды предоставляют конечный список допустимых действий, поэтому модель не генерирует произвольный вызов инструмента с нуля.
На ALFWorld постоянная критика дала 62,0% успешных задач и потребовала 282 тысячи токенов. SAG использовал 56 тысяч токенов и при этом чаще завершал задачи. Значит, выигрыш объясняет не только дополнительная модель: неразборчивые обращения к ней одновременно повышали стоимость и ухудшали результат.
Отключение любого сигнала неоднозначности снижало качество, причём разрыв между ближайшими вариантами оказался особенно полезен. Без критика результат падал сильнее, чем без отдельного сигнала. Это поддерживает основную конструкцию метода: критика помогает, но момент её вызова определяет, окупится ли помощь.
Онлайн-обучение постепенно переносило удачные исправления в исполнителя. По мере прохождения эпизодов успешность росла, а обращений к критику становилось меньше. В сравнении с тем же обучением без критика или с постоянной критикой именно выборочные вызовы дали лучший баланс результата и расхода токенов.
Когда SAG меняет архитектурный план агента
Работа предлагает не ставить критика после каждого рассуждения по умолчанию. Если среда умеет перечислить допустимые действия, исполнитель может оценить их вероятности без дополнительной модели. Тогда шлюз перед критиком становится отдельным архитектурным компонентом, а его порог — управляемым параметром бюджета.
Такой вариант особенно интересен, когда команда выбирает между увеличением основной модели и добавлением небольшого проверяющего контура. Исполнитель на 7B параметров вместе с критиком на 3B показал результат, сопоставимый с исполнителем на 14B без критики. Это не доказывает универсальную замену крупной модели, но даёт проверяемую гипотезу для систем, где ошибки сосредоточены в отдельных шагах длинной траектории.
Прямой перенос ограничивает устройство эксперимента: SAG рассчитывает неопределённость по заранее известным допустимым действиям. Для агентов, которые свободно создают команды, аргументы API или текстовые ответы, сначала потребуется построить сопоставимый набор кандидатов и научиться получать их вероятности. Без этого основной сигнал для шлюза отсутствует.
Онлайн-дообучение тоже не обязательно для первого внедрения. Шлюз работает без него, а накопление успешных траекторий можно подключить позже. Практический порядок следует из самой схемы: измерить базовую успешность и токены, добавить выборочную критику, подобрать порог под стоимость вызова и только затем проверять, сокращает ли обучение зависимость от критика.
Источники
Иллюстрация: рисунок из статьи «Selective Critique for Cost-Aware LLM Agents in Long-Horizon Decision Making», Heewon Park, Somin Im, Minhae Kwon, CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


