
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
VLA-модель научили осваивать новые действия по очереди, не сохраняя демонстрации старых задач и не стирая прежние навыки. В препринте, который не прошёл рецензирование и содержит замеры самих авторов, SAMBAR сохранил первую новую задачу с успешностью 84% против 0% у всех методов сравнения. Для робототехнической команды это заменяет архив старых траекторий на снимок параметров и статистику их важности, но такую статистику нужно подготовить вместе с базовой моделью.
Как SAMBAR ограничивает изменение параметров
При обычном дообучении модель получает демонстрации нового действия и меняет параметры так, чтобы точнее воспроизводить его. Функция потерь ничего не знает о прежних задачах, поэтому обновления могут перезаписать параметры, на которых держались старые навыки. Это и есть катастрофическое забывание.
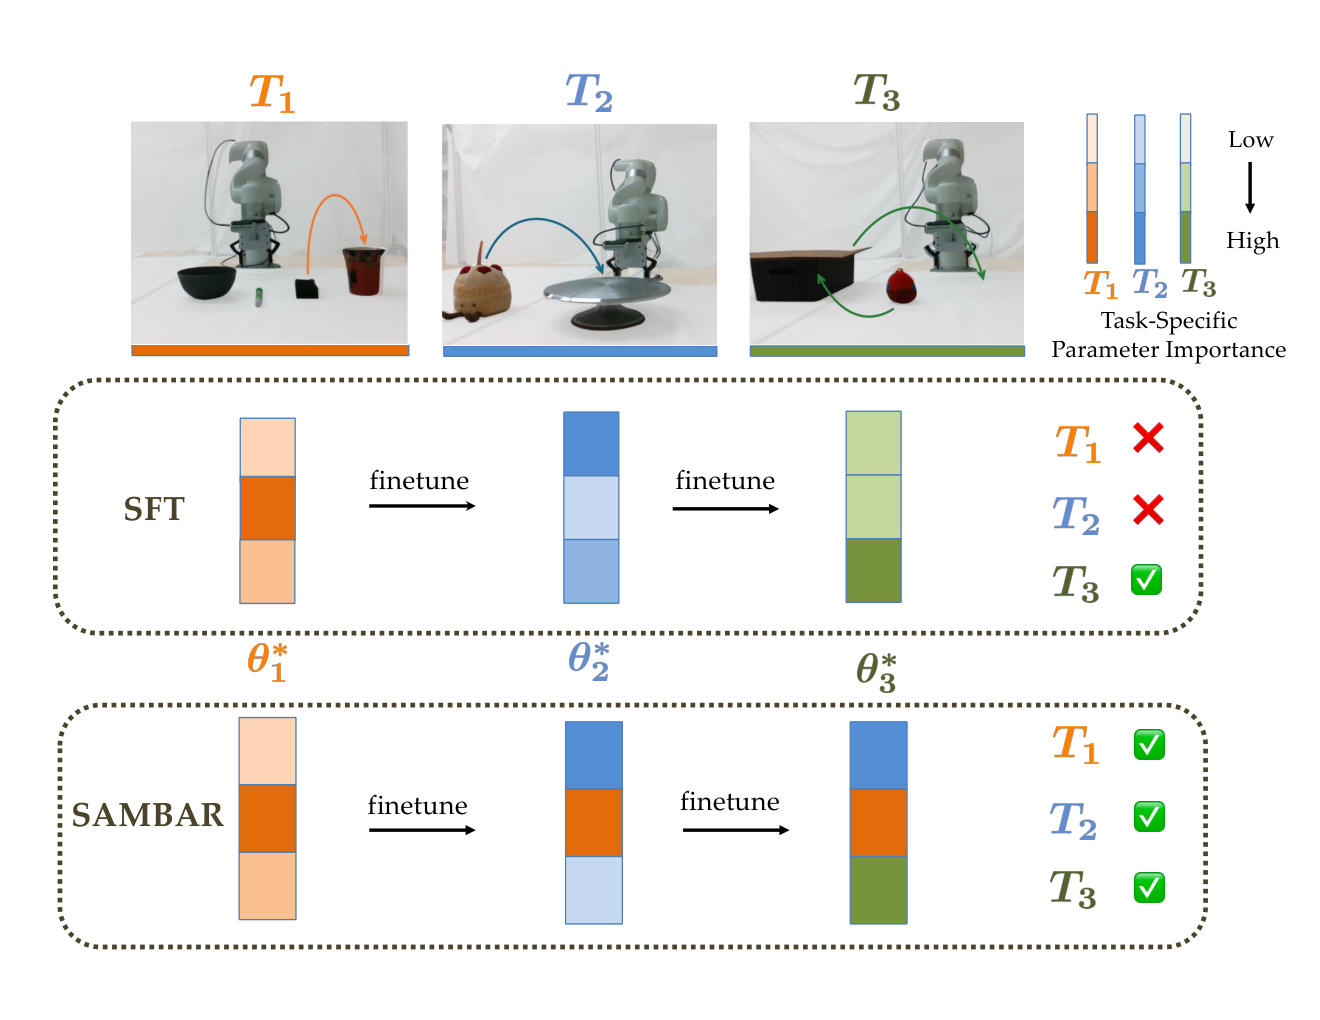
SAMBAR превращает дообучение в задачу с ограничением: модель должна освоить новое действие, но её параметры не должны слишком далеко уходить от предыдущего снимка. Простое жёсткое ограничение не подходит — если удерживать все параметры одинаково, модель сохранит старые навыки, но не выучит новый.
Поэтому метод строит отдельный якорь для каждого параметра. Важность параметра оценивают по среднему квадрату градиента: чем сильнее от него зависит ошибка на задаче, тем важнее он для её выполнения. Фактически это диагональ эмпирической матрицы Фишера — набор отдельных оценок без хранения связей между параметрами.
Якорь объединяет важность старых и новой задач. Если параметр прежде был важен, SAMBAR удерживает его около сохранённого значения. Если он сильнее влияет на новую задачу, модель получает больше свободы его менять.
Само ограничение поддерживает метод множителей. Он накапливает отклонение параметров в дополнительной переменной и повышает цену дальнейшего ухода от якоря. Обычная регуляризация всегда штрафует отклонение с заранее выбранной силой, а здесь штраф усиливается, пока модель продолжает нарушать ограничение.
После каждой задачи SAMBAR добавляет её оценки важности в общий накопленный показатель. Его размер не растёт с числом освоенных навыков: модель хранит текущие параметры и одну диагональную матрицу того же фиксированного размера. Отдельные адаптеры для каждой задачи и старые демонстрации не нужны.
На LIBERO старые навыки пережили последовательное дообучение
В симуляции метод проверяли на LIBERO с 35 задачами, три из которых модель осваивала последовательно. После этого SAMBAR сохранил успешность 88,2% на задачах исходного обучения, тогда как методы с фиксированным штрафом, интерполяцией параметров и обычным дообучением хуже совмещали запоминание с освоением новых действий.
Разбор компонентов показал, зачем нужны обе части метода. Накопительный штраф без оценки важности почти блокировал обучение: модель пыталась удержать каждый параметр. Оценка важности с фиксированным штрафом давала освоить новую задачу, но не останавливала дальнейший дрейф. Баланс появился только при сочетании выборочного якоря и метода множителей.
Проверка на манипуляторе xArm7 охватывала шесть настольных задач. После последовательного дообучения SAMBAR выполнил вторую новую задачу в четырёх попытках из пяти и при этом сохранил все навыки исходного обучения. Масштаб аппаратного опыта остаётся небольшим, но он показывает, что механизм работает не только в симуляторе.
Когда SAMBAR меняет план разработки
Метод подходит проектам, где нельзя постоянно хранить или переносить старые демонстрации: например, из-за объёма траекторий или правил работы с данными. Вместо архива требуется одна политика фиксированного размера, её предыдущий снимок и накопленная оценка важности параметров.
Главное условие закладывается ещё при подготовке базовой модели. SAMBAR начинает работу с матрицы важности, рассчитанной на задачах исходного обучения. Для собственной VLA её можно получить на этапе предобучения и поставлять вместе с контрольной точкой. Если внешний поставщик отдаёт только параметры модели без этой статистики, описанный процесс нельзя применить напрямую.
Для каждой новой задачи команда должна вычислить важность параметров по её демонстрациям до того, как эти данные станут недоступны. Затем оценка войдёт в накопленную матрицу, и демонстрации можно не использовать при следующем дообучении.
За сохранение навыков приходится платить временем обучения. В последовательных опытах SAMBAR давали вдвое больше шагов, потому что накопитель ограничения сходился медленнее обычного дообучения. Поэтому метод скорее меняет архитектуру контура обучения и хранения артефактов, чем служит готовой заменой одной функции потерь.
Работа даёт практический вариант для системы, которая должна последовательно получать новые навыки, оставаться одной моделью и не возвращаться к старым данным. Но решение нужно предусмотреть на этапе создания исходной VLA: после поставки одной контрольной точки недостающую статистику важности взять уже неоткуда в рамках описанного алгоритма.
Источники
Иллюстрация: рисунок из статьи «SAMBAR: Selective Anchoring via Method of Multipliers for Balanced Knowledge Acquisition and Retention in Vision-Language-Action Models», Aayushi Shrivastava, Xunlan Zhou, Hongrui Zhao и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


