
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
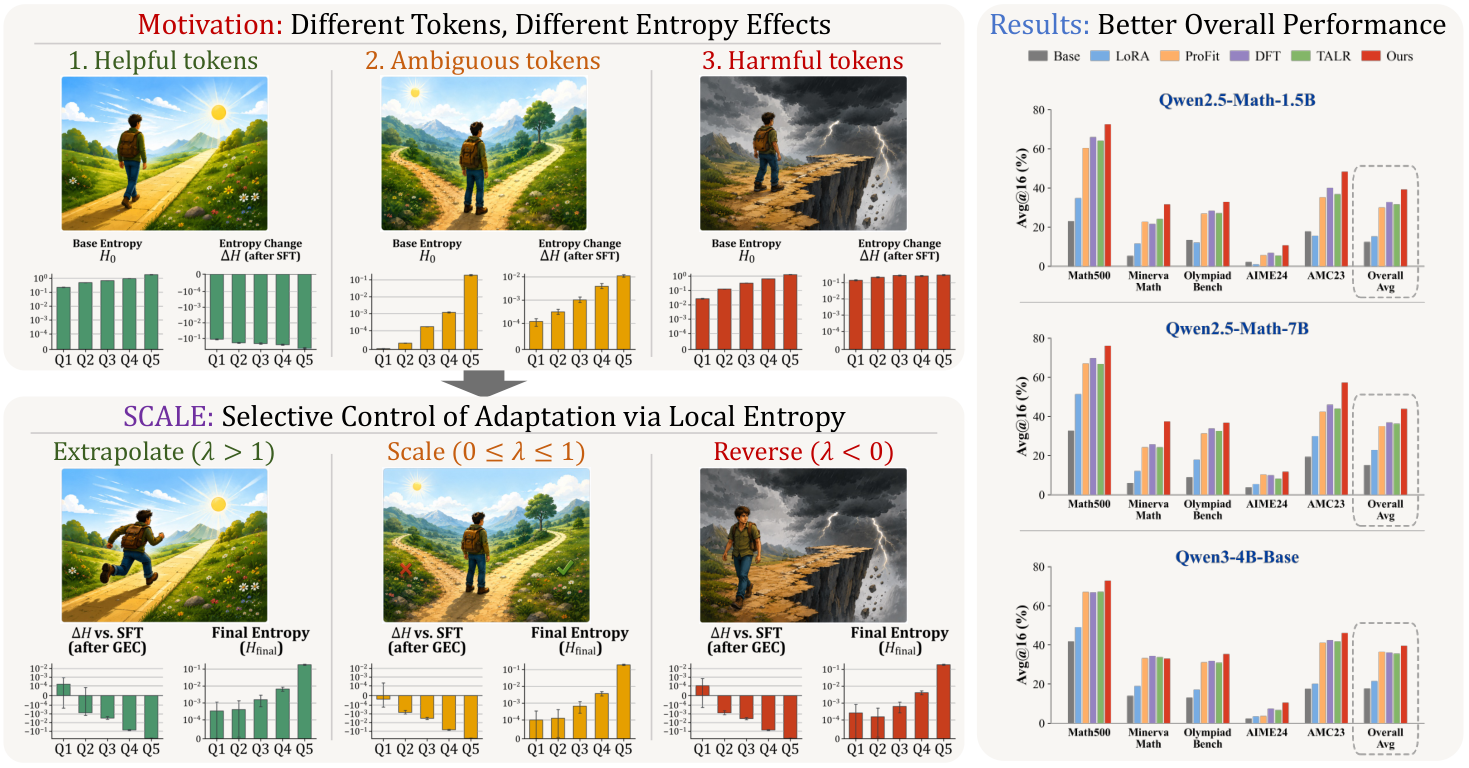
После контролируемого дообучения (SFT) модель можно исправлять, не переобучая полученный адаптер: вредные обновления ослаблять или разворачивать, а полезные — усиливать. В препринте, который не прошёл рецензирование и содержит замеры самих авторов, команда из Shanghai AI Laboratory и пяти университетов показала, что метод SCALE обошёл способы, которые меняют веса токенов во время обучения. Для команд с LoRA это добавляет отдельный этап калибровки после SFT вместо ещё одного полного цикла дообучения.
Почему веса токенов не могут отменить выученный признак
Обычный SFT сильнее всего меняет модель на токенах, которые она считала маловероятными. Так модель быстро осваивает новые шаблоны, но столь же активно запоминает спорную формулировку, ошибочный шаг рассуждения или конфликт с уже полезным знанием.
DFT, ProFit и EAFT пытаются решить проблему через вес каждого токена. Они могут уменьшить вклад сомнительного примера или увеличить вклад полезного, но коэффициент остаётся неотрицательным. Поэтому градиент либо толкает модель в сторону показанного токена, либо исчезает — направить его в противоположную сторону нельзя.
Кроме того, изменение веса во время SFT меняет весь путь обучения. Оно не масштабирует готовое обновление относительно исходной модели, потому что такого зафиксированного обновления ещё нет.
SCALE сначала обучает обычный LoRA-адаптер, затем замораживает базовую модель и разницу, которую внёс адаптер. После этого метод добавляет коэффициенты-регуляторы для отдельных токенов и модулей. Нулевой коэффициент отключает вклад адаптера, значение между нулём и единицей ослабляет его, отрицательное разворачивает, а значение выше единицы усиливает сверх исходного уровня.
Регуляторы обучаются только снижать энтропию — меру неопределённости модели при выборе следующего токена. Для расчёта берутся наиболее вероятные варианты ответа, а исходные параметры и LoRA остаются неподвижными. Дополнительные правильные ответы на этом этапе не нужны, хотя контексты по-прежнему приходят из обучающих примеров.
Энтропия не служит проверкой правильности. Если модель уверенно ошибается, простое снижение неопределённости может закрепить ошибку. Теоретический результат статьи действует при более узком условии: среди изменений, доступных регуляторам, меньшая энтропия должна совпадать с лучшим решением задачи.
Разворот помог математике, усиление — коду
SCALE проверили на Qwen2.5-Math-1.5B, Qwen2.5-Math-7B и Qwen3-4B-Base. Математику оценивали на Math500, Minerva, OlympiadBench, AIME24 и AMC23, код — на HumanEval, HumanEval+ и MBPP. Сохранение общих способностей проверяли через MMLU-Pro, BBH и OpenBookQA.
На математике SCALE опередил DFT в среднем на 5,03, 6,08 и 1,91 процентного пункта соответственно. Отрицательная нижняя граница регуляторов улучшала результат на всех моделях: это поддерживает главную гипотезу работы о пользе разворота части SFT-обновлений.
В генерации кода SCALE получил лучший средний результат среди сравненных методов на каждой модели. Здесь удачные настройки лежали ближе к запрету отрицательных коэффициентов, но разрешали заметно усиливать адаптер. Иными словами, математике чаще требовалось отменить часть выученного, а коду — продолжить движение в уже найденном направлении.
Общие способности сохранялись не одинаково на всех основах: SCALE лидировал на обоих вариантах Qwen2.5-Math и занял второе место на Qwen3-4B-Base. Улучшение целевой задачи не привело к единому выигрышу на каждом отдельном тесте сохранения знаний.
Для таблиц авторы перебрали 42 сочетания нижней и верхней границ и указали лучший диапазон для соответствующих тестов. Поэтому эти результаты показывают потенциал метода, но не качество автоматического выбора границ на новой задаче.
Когда SCALE стоит добавить в план разработки
Работа меняет план, если продукт уже использует LoRA для математики, генерации кода или другой задачи с узким и проверяемым распределением ответов. Вместо повторного SFT можно сохранить готовый адаптер и обучить поверх него небольшие регуляторы. На каждый целевой модуль добавляется только линейная проекция, тогда как базовая модель и матрицы LoRA не меняются.
Такой этап не заменяет очистку данных и взвешивание токенов. Эти методы влияют на то, чему научится адаптер, а SCALE управляет тем, как уже выученная разница применяется к конкретному входу. Их можно рассматривать как последовательные части одного конвейера.
Для внедрения диапазон коэффициентов нужно выбирать на отдельной проверочной выборке, а затем сравнивать с неизменённым LoRA по целевой метрике и сохранению общих способностей. Переносить лучшие границы из статьи напрямую нельзя: предпочтения менялись и между задачами, и между моделями.
Доказательства работы охватывают математические рассуждения и генерацию кода на семействе Qwen. Этого достаточно для пилота поверх существующего LoRA-конвейера, но не для замены текущего SFT во всех продуктах: открытые диалоги и задачи без надёжной проверки ответа требуют отдельного испытания связи между уверенностью и качеством.
Источники
- Rethinking Token Reweighting for SFT: Suppress, Reverse, and Extrapolate Learned Features, arXiv:2609.33463.
Иллюстрация: рисунок из статьи «Rethinking Token Reweighting for SFT: Suppress, Reverse, and Extrapolate Learned Features», Cunchun Li, Haonan He, Yifan Gao и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


