
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Трёхмерную турбулентность предсказали нейросетью, которой при обучении не нужно целиком обрабатывать поле высокого разрешения. Хотя препринт не рецензирован и числа получили сами авторы, на сетке 256³ модель снизила ошибку на 53%, а пиковый расход памяти — на 79%. Для команд, которые строят нейросетевые заменители физических симуляторов, это предлагает другой способ распределить модели, данные и GPU.
Крупное течение и локальные вихри предсказывают разные модели
Обычный нейросетевой заменитель получает всё трёхмерное поле и сразу предсказывает его следующее состояние. При росте разрешения ему приходится хранить промежуточные результаты для каждого узла сетки, поэтому обучение быстро упирается в память GPU. Разрезать поле на фрагменты недостаточно: маленькому фрагменту не хватает сведений о крупном течении вокруг него.
ScaleSplit-NO использует то, что структуры разных размеров ведут себя по-разному. Крупные вихри связаны на больших расстояниях, но меняются в пространстве плавно, поэтому их можно представить на грубой сетке. Мелкие структуры требуют полного разрешения, зато сильнее зависят от ближайшего окружения, чем от деталей в другой части области.
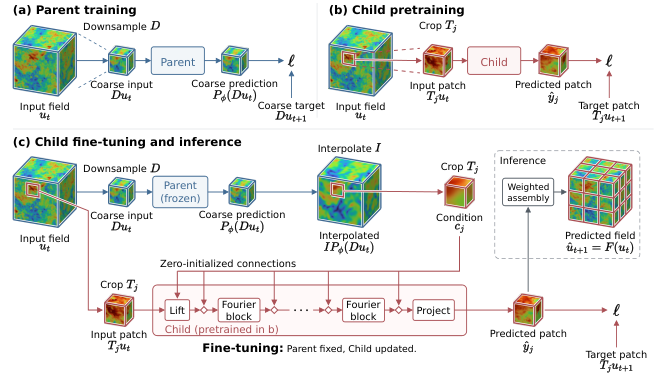
Архитектура состоит из двух нейронных операторов Фурье. Компонент Parent получает всё поле на грубой сетке и предсказывает его следующее состояние. Компонент Child берёт локальный фрагмент исходного поля в полном разрешении, добавляет предсказание Parent для того же участка и восстанавливает следующий локальный фрагмент целиком.
Child не обязан буквально дополнять грубый прогноз мелкими деталями. Он выдаёт полный фрагмент и может исправить ошибки Parent, которые возникают из-за взаимодействия крупных и мелких вихрей. Перекрывающиеся фрагменты собираются в единое поле с весами, которые уменьшают вклад границ: именно там локальная модель ошибается чаще.
Модели обучают раздельно. Сначала Child учится только на локальных фрагментах, затем к нему через нулевые начальные веса подключают прогноз Parent. На втором этапе Child получает не идеальное грубое поле из обучающих данных, а реальные предсказания замороженного Parent, поэтому условия обучения совпадают с последующим применением.
Экономия памяти не потребовала жертвовать точностью
На JHTDB256 нормированная среднеквадратичная ошибка оказалась на 53% ниже, чем у сильнейшей базовой модели. Пиковый расход памяти при обучении был на 79% ниже, чем у самого экономного конкурента. Эти два результата получены относительно разных соперников, поэтому их нельзя складывать в единое преимущество.
Метрика измеряет средний квадрат отклонения прогноза от правильного поля с поправкой на масштаб данных: меньшее значение означает более точный прогноз. ScaleSplit-NO сравнивали с U-Net, FNO, MG-TFNO, EddyFormer, P3D и ReViT как при ограниченном, так и при полном наборе обучающих данных.
На задаче прогноза городского ветра для реального района Монреаля ошибка одного шага снизилась на 65,8% относительно базовой модели. Отдельный эксперимент показал важную деталь обучения: если давать Child идеальное грубое поле вместо ошибочного прогноза Parent, итоговая ошибка вырастает на 75,2%. Более чистые обучающие данные здесь вредят, потому что при применении модель встречает другой вход.
Экономия появляется не только из-за меньших тензоров. Одно поле даёт Child множество локальных обучающих примеров, тогда как Parent получает один пример крупной динамики. Авторы могут отдельно подобрать размер моделей и длительность обучения под разный объём доступных данных.
Когда ScaleSplit-NO меняет план разработки
Подход стоит учитывать, если проект работает с турбулентностью на структурированной сетке, а обучение полноразмерной модели ограничивает память GPU или число дорогих симуляций. Вместо одной сквозной модели потребуется конвейер для двух разрешений, нарезки фрагментов и их обратной сборки. Усложнение оправдано тем, что ни один компонент не хранит промежуточные результаты для всего поля в полном разрешении.
Раздельное обучение также меняет план хранения данных. Грубые поля занимали 5,3% объёма исходных полей на MHD64 и 1,6% на JHTDB256. Parent можно дообучить на дополнительных грубых полях, затем заменить его без повторного обучения Child — это позволяет улучшать глобальную динамику, не сохраняя столько же новых данных в полном разрешении.
Утверждение о независимости памяти от разрешения действует при фиксированных размерах фрагмента, грубой сетки и пакета. Оно относится к пиковой памяти отдельного этапа обучения, а не к полной стоимости применения: чем больше фрагментов и их перекрытие, тем дольше собирается поле.
Метод проверяли на двух наборах трёхмерной турбулентности и на городском ветре, включая прогноз следующего состояния и последовательный прогноз на несколько шагов. Все задачи использовали структурированные сетки. Для неструктурированных сеток выбранный оператор Фурье напрямую не подходит, поэтому перенос потребует другого основания модели, а не только новой схемы разбиения.
Источники
Иллюстрация: рисунок из статьи «Scale-Split Neural Operator for Memory- and Data-Efficient 3D Turbulence Prediction», Shaoxiang Qin, Yucheng Zhao, Zongyi Li и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


