
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Базовые модели Qwen3 научили реже цепляться за случайные детали формулировки, когда решают математические задачи. В работе, которая не рецензирована и содержит замеры самих авторов, метод SCAPO обошёл GRPO на AIME 2024–2026 на 5,63 процентного пункта для Qwen3-4B-Base и на 4,17 пункта для Qwen3-1.7B-Base. Команды, которые обучают рассуждающие модели через проверяемый итоговый ответ, могут точнее распределять обучающий сигнал без отдельной модели оценки процесса.
Почему правильный ответ не делает каждый токен полезным
GRPO обучает модель по группам ответов на одну задачу. Каждый ответ получает проверяемую награду: например, совпало ли итоговое число с эталоном. Затем метод сравнивает награды внутри группы и назначает всем токенам одного ответа одинаковую поправку.
Такой подход не различает полезное рассуждение и случайную зависимость от формы запроса. Если ответ оказался правильным, GRPO повышает вероятность всей последовательности, включая шаги, которые изменились бы из-за опечатки, перефразирования или постороннего контекста.
Чтобы найти такие места, исходную задачу заменяют смыслосохраняющими вариантами. Они меняют формулировку, добавляют небольшую опечатку, оборачивают условие в посторонний сценарий или дописывают нерелевантный текст, но сохраняют математическую задачу и правильный ответ.
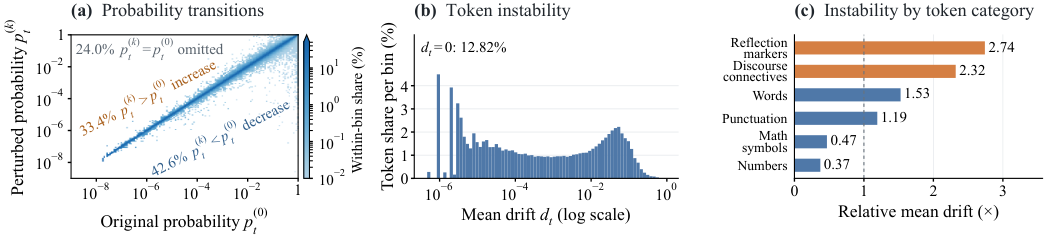
Модель не генерирует решение заново для каждого варианта. SCAPO берёт уже полученный ответ, подаёт его модели вместе с изменёнными запросами и на каждом шаге измеряет, как сдвинулась вероятность фактически выбранного токена. Большой сдвиг означает, что этот шаг сильнее зависит от детали, которая не должна влиять на решение.
Как SCAPO уменьшает вес нестабильных шагов
Сдвиги вероятностей нормализуют относительно остальных токенов в группе ответов. Поэтому метод оценивает не абсолютную уверенность модели, а относительную устойчивость конкретного шага при неизменном содержании задачи.
SCAPO использует только отрицательную часть сигнала. Относительно нестабильный токен получает меньшую положительную поправку, если ответ верен, или более сильную отрицательную, если ответ неверен. Устойчивый токен не получает дополнительной награды: одинаковая реакция на несколько формулировок ещё не доказывает правильность рассуждения.
Поправку добавляют к обычному сигналу GRPO и не проводят через неё градиент. Расчёт соотношений вероятностей, ограничение размера обновления и остальная функция обучения остаются прежними. SCAPO действует только в начале обучения, после чего модель продолжает оптимизироваться обычным GRPO.
Такая конструкция отличает SCAPO от методов, которые маскируют фрагменты рассуждения или заново генерируют продолжения. Здесь один и тот же ответ проверяют под несколькими запросами в режиме заданной последовательности, поэтому не требуется отдельная модель награды или разметка промежуточных шагов.
Когда результат меняет план обучения
Сначала сигнал проверили без обновления весов. У замороженной Qwen3-4B-Base подавление кандидатов с большим сдвигом подняло точность на диагностической математической выборке с 15,8% до 30,0%. Это показывает, что измерение влияет не только на внутренние вероятности, но и на выбор правильного ответа.
После обучения SCAPO показал лучший результат среди сопоставленных методов на большинстве математических проверок и на всех проверках задач с формой, отличной от обучающей. На GPQA-Diamond точность модели большего размера выросла относительно GRPO с 36,26% до 42,45%, то есть перенос затронул и научные вопросы за пределами математического обучающего набора. Итоговой точности GRPO на AIME метод достиг менее чем за половину его шагов оптимизации.
Дополнительное измерение устойчивости заняло 1,8% времени обучения в эксперименте с моделью большего размера. Ответы не генерируют повторно, а проверку проводят только на раннем этапе, поэтому основную стоимость по-прежнему создаёт последовательная генерация решений.
Для команды с работающим контуром GRPO изменение локально: нужно подготовить варианты запросов, выполнить дополнительные проходы с фиксированными ответами и заменить общий сигнал ответа на поправки по токенам. Самая чувствительная часть — качество смыслосохраняющих вариантов. Если вариант меняет задачу, сдвиг вероятности становится нормальной реакцией модели, а не признаком ложной зависимости; соответствующий вариант эксперимента работал хуже SCAPO.
Проверка охватывает Qwen3-4B-Base и Qwen3-1.7B-Base, обучение на соревновательной математике и перенос на изменённые математические условия и GPQA-Diamond. Поэтому работа даёт практический план для небольших открытых моделей с проверяемой наградой, но не устанавливает тот же эффект для крупных моделей, диалоговых продуктов и задач без однозначно проверяемого ответа.
Источники
Иллюстрация: рисунок из статьи «Semifactual Credit-Augmented Policy Optimization», Junshu Pan, Zhizhang Fu, Shulin Huang и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


