
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Большой граф с атрибутами удалось сгенерировать по частям, не собирая в памяти таблицу всех возможных связей. Хотя работа Norwegian University of Science and Technology не рецензирована и числа получили сами авторы, метод Schema обработал граф с 10 миллионами узлов на одном GPU. Такой подход снимает одно из препятствий для команд, которым нужны синтетические социальные, платёжные или рекомендательные сети.
Мягкое членство сохраняет границы сообществ
Schema рассчитан на случай, когда для обучения доступен один большой исходный граф, а не набор независимых примеров. Каждый его узел несёт атрибуты: например, свойства пользователя, товара или транзакции. Модель должна создать новые связи и атрибуты, сохранив общую структуру, но не скопировав исходные рёбра.
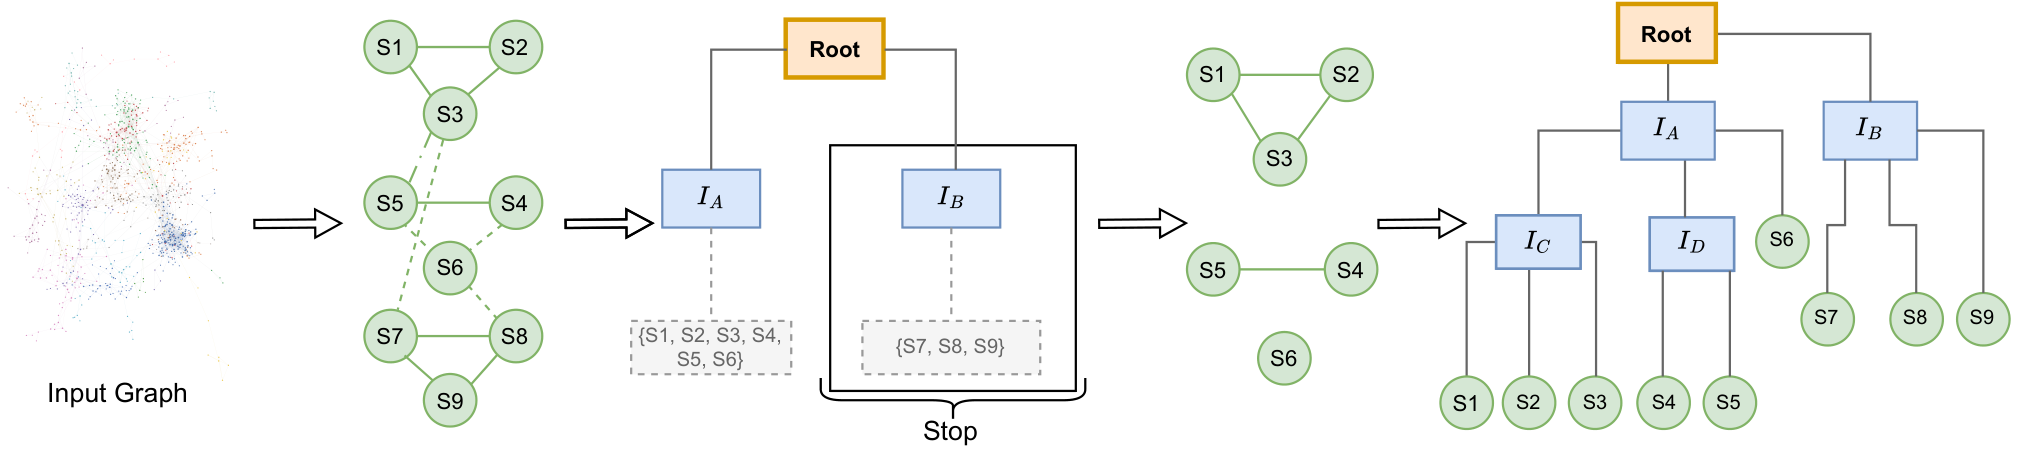
Сначала алгоритм Leiden делит граф на плотные локальные сообщества. Затем Schema сворачивает их в более крупные группы и повторяет деление, пока не построит дерево: внизу находятся небольшие сообщества, выше — объединяющие их части графа.
Жёсткое деление потеряло бы узлы на границах. Пользователь может одинаково тесно взаимодействовать с коллегами и участниками профессионального сообщества, а товар — входить сразу в несколько характерных групп покупок. Поэтому Schema хранит для узла не одну метку, а распределение принадлежности между соседними сообществами.
Это распределение получают распространением меток вдоль существующих рёбер. Операция проходит по списку связей и не создаёт полную матрицу смежности, размер которой рос бы квадратично вместе с числом узлов. Обучать отдельную модель для разбиения не требуется.
Узлы с заметной принадлежностью к нескольким группам становятся мостами. Через них Schema позднее проводит связи между сообществами. Так локальные плотные участки и редкие дальние связи не приходится описывать одним генератором с едиными параметрами.
Три генератора решают задачи разного масштаба
После разбиения Schema отдельно создаёт атрибуты узлов, связи внутри сообществ и связи между ними. Все этапы используют одно распределение принадлежности, поэтому свойства узлов остаются связаны со структурой графа. На этапе генерации система один раз обходит дерево и объединяет результаты.
Генератор внутренних рёбер видит только локальное сообщество. Генератор внешних рёбер рассматривает ограниченный набор узлов-мостов и учитывает, насколько сильно соответствующие сообщества были связаны в исходном графе. Ни одному этапу не нужен весь граф одновременно, а расход памяти GPU зависит прежде всего от крупнейшего листа дерева.
Метод проверили на четырёх реальных графах с атрибутами и сравнили с девятью базовыми подходами. Schema точнее других генераторов атрибутов воспроизвёл сочетание локальной и дальней структуры, при этом скопировал лишь малую долю исходных рёбер. Подходы с сопоставимой структурой чаще запоминали исходный граф.
Полезность измеряли через классификацию узлов: классификатор обучали на синтетическом графе и проверяли на исходном. Schema сохранил 77–86% исходной точности и не сделал задачу искусственно проще. У GraphMaker точность местами приближалась к исходной или превосходила её, но классификация на созданном графе оказывалась легче; на одном из крупных наборов метод не завершил работу.
Масштабирование дополнительно проверили на шести графах. Самый крупный потребовал ограничить размер листового сообщества 100 тысячами узлов, из-за чего конфигурация отличалась от остальных запусков. Это показывает, что иерархия переносит предел памяти с полного графа на крупнейшую локальную часть, но не устраняет его полностью.
Архитектуру генератора можно менять, критерии приёмки — нет
Работа даёт практический шаблон для систем, которые строят синтетические данные по одной большой сети. Вместо единой модели можно выделить разбиение, локальные связи, дальние связи и атрибуты в независимые этапы. Их проще обучать и профилировать отдельно, а максимальный размер сообщества становится явным параметром инфраструктуры.
Текущая постановка сохраняет набор узлов и их идентичности из исходного графа. Она подходит для генерации новых связей и атрибутов вокруг известных сущностей, но не заменяет метод, который должен создавать полностью новые сущности. Низкое совпадение рёбер также измеряет запоминание, а не доказывает приватность данных.
Есть и структурный компромисс. Оба генератора рёбер оценивают пары независимо и не учитывают уже созданные связи. При низком совпадении с оригиналом графы содержат меньше треугольников, поэтому для задач, где замкнутые группы определяют результат, потребуется отдельная проверка.
Schema пока проверяли на статических однородных графах. Для платёжных потоков с временными событиями или сетей с разными типами узлов сам принцип иерархии остаётся применимым, но заявленные результаты на такие данные не переносятся. Планировать внедрение разумно как эксперимент с собственными метриками структуры, запоминания и качества целевой модели, а не как замену исходного графа без повторной валидации.
Источники
Иллюстрация: рисунок из статьи «Scalable Hierarchical Graph Generation via Soft Community Structure», Ahmet T\"uzen, Helge Langseth, Kjetil N{\o}rv{\aa}g, CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


