
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Система для поиска научных уравнений научилась исправлять два разных источника ошибок: нехватку вычислительных инструментов и неправильный выбор уже доступных операций. В препринте Pengze Li и соавторов, который не прошёл рецензирование, а все числа получили сами авторы, полная система решила 79,1% задач LSR-Synth при допустимой относительной ошибке 10−2. Для команд, которые строят агентов с проверяемым результатом, работа предлагает менять не только модель, но и исполняемую среду вокруг неё.
Одна ошибка развивает две части системы
Задача относится к символьной регрессии: система получает таблицу наблюдений и должна восстановить компактное уравнение, которое описывает данные и работает на новых значениях. Модель предлагает формулы, вызывает численные процедуры для анализа данных и подгоняет неизвестные коэффициенты.
Такой агент ломается по двум причинам. В библиотеке может не оказаться операции для нужного семейства функций. Либо подходящая операция есть, но модель пропускает её, передаёт неверные аргументы или неправильно трактует результат.
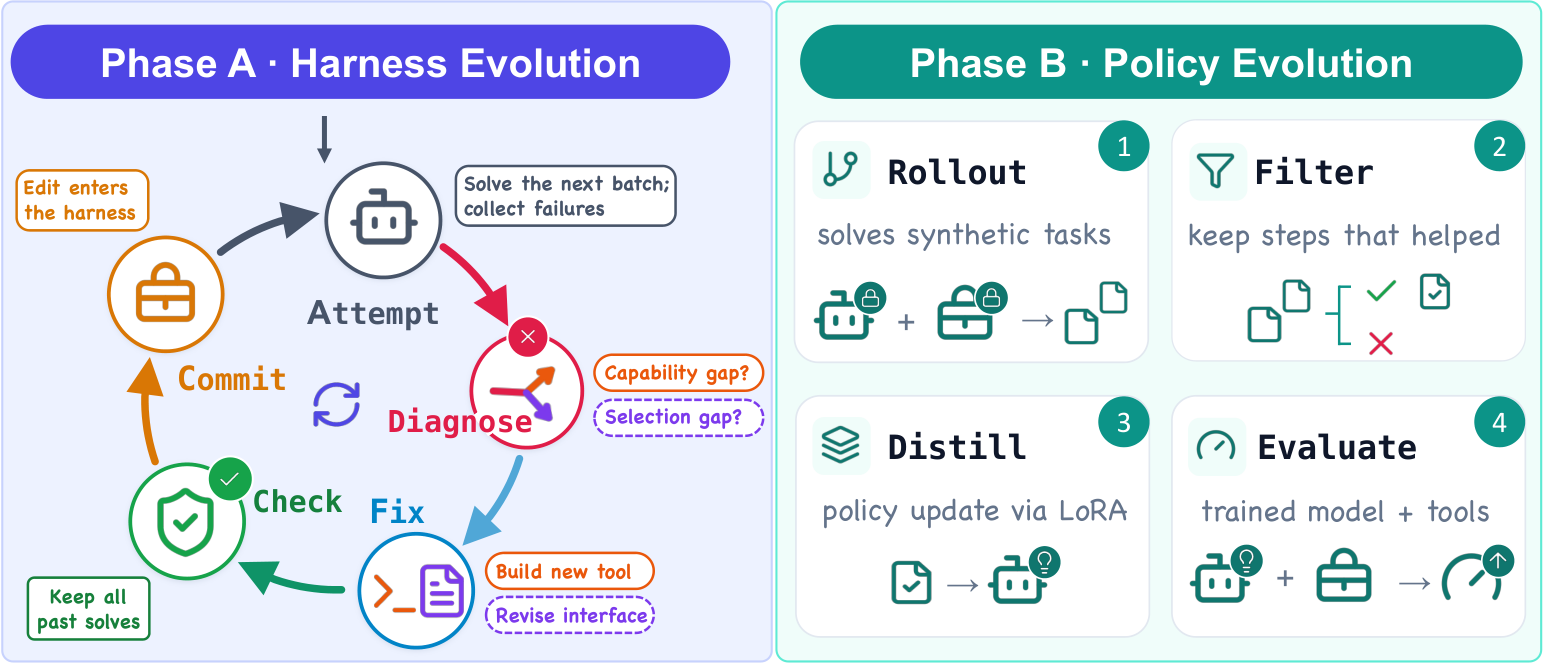
Авторы разделили улучшение системы на две фазы. Сначала веса модели остаются неизменными, а агент развивает вычислительную обвязку. После неудачной попытки отдельная модель определяет причину сбоя: при нехватке возможности она пишет или исправляет инструмент на Python, а при ошибке выбора меняет описание инструментов либо правило отбора итоговой формулы.
Новую операцию принимают только после проверки на отдельных данных. Затем систему повторно запускают на всех ранее решённых задачах: если хотя бы одна перестала решаться, изменение отклоняют. Так библиотека выросла с 25 базовых операций до 33 инструментов для диагностики, поиска и проверки формул.
Во второй фазе библиотеку замораживают и обучают Qwen3.6-35B-A3B примерно с 3 млрд активных параметров. Учебными примерами служат успешные последовательности действий GPT-5.5: сохраняются шаги, которые улучшили формулу, снизили ошибку или исправили некорректный вызов инструмента.
Обе фазы используют один сигнал — ошибку формулы на наблюдениях. Во время поиска агент видит только данные для подгонки; отдельная часть данных выбирает итогового кандидата, а закрытая тестовая часть доступна лишь внешней проверке. Синтетические учебные формулы дополнительно отсекали, если они совпадали с формулами проверочных наборов символически, после замены параметров или по значениям на контрольных точках.
Инструменты дали основной прирост, обучение добавило устойчивости
Без библиотеки инструментов та же базовая Qwen не решила ни одной задачи LSR-Synth. Простое последовательное применение исходной библиотеки дало точность 41,1%, а после развития инструментов — 61,2%. Значит, основную новую способность обеспечили исполняемые операции, а не знания внутри модели.
Обучение политики помогло модели лучше распоряжаться готовой библиотекой. Необученный контроллер получил 54,3%, обученный — 63,6% до дополнительного отбора итоговой формулы. Наиболее заметным прирост оказался на сложных задачах, где мало вызвать подходящий инструмент: нужно выбрать порядок операций и использовать промежуточные результаты.
Проверка охватывала LSR-Synth, LSRT111, панели SRSD и набор космологических задач CP3-28. Библиотеку и контроллер переносили между наборами без дальнейшего изменения, а формулы SRSD-Feynman и CP3-28 не участвовали ни в развитии инструментов, ни в сборе учебных последовательностей. Это проверяет перенос на другие семейства уравнений, хотя выводы пока относятся именно к поиску формул по числовым наблюдениям.
Когда этот рецепт меняет архитектуру агента
Работа предлагает полезное разделение ответственности. Если результат можно автоматически проверить, не каждую неудачу стоит исправлять новым запросом к модели или дополнительным обучением. Сначала нужно определить, отсутствует ли нужная исполняемая возможность или модель лишь неправильно использует существующую.
Для разработки это означает, что библиотека инструментов становится обучаемой частью продукта. Команде потребуется хранить происхождение операций, проверять сгенерированный код на отдельных примерах и повторно прогонять старые задачи после каждого изменения. Иначе автоматическое расширение библиотеки может незаметно сломать уже работающие сценарии.
Подход лучше всего переносится на процессы с однозначным машинным критерием: ошибкой расчёта, прохождением тестов или совпадением с формальной спецификацией. Если качество оценивают люди либо цель допускает несколько несопоставимых ответов, разделить нехватку инструмента и ошибку политики будет труднее.
Менять базовую модель ради этой работы не требуется. Более практичный шаг — начать записывать неудачные последовательности вызовов, классифицировать их по причине и отделить развитие инструментов от обучения контроллера. Препринт показывает, что такая обвязка может дать больший прирост, чем дообучение модели на неизменном наборе операций.
Источники
Иллюстрация: рисунок из статьи «Coupled Harness--Model Evolution for Scientific Equation Discovery», Pengze Li, Jiaquan Zhang, Encheng Su и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


