
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Координацию нескольких агентов научились улучшать уже во время выполнения задачи, не переобучая политику. В препринте The University of Texas at Austin, который не прошёл рецензирование и приводит замеры самих авторов, SCOUT показал лучший средний результат на двух испытательных наборах. Команда может вынести часть настройки из обучения в запуск и менять объём вычислений под конкретную среду.
Почему оптимизация ценности разрушает координацию
SCOUT решает задачу обучения нескольких агентов с подкреплением по готовому набору данных. Такой режим нужен, когда собирать новые взаимодействия дорого или рискованно: например, в робототехнике, логистике и автономном управлении.
В данных могут встречаться разные рабочие стратегии. Один набор агентов обходит препятствие слева, другой — справа; оба варианта дают хороший результат, пока участники выбирают согласованное направление. Генеративная модель поведения способна сохранить несколько таких вариантов.
Проблема возникает, когда политику во время обучения напрямую настраивают по функции ценности Q — модели, которая оценивает ожидаемую пользу действия. Каждый агент начинает предпочитать один локально выгодный вариант. Их политики могут схлопнуться к разным стратегиям и вместе образовать комбинацию действий, которой не было в исходных данных.
Обычная защита удерживает новую политику рядом с поведением из набора данных. Для этого выбирают постоянный коэффициент регуляризации: большой мешает уйти от слабых примеров, а маленький позволяет функции ценности направить агентов в плохо изученную область. В совместной политике отклонения отдельных агентов ещё и складываются.
Как SCOUT разделяет поведение и выбор действий
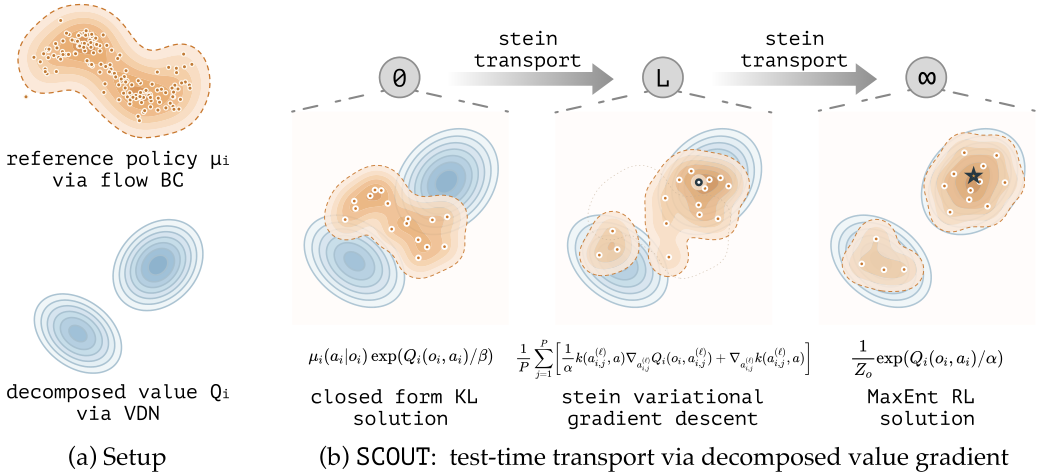
SCOUT не встраивает максимизацию ценности в генеративную политику. Сначала он независимо обучает две части: модель поведения методом согласования потоков и разложенную функцию ценности. Первая воспроизводит доступные агенту варианты действий, вторая оценивает их полезность.
Во время выполнения каждый агент получает несколько кандидатов из модели поведения. Затем SCOUT сдвигает эти кандидаты по градиенту функции ценности. Вариационный градиентный спуск Штейна одновременно притягивает их к более полезным областям и отталкивает друг от друга, поэтому все кандидаты не сходятся к одному действию.
Число шагов уточнения становится регулятором. Без них система только выбирает среди образцов модели поведения; дополнительные шаги сильнее ориентируют действия на функцию ценности. Менять этот бюджет можно при запуске без повторного обучения генеративной модели.
Агенты выполняют уточнение независимо, используя локальные наблюдения и свои части функции ценности. Согласованность опирается на аддитивное разложение: если локальные оценки правильно отражают общий результат, максимум каждого агента совпадает с максимумом всей команды. Теоретическая граница ухудшается пропорционально той части взаимодействия, которую такое разложение не описывает.
В дискретной среде SCOUT сдвигает оценки действий до преобразования в вероятности, а в непрерывной — сами кандидаты действий. Подход проверяли на семи сценариях и 24 наборах офлайн-данных из SMACv1 и MA-MuJoCo: первый моделирует управление отрядом в StarCraft II, второй делит суставы одного робота между агентами.
Когда SCOUT меняет архитектурный план
На SMACv1 средняя награда SCOUT составила 16,1 против 14,9 у ближайшего сравнимого метода MAC-Flow. На MA-MuJoCo нормализованная оценка достигла 82,12 против 76,37. Это средние результаты: в отдельных конфигурациях SCOUT уступал другим методам.
При переходе от готового набора данных к дополнительному взаимодействию со средой SCOUT обошёл MAC-Flow во всех четырёх проверенных сценариях. Генеративная модель при этом остаётся исходной точкой, а новые сведения меняют функцию ценности и направление уточнения, а не заставляют восстанавливать ранее отброшенные стратегии.
Работа меняет планы команды, если продукт уже строится вокруг генеративной политики и функции ценности, а нагрузка позволяет уточнять действия при каждом запуске. Вместо подбора одного коэффициента на этапе обучения придётся выделить бюджет на несколько кандидатов и шагов градиента, а затем подобрать его на проверочном наборе для каждой среды.
Это не устраняет настройку: подход переносит её ближе к эксплуатации. Лучшее число шагов зависело от задачи и качества данных, а автоматического критерия остановки в работе нет. Статья также не сравнивает итоговую задержку методов, поэтому для управления с жёстким пределом времени потребуются собственные замеры.
Источники
Иллюстрация: рисунок из статьи «Test-time Multi-agent Coordination by Decomposed Value Gradient Flow», Dongsu Lee, Haoran Xu, Amy Zhang, CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


