
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Одну и ту же LLM научили быстро предлагать сразу несколько следующих фрагментов текста и затем проверять их, не подключая отдельную черновую модель. В препринте Purdue University, который не прошёл рецензирование и приводит числа, полученные самими авторами, метод SEED ускорил генерацию до 2,7 раза. Для команды это вариант сократить задержку внутри собственной модели без отдельного генератора кандидатов, но с дополнительным обучением и изменением контура выполнения.
Первые слои считают контекст, последние выпускают токены
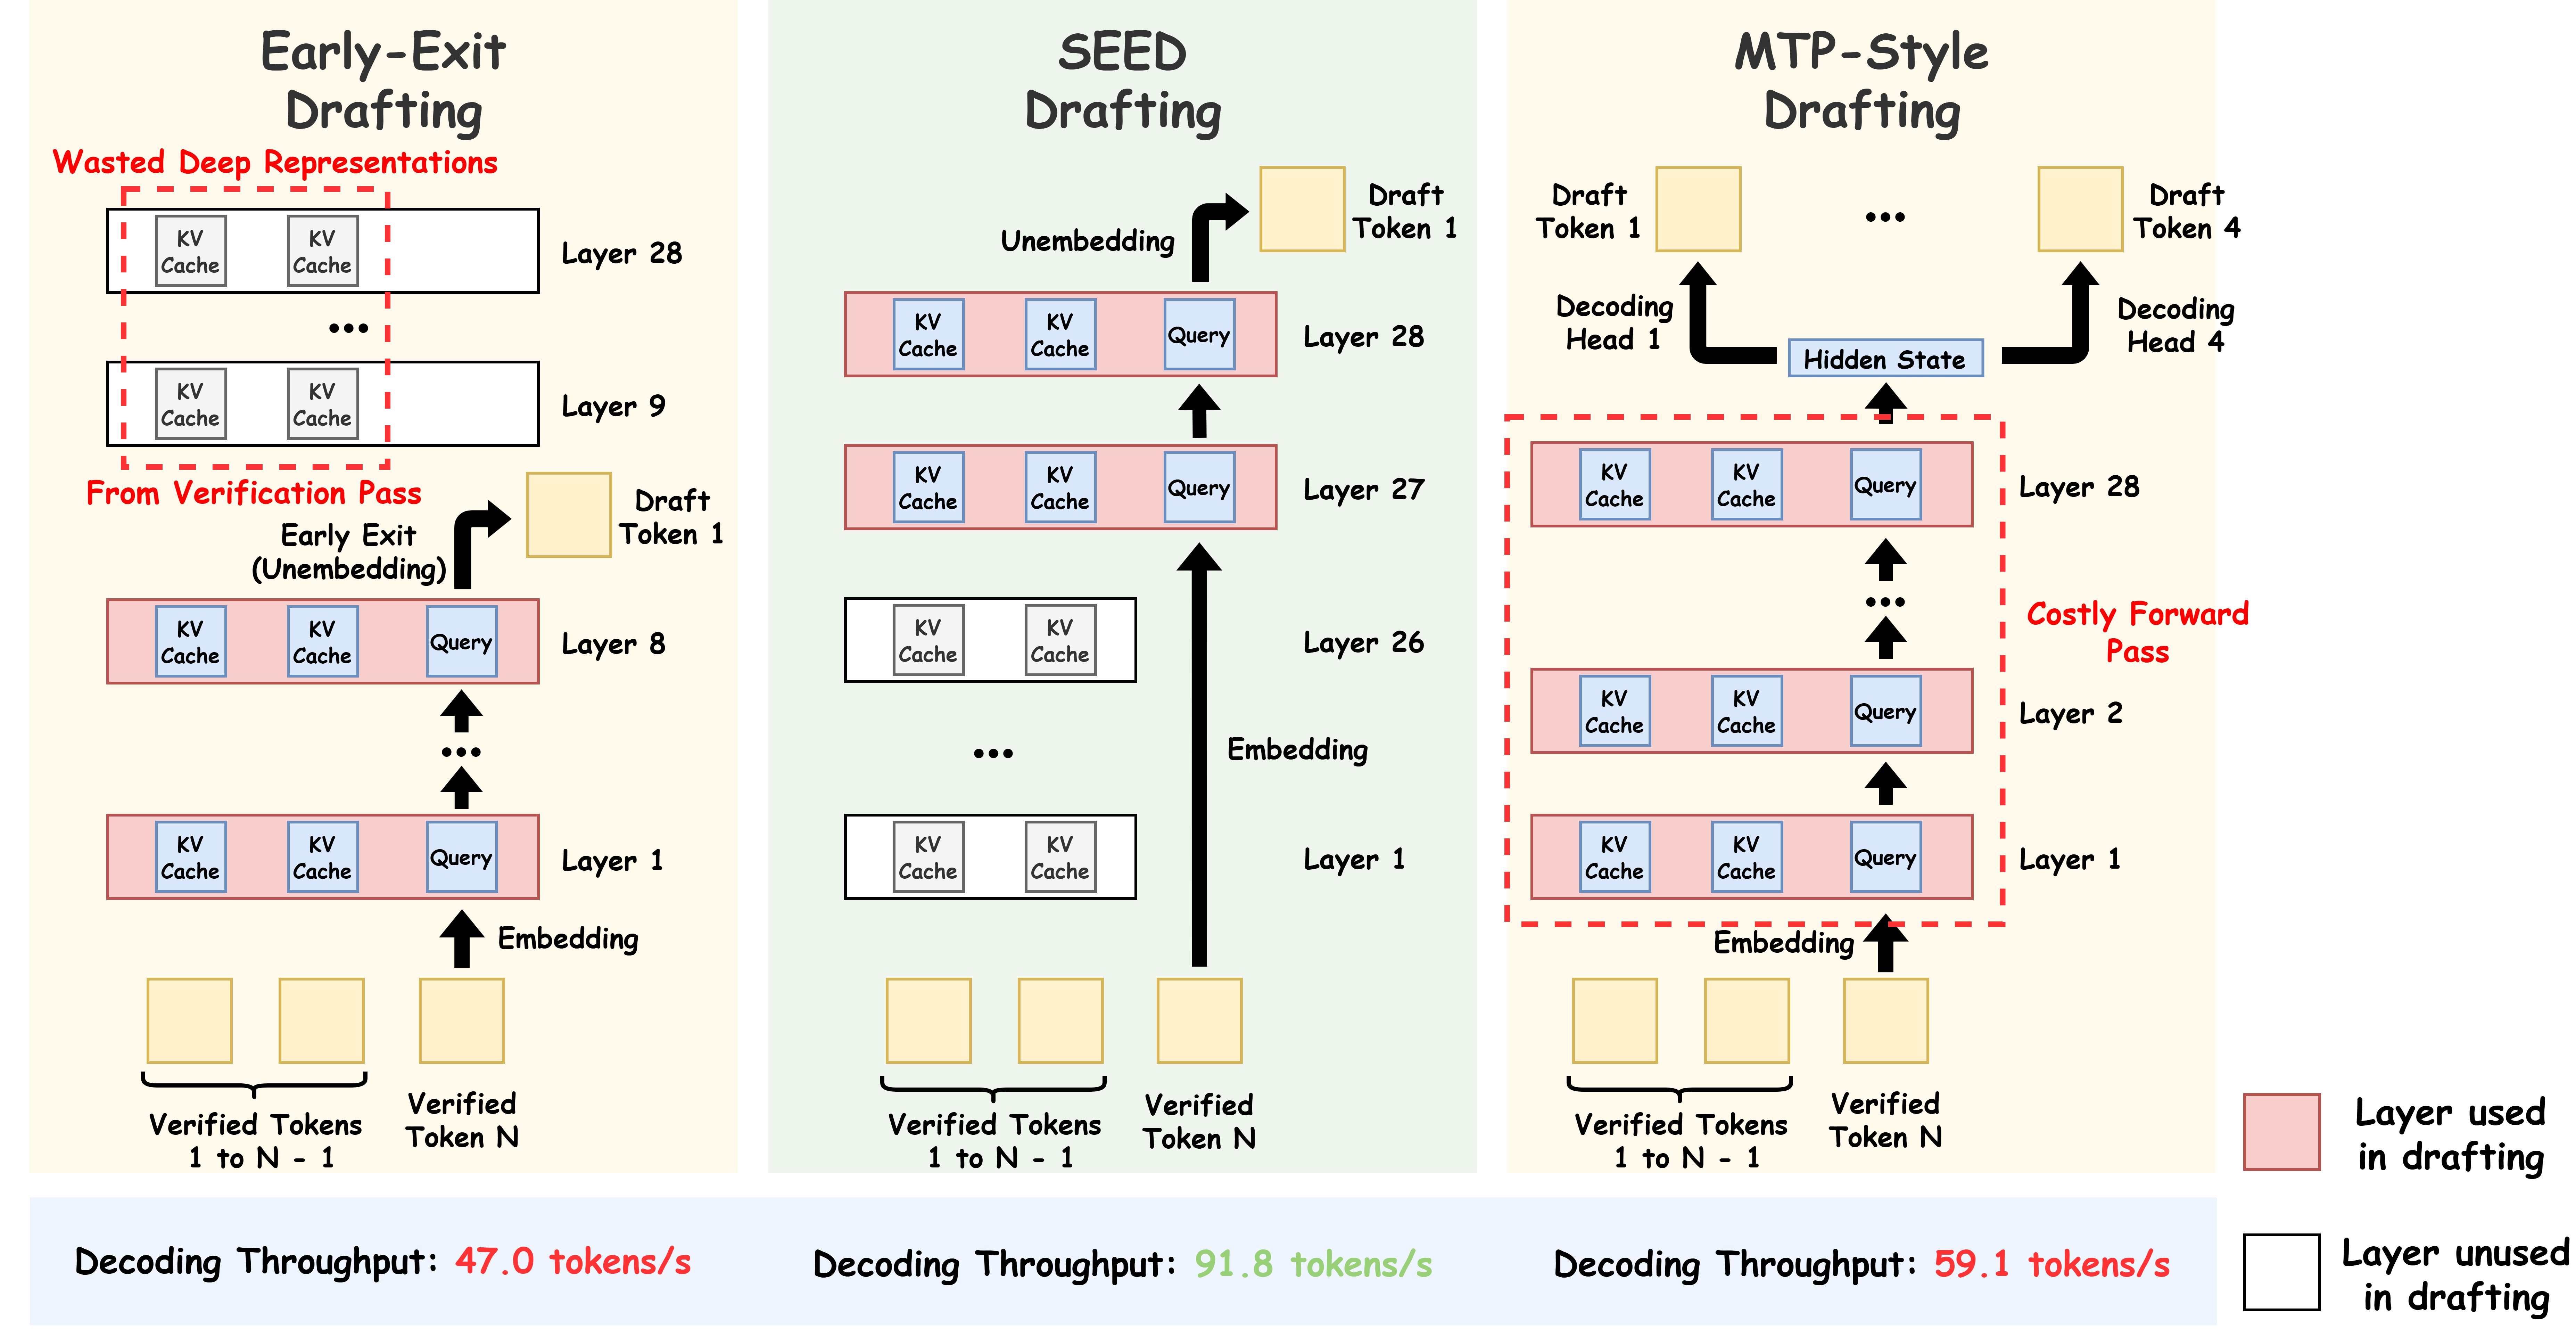
Обычная decoder-only модель проводит каждый новый токен через все слои. SEED предлагает смотреть на ту же архитектуру как на неявную пару из кодировщика и декодировщика: основная часть слоёв строит представление контекста, а короткий хвост превращает его в следующий токен.
В основном варианте модели из 28 слоёв первые 26 работают как кодировщик, а два последних — как лёгкий декодировщик. Физически отдельного кодировщика не появляется: разделение задаёт режим работы уже существующих слоёв.
Экономия возникает после проверки черновых токенов. Полная модель обрабатывает их параллельно и сохраняет в кэше ключей и значений глубокие представления подтверждённого префикса. На следующем цикле эти данные уже не нужно пересчитывать.
Декодировщик получает исходное векторное представление последнего токена и обращается к сохранённому контексту. Затем он авторегрессионно предлагает несколько продолжений, учитывая предыдущие черновики, но не запускает тяжёлую начальную часть модели. Полный проход возвращается только при следующей проверке, которая одновременно принимает подходящие токены и обновляет кэш.
Авторы называют такое обращение перекрёстным вниманием, но отдельного модуля в архитектуру не добавляют. Последние слои используют обычный механизм внимания: запрос приходит от нового токена, а ключи и значения — из глубокого представления уже проверенного текста.
Дополнительная цель учит короткий декодировщик работать самостоятельно
Простого разделения слоёв недостаточно. Последние слои исходной модели привыкли получать результат всей предыдущей цепочки, а при черновой генерации SEED передаёт им исходные представления новых токенов и кэш старого контекста.
Поэтому обучение сочетает обычное предсказание следующего токена со второй целью — подготовкой черновиков. Первая сохраняет поведение полной модели как проверяющего компонента. Вторая учит последние слои продолжать последовательность без повторного запуска кодировщика.
Обучающие последовательности делят на блоки. Внутри блока декодировщик видит исходные представления токенов и может смотреть только назад, а контекст предыдущих блоков получает из глубокого кэша. Так обучение воспроизводит ситуацию между двумя проверками, когда лёгкая часть должна выпустить несколько токенов самостоятельно.
На каждом шаге обучения сначала работает полная модель, затем отдельно запускается декодировщик с блочной маской внимания. Архитектура и число параметров не меняются, но SEED нельзя включить одной настройкой на этапе генерации: модели требуется дообучение, а среде выполнения — отдельные режимы для черновика и проверки.
Где ускорение меняет план разработки
На моделях примерно с 4 млрд параметров SEED ускорил декодирование до 2,7 раза и работал на 28% быстрее EAGLE-3. На GSM8K его пропускная способность оказалась примерно вдвое выше, чем у LayerSkip, и в 1,6 раза выше, чем у Apple MTP. При этом качество полной авторегрессионной генерации сохранилось или выросло на отдельных задачах.
Сравнение охватило математику, программирование, общие знания и суммаризацию. SEED сопоставляли с ранним выходом из модели, многотокенным предсказанием и EAGLE-3; дополнительные опыты проверяли размер декодировщика, длину обучающих блоков, динамическое завершение черновика и проверку дерева кандидатов. Работа измеряет пропускную способность декодирования на моделях исследованного масштаба, поэтому перед внедрением результат придётся повторить на целевом оборудовании и реальных длинах запросов.
SEED меняет план, если команда контролирует веса, дообучение и сервер генерации, а основное ограничение продукта связано со скоростью выпуска токенов. В таком случае метод убирает отдельную черновую модель и повторно использует вычисления, которые проверяющий проход всё равно уже выполнил.
При работе с закрытой моделью через внешний API подход напрямую неприменим: он требует доступа к промежуточному кэшу, разделения слоёв и собственной процедуры обучения. Для самостоятельного развёртывания решение тоже добавляет инженерную работу — блочные маски внимания, черновой цикл и параллельную проверку кандидатов должны поддерживаться используемым сервером.
Источники
Иллюстрация: рисунок из статьи «SEED: Self-Speculative Decoding via Implicit Encoder-Decoder», Hankun Lin, Patrick Pynadath, Ruqi Zhang, CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


