
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Систему присвоения кодов ICD-10 научили отправлять в большую языковую модель только неоднозначные диагнозы, а остальные разбирать обычными классификаторами. В нерецензированном препринте, где числа получили сами авторы, итоговая схема оказалась точнее прямого запроса к GPT-5.6-Sol и обращалась к LLM лишь примерно в трети случаев. Для продуктовой команды это меняет базовую архитектуру: LLM можно ставить не вместо специализированной модели, а после неё как обработчик исключений.
Сначала система сокращает пространство поиска
На вход поступает короткая формулировка диагноза на русском языке. Такая запись может содержать сокращения, опечатки и местные обозначения, а классы распределены неравномерно: частые заболевания представлены лучше редких.
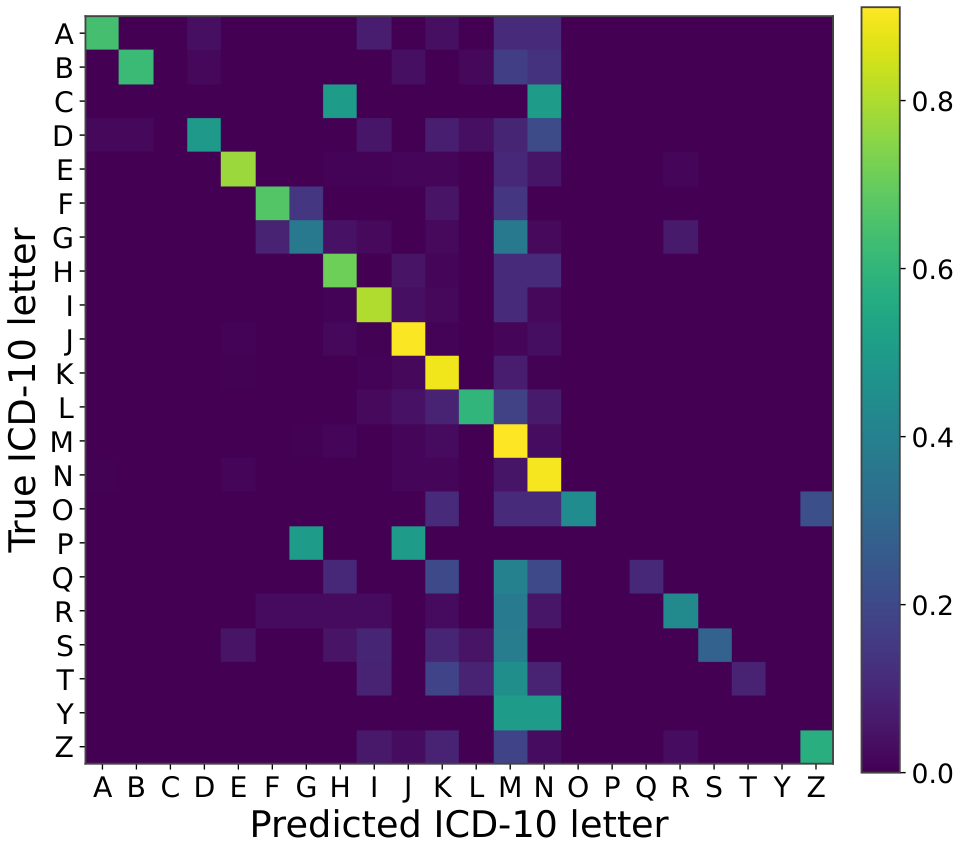
Система решает задачу в два этапа. Сначала Random Forest определяет первую букву кода — широкую группу заболеваний. Затем отдельный HistGradientBoosting для этой группы выбирает трёхсимвольный родительский код, например J02 или M54.
Признаки строят с помощью ModernBERT. Модель сравнивает диагноз с характерными описаниями из справочника ICD-10, после чего классификаторы формируют список из десяти наиболее вероятных кодов. Это не окончательный ответ, а ограниченное пространство, внутри которого можно безопаснее использовать LLM.
Для сомнительных записей Qwen3.5-122B-A10B получает диагноз и список кандидатов, а затем выбирает один из них. Модель не может свободно придумать новый код: если правильного варианта нет в списке, повторная расстановка кандидатов уже не исправит ошибку.
Перед вызовом LLM работает шлюз — отдельная модель, которая оценивает, принесёт ли такой вызов пользу. Параллельно действует более дешёвый ранжировщик без LLM. Финальный модуль объединяет ответ выбранного пути с исходными оценками классификаторов.
Точность выросла при вызове LLM для трети диагнозов
Базовый классификатор правильно выбирал родительский код в 74,32% случаев. При этом нужный код попадал в первую десятку кандидатов в 93,05% случаев. Разрыв между этими показателями объясняет, почему повторная расстановка уже найденных вариантов работает: системе чаще не нужно искать новый код, достаточно поднять правильный.
Итоговая схема Pre-LLM fusion достигла 83,19% точности и вызвала LLM для 31,97% диагнозов. Прямой запрос к GPT-5.6-Sol для каждой записи дал 81,01%. Значит, выборочные обращения не только сократили нагрузку на большую модель, но и обошли режим, где она кодирует диагноз без списка кандидатов.
Проверка разделяла подбор моделей и итоговую оценку. Порог шлюза и остальные параметры выбирали по прогнозам перекрёстной проверки, а финальный результат считали на закрытой тестовой части, которую до этого не использовали. Группы записей из одного исходного файла не пересекались между обучением и тестом.
Эксперимент охватил 8552 обучающие записи и 1511 тестовых. Проверяли короткие русскоязычные диагнозы и выбор трёхсимвольного кода, поэтому результат нельзя напрямую переносить на длинные выписки, другие языки или назначение сразу нескольких кодов.
Командам нужен шлюз, а не замена всей системы на LLM
Работа даёт практический шаблон для сервисов, где большая модель вызывается для каждой записи. Сначала специализированная модель должна вернуть небольшой список с высокой полнотой, затем отдельный шлюз направляет в LLM только случаи, где повторный выбор способен изменить ответ.
Ключевой показатель для такой архитектуры — не только точность первого кандидата, но и доля записей, где правильный ответ вообще присутствует в списке. Если полнота списка низкая, смена LLM или доработка запроса мало поможет: модель останется ограничена неверными вариантами.
Шлюз также нельзя настраивать по обычной уверенности классификатора без отдельной проверки. В эксперименте уверенность в среднем отделяла правильные ответы от ошибочных, но не соответствовала точной вероятности ошибки во всех диапазонах. Для внедрения понадобится собственная разметка, на которой команда проверит, когда вызов LLM действительно улучшает результат.
Исследование измеряет число обращений, а не денежную стоимость обработки. Экономический эффект поэтому нужно пересчитать для выбранного API, длины запросов и инфраструктуры. Однако архитектурный вывод от цены конкретной модели не зависит: локальные классификаторы закрывают типовые записи, а LLM получает ограниченный список и работает только с трудными случаями.
Источники
Иллюстрация: рисунок из статьи «Call-Efficient ICD-10 Code Prediction via Supervised Candidate Generation and Selective LLM Invocation», Ilia Kopanichuk, Daniil Kartashev, Yuri Bolkonsky и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


