
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Кодовый агент научился улучшать и своё поведение, и среду исполнения на собственных ошибках. В препринте Microsoft Research, University of Virginia и Carnegie Mellon University, который не прошёл рецензирование и содержит замеры самих авторов, средняя доля решённых задач выросла на 7 процентных пунктов. Для команд это превращает промпт, работу с инструментами и обучение модели из независимых настроек в общий контур улучшения.
Обвязка меняется вслед за ошибками модели
Кодовый агент состоит не только из LLM. Его обвязка (harness) определяет, какой контекст видит модель, как выполняются команды, какую обратную связь она получает и когда должна закончить работу. Одна и та же модель может решить задачу или провалить её в зависимости от этой логики.
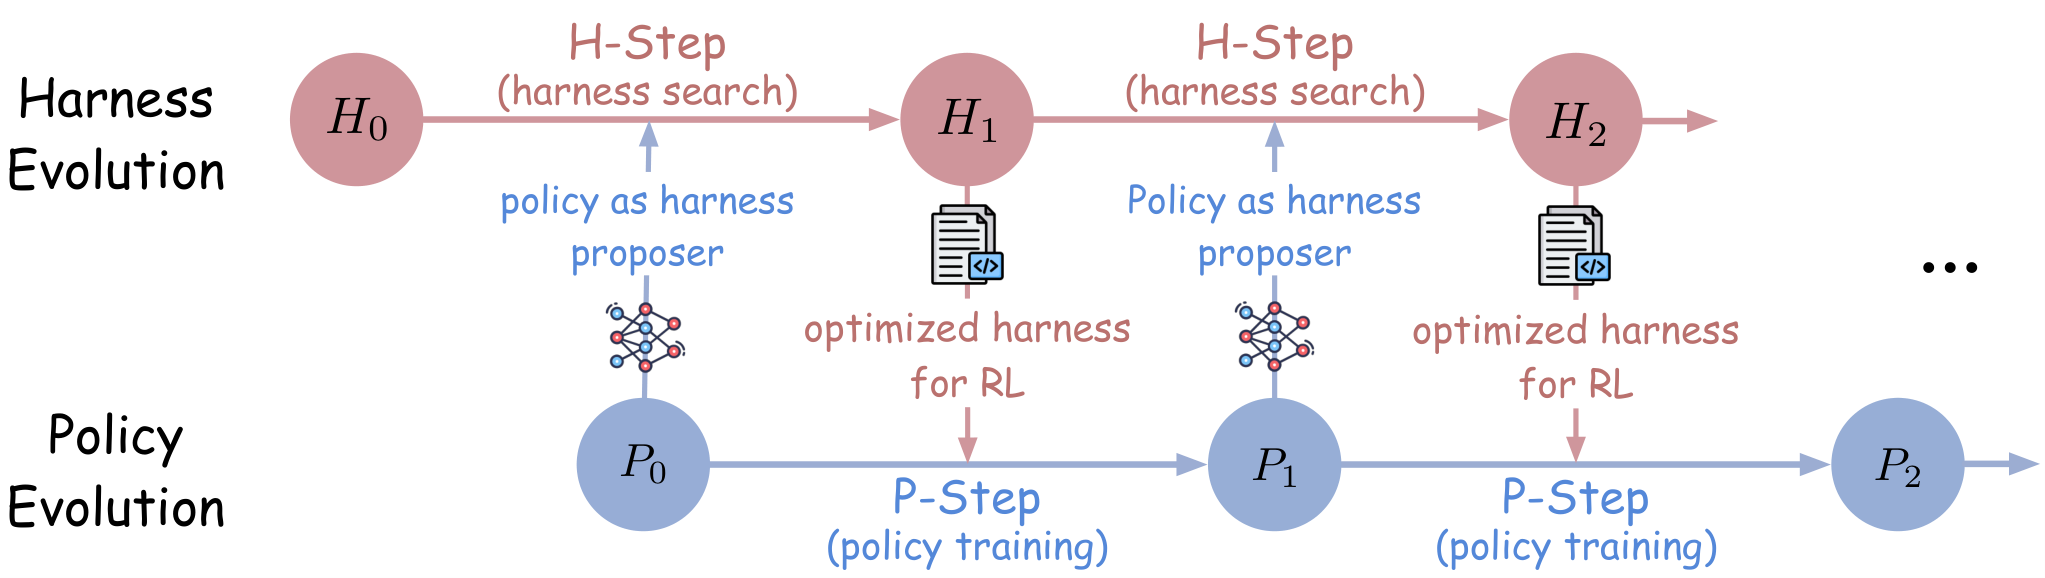
Self-HPO чередует два шага. Сначала текущая модель изучает неудачные траектории и предлагает изменения в промпте или исполняемом коде агента. Все варианты проверяются на одном наборе сложных задач, после чего система сохраняет лучший.
Затем обвязку фиксируют, а модель обновляют через обучение с подкреплением. Награда проверяема: созданная заплатка либо проходит тесты задачи, либо нет. Для обучения используют GRPO, а BAR добирает траектории так, чтобы в группе были не только одинаковые неудачные результаты и модель получала полезный сигнал.
Задачи, которые модель не решила ни в одной попытке, переходят в следующий цикл поиска обвязки. Поэтому система не продолжает исправлять старые слабости после того, как модель уже их освоила. В эксперименте провели два цикла, на каждом проверяли шесть вариантов обвязки и выполняли 50 обновлений модели.
Получившиеся изменения не свелись к переписыванию системного промпта. Обвязка предупреждала модель перед исчерпанием бюджета, задерживала пустую заплатку, предлагала добавить новые файлы через git add -N, просила проверить имена и сигнатуры API и подставляла результат Git diff, если отправленная заплатка не применялась.
Совместное обновление обошло настройку одного компонента
На SWE-Bench Verified Self-HPO решил 69,5% задач против 61,0% у исходного агента. Обучение только модели дало 67,5%, а изменение только обвязки — 65,2%. Когда варианты обвязки предлагал внешний Opus 4.8, результат совместного подхода достиг 71,6%.
Обучение и поиск обвязки проводили на задачах из Python-проектов. Затем систему проверили на SWE-Bench Verified, SWE-Bench Multilingual и SWE-Bench Pro. Улучшение сохранилось на задачах с другими языками и более разнообразными репозиториями, хотя конкретную схему испытывали только с Qwen3.5-35B-A3B и mini-SWE-agent.
Перекрёстная проверка разделила вклад компонентов. Обновлённая модель работала лучше с исходной обвязкой, а обновлённая обвязка помогала исходной модели. Вместе они дали больший прирост, чем сумма отдельных улучшений: обвязка не просто компенсировала ошибки модели, а создавала траектории, на которых модель затем училась.
Подмена меняющегося набора сложных задач исходным фиксированным набором ухудшила итог. Это поддерживает основную конструкцию Self-HPO: после обновления модели нужно заново искать её актуальные сбои, а не продолжать оптимизацию по прежнему срезу.
Командам нужен общий цикл версий модели и среды
Работа меняет план разработки, если команда обучает собственную модель для инженерных задач. Версию обвязки стоит связывать с конкретной контрольной точкой модели: после дообучения прежний промпт, правила завершения и обработчики инструментов могут перестать попадать в актуальные причины ошибок.
Журнал неудачных запусков при таком подходе становится входом сразу для двух процессов. По нему команда меняет исполнение агента, а затем собирает новые траектории для обучения модели. После обновления модели набор сложных задач приходится пересобирать, иначе следующий поиск будет улучшать уже решённые случаи.
Self-HPO не предполагает, что агент бесконтрольно переписывает себя в рабочей среде. Кандидаты проверяются на выделенном наборе задач, результат оценивает исполняемый верификатор, а обучение проходит при зафиксированной обвязке. Для продукта это скорее конвейер подготовки новой версии агента, чем самоизменение во время пользовательского запроса.
Если команда использует закрытую модель через API и не может обновлять её веса, полный цикл повторить не получится. Остаётся поиск обвязки по реальным сбоям, но эксперимент показывает, что этот путь уступает совместному обновлению. Наиболее прямое применение Self-HPO — агенты с проверяемым результатом, доступом к обучению модели и тестовым набором, который воспроизводит ошибки из целевых репозиториев.
Источники
Иллюстрация: рисунок из статьи «Self-Evolving Coding Agents via Harness-Policy Optimization», Zhepei Wei, Wenlin Yao, Baolin Peng и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


