
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
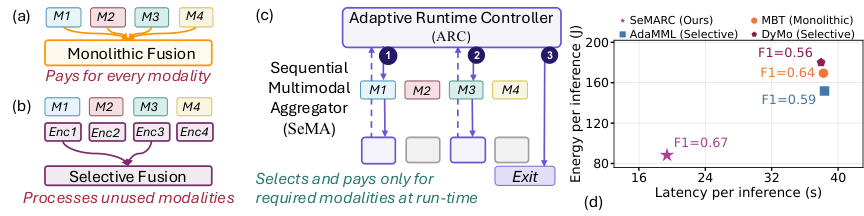
Мультимодальную модель научили для каждого примера выбирать, какие входы обработать, и останавливаться, когда данных уже достаточно. В препринте Arm и Northwestern University, который ещё не прошёл рецензирование и все числа в котором получили сами авторы, SeMARC использовал на 61,4% меньше вычислений, а его macro-F1 оказался на 3,2% выше, чем у самого точного конкурента для каждого набора данных. Такой подход позволяет снижать задержку и энергопотребление до запуска дорогих энкодеров, а не после обработки ненужных входов.
SeMARC выбирает модальность до её обработки
Обычная мультимодальная система сначала пропускает видео, звук, текст или данные датчиков через отдельные энкодеры, а затем объединяет представления. Если модель после этого отбрасывает часть входов, основные вычисления уже выполнены и экономия остаётся только на блоке объединения.
SeMARC меняет порядок действий. Контроллер ARC сначала смотрит на уже собранные признаки, текущий прогноз модели, его неопределённость и список доступных модальностей. Затем он выбирает следующий вход либо завершает обработку. Энкодер запускается только после этого решения, поэтому ветви для пропущенных модальностей не выполняются.
Компонент SeMA добавляет выбранный вход к накопленному состоянию фиксированного размера. Он обновляет прогноз после каждого шага и не пересчитывает предыдущие ветви. В результате система одновременно экономит на энкодерах и повторно использует уже выполненные вычисления.
Контроллер обучают отдельно после заморозки SeMA. Он сочетает заранее рассчитанную оценку пользы каждой следующей модальности с обучаемой Q-функцией, которая оценивает действия по ожидаемой награде. Награда учитывает правильность итогового ответа и цену новых вычислений, поэтому порог остановки можно настраивать под требования продукта.
Обучение уменьшает зависимость от порядка входов
Последовательное объединение создаёт проблему: звук, добавленный после видео, может дать другой прогноз, чем тот же набор входов в обратном порядке. Если хранить всю историю, число возможных последовательностей растёт факториально и усложняет контроллер.
При обучении SeMA получает случайные подмножества модальностей в случайном порядке. Ошибка считается после каждого промежуточного шага, а не только после обработки полного набора. Дополнительная дистилляция подтягивает промежуточные прогнозы к результату на всём доступном наборе.
Это не делает архитектуру математически независимой от порядка: новое представление всё равно зависит от накопленного состояния. Однако прогнозы для одинакового набора входов становятся ближе друг к другу. Поэтому ARC хранит только список уже обработанных и доступных модальностей, текущие вероятности классов и признаки неопределённости, но не полную последовательность действий.
Контроллер не просматривает необработанный вход перед выбором. Это важное отличие от схем с дешёвыми предварительными представлениями: даже предварительный просмотр требует запустить часть обработки и уменьшает возможную экономию.
Когда стоит менять архитектуру продукта
Пропуск ветвей сократил сквозную задержку в среднем на 44% на GPU и CPU и на 47,2% на Android с целочисленной квантизацией. При случайно недоступных входах SeMARC показал лучший или равный macro-F1 в 21 из 24 условий, одновременно выполняя на 14,8% меньше вычислений. Macro-F1 усредняет качество по классам с одинаковым весом и поэтому не позволяет частым классам скрыть ухудшение на редких.
Проверка охватила шесть наборов данных для распознавания эмоций и действий человека, включая IEMOCAP, MM-Fi, CMI, CZU-MHAD, EAV и UTD-MHAD. SeMARC сравнивали с одиннадцатью базовыми методами на серверных GPU, CPU и телефоне. Это задачи классификации с отдельными ветвями для модальностей; работа не проверяет генеративные мультимодальные модели и системы, где входы нельзя разделить на независимые энкодеры.
Результат меняет планы команд, у которых стоимость обработки входов заметно различается, а часть модальностей дублирует информацию. Для видеоаналитики, носимых датчиков и обработки на устройстве имеет смысл закладывать раздельные энкодеры, промежуточный прогноз и явное действие остановки уже при проектировании архитектуры.
Добавить такой контроллер поверх готовой монолитной модели недостаточно. Экономия возникает потому, что решение принимается до запуска ветви, а объединение умеет продолжать работу из накопленного состояния. Переход потребует переобучить основу на случайных подмножествах и порядках, затем отдельно настроить контроллер под реальную стоимость каждой модальности.
Если для ответа почти всегда нужны все входы или основную задержку создаёт общий блок после объединения, выигрыш будет меньше. Работа показывает архитектурный вариант для избыточных модальностей, но не универсальную замену полному мультимодальному запуску.
Источники
Иллюстрация: рисунок из статьи «Efficient Multimodal Inference through Adaptive Acquisition and Sequential Fusion», Payal Mohapatra, Haodong Yang, Yueyuan Sui и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


