
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
LLM научили исправлять модели оптимизации, которые запускаются без ошибок, но решают не ту задачу. В препринте, который не прошёл рецензирование и содержит замеры самих авторов, SemOPT повысил среднюю точность на сложных наборах на 7,6% относительно сильнейшего базового метода. Для продуктовой архитектуры отсюда следует практическое разделение: решатель проверяет исполняемость, а отдельная модель — соответствие исходному условию.
Работающий код ещё не означает правильную модель
SemOPT разделяет ошибки на синтаксические и смысловые. В первом случае код не исполняется либо решатель считает модель недопустимой. Во втором код возвращает целевое значение, хотя LLM неверно поняла ограничение, выбрала другую целевую функцию или сделала неподходящее допущение.
Решатель обнаруживает первый класс ошибок и возвращает сообщение, которое можно передать LLM для исправления. Смысловая ошибка такого сигнала не создаёт: программа завершилась штатно, поэтому обычная самопроверка склонна принять результат.
На IndustryOR три раунда самопроверки исправили 66,7% синтаксических ошибок, но только 21,4% смысловых. Разрыв объясняет, почему дополнительный цикл генерации сам по себе плохо помогает: модель видит собственный правдоподобный код, а не независимую проверку постановки.
Для такой проверки SemOPT обучает семантическую модель-оценщик. Она получает описание задачи и код решателя, после чего выдаёт оценку их согласованности. Обучение строится на парах: один вариант запускается и возвращает правильное целевое значение, второй тоже запускается, но даёт неверный результат.
К естественным ошибкам добавляют искусственно изменённые примеры: в правильный код вносят смысловую поломку и оставляют только варианты, которые по-прежнему исполняются. Так оценщик не может отличать классы по сообщениям решателя или поверхностным признакам неработающей программы.
Поиск возвращается от кода к стратегии
Сначала SemOPT генерирует код, запускает его и передаёт технические ошибки обратно LLM. Итоговая оценка учитывает оба условия: программа должна исполниться, а модель-оценщик — подтвердить её соответствие задаче.
Если уверенность выше заданного порога, система принимает первоначальный вариант. Если ниже, включается поиск по дереву методом Монте-Карло. Благодаря этому простые постановки не оплачивают полный цикл перебора, а сомнительные получают дополнительный вычислительный бюджет.
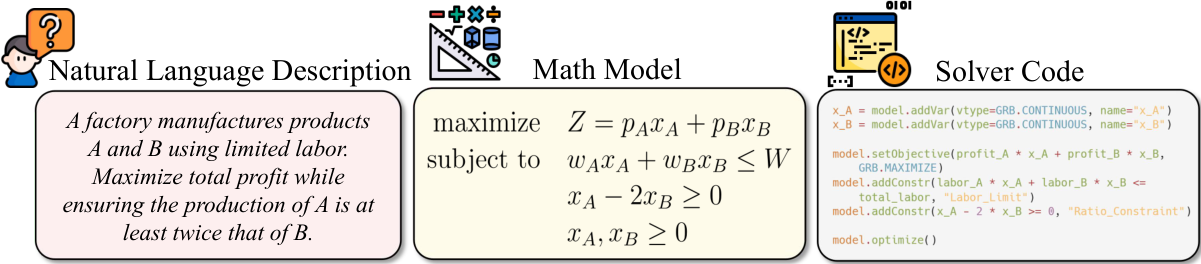
Дерево отражает последовательность работы специалиста по исследованию операций. Верхний уровень выбирает стратегию моделирования и тип оптимизационной задачи. Следующий формулирует переменные, целевую функцию и ограничения, а последний превращает математическую запись в код решателя.
Каждая ветвь доводится до исполняемого кода и получает семантическую оценку. Затем результат передаётся вверх по дереву. Если ошибка возникла при выборе стратегии, поиск может вернуться к этому решению, а не бесконечно редактировать отдельное уравнение или строку кода.
Этим SemOPT отличается от методов, которые перебирают локальные компоненты модели или используют универсальную LLM как судью. Отдельный оценщик обучен именно различать верную постановку и правдоподобную, но неверную реализацию.
Архитектурный шаблон полезнее готовой замены
Метод проверили на семи наборах: NL4Opt, NL4LP, EasyLP, ReSocratic, IndustryOR, ComplexLP и ComplexOR. Первые группы в основном содержат стандартные задачи линейного программирования, а сложные наборы — неявные ограничения и длинные описания. Код генерировала GPT-4.1 Nano, модель-оценщик построили на Qwen3-4B-Instruct-2507; сравнение охватило обычную генерацию, рабочие процессы, дообученные и поисковые методы.
На ComplexOR вероятность получить правильный вариант среди N попыток достигла 72,2%, превысив лучший базовый результат на 9,2 процентного пункта. Когда итоговый вариант выбирала сама модель-оценщик, точность составила 66,7%. Разница важна для внедрения: наличие правильного кандидата в наборе ещё не гарантирует, что система отправит именно его дальше.
Адаптивный запуск поиска сократил расход API по сравнению с полным перебором до 12–19% от его уровня. Значит, полезная часть подхода — не просто генерация большего числа вариантов, а ранняя остановка на уверенных ответах и углублённый поиск только для сомнительных.
Командам, которые уже генерируют код оптимизации через LLM, работа предлагает изменить контур контроля. Проверку запуска стоит оставить решателю, а смысловую проверку вынести в отдельный компонент перед публикацией результата. Повторную генерацию лучше направлять не только на код, но и на исходную стратегию и математическую постановку.
Такой контур требует исполняемого решателя и обучающих примеров с известным правильным результатом. В экспериментах ответ считался верным по совпадению целевого значения с эталоном, поэтому перенос на производственный процесс также требует проверки ограничений, допущений и самой целевой функции.
Работа охватывает тестовые задачи, а не развёрнутые системы принятия решений. Для энергетики, медицины или финансов SemOPT поэтому выглядит как схема дополнительного контроля, а не основание убрать эксперта из проверки модели.
Источники
Иллюстрация: рисунок из статьи «SemOPT: Fixing Semantic Errors in LLM-based Optimization Modeling via Reward-Guided Search», Zetong Zhou, Wentao Zhang, Jingyuan Wang и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


