
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
LLM-агента научили накапливать опыт сбоев, не заставляя его постоянно учитывать все прежние инструкции по восстановлению. В препринте Changxiu Ji, Amy Lu, Qizheng Zhang и Kunle Olukotun система Sentry в среднем обошла другие способы вмешательства во время выполнения на 37%; работа не прошла рецензирование, а все числа получили сами авторы. Для архитектуры агента отсюда следует практическое правило: память об ошибках стоит подключать по состоянию текущей задачи, а не добавлять целиком в постоянный контекст.
Почему полезная инструкция начинает мешать
Инструкция по восстановлению работает только при конкретном сбое. Совет расширить поисковый запрос полезен, когда повторные запросы не дают результата, но способен сбить агента, который уже нашёл подходящий товар и должен перейти к покупке.
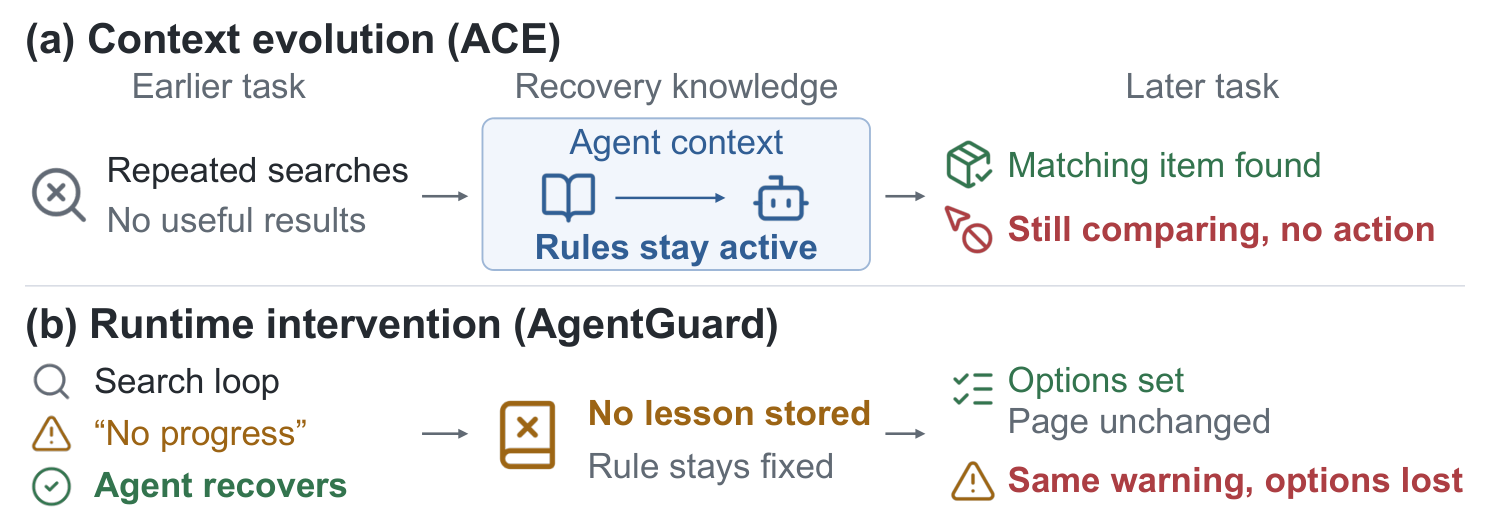
Авторы показывают такой случай в WebShop: агент с постоянно доступными правилами нашёл нужный товар, но продолжил сравнивать варианты и в итоге не выполнил действие. Проблема не в качестве самого правила, а в том, что модель должна на каждом шаге заново решать, относится ли оно к текущей ситуации.
У существующих подходов оказываются противоположные недостатки. Методы развития контекста сохраняют выводы из прошлых задач, но показывают их агенту слишком рано — ещё до появления сбоя. Системы вмешательства во время выполнения реагируют на текущую траекторию, однако обычно не сохраняют удачные исправления для следующих задач.
Sentry разделяет эти функции. Полный сборник инструкций остаётся во внешнем хранилище, а агент получает только те записи, которые соответствуют уже обнаруженной поломке. Поэтому прежний опыт не занимает постоянный контекст и не влияет на нормальные шаги.
Как Sentry находит сбой и проверяет восстановление
Sentry работает рядом с основным агентом и наблюдает за последними 5 циклами «рассуждение — действие — результат». Сначала система проверяет, соответствует ли действие схеме инструмента. Неверный вызов отправляется на немедленное исправление: агент должен выдать новое действие в допустимом формате.
Для допустимых вызовов Sentry ищет два более сложных класса проблем. К первому относятся повторы и остановка прогресса, ко второму — выводы без опоры на наблюдения и расхождение между рассуждением и действием. Если признаков сбоя нет, система не вмешивается и не извлекает инструкции.
После обнаружения проблемы Sentry назначает ей тип и более узкие метки, затем выбирает из внешнего сборника не больше 5 похожих случаев. Агент получает описание локальной ошибки, подходящие уроки и предложение сделать следующий шаг, не меняя исходную цель.
Удачное исправление не записывается сразу. Sentry наблюдает ещё 10 циклов и проверяет, исчез ли прежний шаблон сбоя, возобновился ли прогресс и опираются ли действия на результаты среды. Итоговая награда задачи проверяющему компоненту недоступна: он оценивает только выход из конкретной поломки.
Новый урок попадает в сборник лишь после такой проверки. Запись содержит тип сбоя, признаки для последующего поиска, ситуацию запуска и принцип исправления. Детектор и правила извлечения при этом не обучаются — меняется только накопленный набор подтверждённых случаев.
Командам стоит отделить память о сбоях от памяти о задаче
Sentry проверяли на WebShop, AppWorld, SWE-bench Lite и интерактивной версии Mind2Web Replay. Основные опыты провели с Qwen3.5-9B, дополнительные — с GPT-OSS-120B. Систему сравнивали как с агентами, которые вмешиваются в текущую траекторию, так и с методами, которые обновляют контекст между задачами.
Sentry победила лучший метод вмешательства на каждом стенде, а максимальный относительный выигрыш достиг 77% в WebShop. На двух стендах, где сравнивали накопление памяти между задачами, система обошла ACE на 39%. Совместное использование Sentry и ACE дало лучший результат, поэтому память о ходе задачи и память о способах восстановления не обязательно конкурируют.
Контрольный опыт отделяет пользу записанных уроков от способа их подачи. Когда один и тот же сборник дополнительно помещали в постоянный контекст, результат WebShop снизился на 0,068, а Mind2Web Replay — на 0,052. Подходящие записи при этом оставались доступны по запросу, то есть ухудшение связано именно с постоянным показом всего сборника.
Для продуктовой системы это аргумент в пользу отдельного контура управления сбоями: детектор наблюдает траекторию, внешнее хранилище держит подтверждённые исправления, а агент видит их только после совпадения с текущей ошибкой. Такой контур можно добавить поверх существующего агента, не переписывая его основную память и правила выполнения задач.
Цена этой схемы — дополнительные вызовы модели. Sentry потратила в 1,54 раза больше токенов, чем базовый агент; время выполнения менялось в обе стороны, поскольку ранний выход из циклов иногда компенсировал работу детектора и проверяющего компонента. Поэтому перед внедрением стоит измерить не только долю завершённых задач, но и частоту вмешательств, расход токенов и задержку на собственных длинных сценариях.
Переносимость пока подтверждена в пределах перечисленных стендов и двух семейств моделей. Кроме того, роль агента, детектора и проверяющего компонента выполняла одна модель, поэтому работа не отвечает на вопрос, даст ли разделение этих ролей более дешёвую или точную конфигурацию.
Источники
Иллюстрация: рисунок из статьи «Sentry: Learning to Recover from LLM Agent Failures at Test Time», Changxiu Ji, Amy Lu, Qizheng Zhang и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


