
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Кодовые агенты смогли собрать систему запуска LLM и сами подобрать для неё рабочую нагрузку, а не только ускорить отдельный фрагмент кода. В препринте Carnegie Mellon University и University of Southern California, который не прошёл рецензирование, все числа получили сами авторы: Claude Sonnet 5.5 на Gemma E4B превзошёл эталонный vLLM в 4,87 раза. Для команд это превращает агента в кандидата на роль инженера по производительности, но только внутри стенда с независимой проверкой.
Как ServerBench связывает код, нагрузку и стоимость
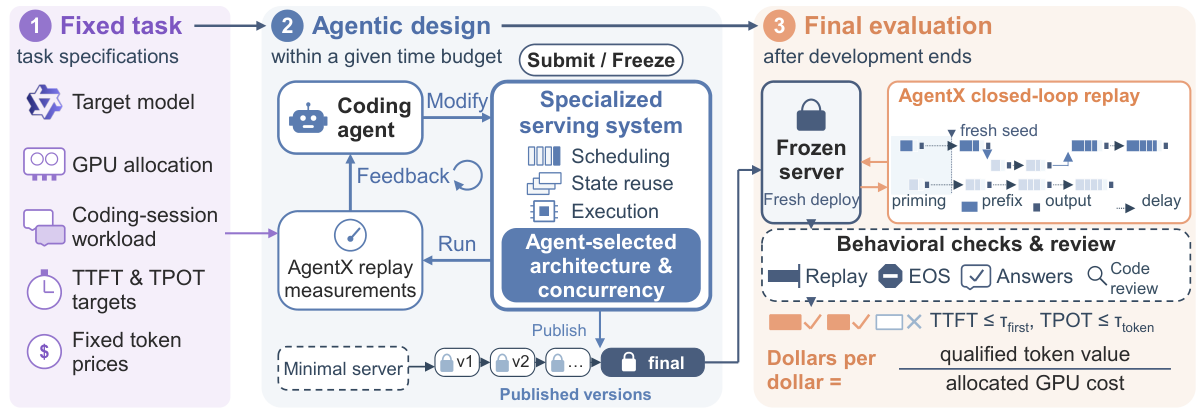
Обычный тест системы запуска LLM фиксирует нагрузку и измеряет пропускную способность. ServerBench ставит более широкую задачу: агент получает модель, GPU, записи рабочих сеансов и минимальный сервер на Transformers. Он может менять пакетную обработку, планировщик, управление памятью и повторное использование состояния, а затем выбирает, сколько сеансов обслуживать одновременно.
Целевая метрика называется «доллары на доллар». Завершённым входным и выходным токенам присваивают стоимость по фиксированным тарифам API, но учитывают только запросы, которые уложились в пороги времени до первого токена и времени генерации следующего токена. Получившуюся стоимость делят на расходы на GPU.
Такая метрика не позволяет выиграть одним увеличением нагрузки. Дополнительные сеансы приносят больше токенов, пока очереди и конкуренция за память не выводят ответы за пороги задержки. Агенту приходится одновременно повышать производительность сервера и искать нагрузку, при которой улучшение ещё работает.
Сеансы воспроизводят зависимости между запросами: следующий ход ждёт предыдущего ответа, контекст растёт, а параллельные подагенты создают отдельные ветви. Длины и структура взяты из записей кодовых агентов, при этом содержимое запросов заменено. Поэтому задержка одного ответа влияет на объём работы, который успеет завершить весь сеанс.
Работу проверяли на 11 кодовых моделях и трёх развёртываниях с GPU L40; на разработку одной системы давали восемь часов. В качестве эталонов использовали SGLang и vLLM, а пороги задержки заранее зафиксировали по 90-му процентилю SGLang. Это исследование конкретного класса нагрузок и оборудования, а не общий рейтинг агентов или серверов LLM.
Рабочая оптимизация должна пройти тем же путём, что и запрос
Проверку прошли 22 из 33 собранных систем, а 13 превзошли лучший эталон для своего развёртывания. Разрыв показывает две разные задачи: агенту нужно найти ускорение и не нарушить поведение модели на пути, который действительно используется под нагрузкой.
Лучшие решения сочетали несколько изменений. Они повторно использовали общий контекст между ходами, переносили часть состояния в оперативную память, меняли планирование и применяли черновую генерацию токенов с последующей проверкой. После этого агент повышал число параллельных сеансов, пока задержка не начинала съедать выигрыш.
Содержание эксперимента влияло на выбор оптимизации. На случайном тексте один агент отверг черновую генерацию, тогда как ответы из рабочей нагрузки показали её пользу. Подобранный по этим ответам режим повысил итоговую ценность на 3,0–3,9% в двух новых прогонах.
Короткий тест при этом мог пропустить остановку на длинном контексте, сбой между запросами или ошибку в кэше после вытеснения состояния. ServerBench заново собирает опубликованную систему, запускает другие сеансы и проверяет полные запросы, длину ответов, потоковую выдачу, соответствие весам модели и качество ответов. Затем код и журнал действий просматривают отдельно, чтобы найти обход вычислений и другие недопустимые сокращения.
Где ServerBench меняет план внедрения агентов
Работа не даёт основания передавать агенту эксплуатационный сервер и принимать его итоговый коммит без проверки. Она предлагает более узкую схему: агент работает внутри воспроизводимого стенда, видит метрики полного сеанса и публикует версию, которую затем оценивает независимый контур.
Для такого стенда сначала нужно зафиксировать веса модели, точность вычислений, оборудование, структуру сеансов и требования к задержке. Следом определить одну целевую метрику, которая связывает производительность с затратами. Если измерять только токены в секунду, агент сможет выбрать решение, которое выглядит быстрым, но обслуживает меньше полезных запросов или нарушает задержку.
Записи нагрузки должны сохранять не только длины запросов. Нужны общие префиксы, зависимости между ходами, параллельные ветви и паузы между запросами. Иначе агент оптимизирует искусственный поток независимых обращений и не увидит конкуренцию между обработкой нового контекста, генерацией и хранением состояния.
Отдельный контур проверки становится частью архитектуры разработки. После каждого изменения, которое добавляет новый путь выполнения, стоит проверять длинный контекст, параллельные запросы, повторное использование состояния, естественную остановку генерации и запуск в чистом окружении. Полный повтор рабочего сеанса нужен до публикации версии, а не после серии локальных микротестов.
Практический сдвиг состоит не в замене инженера агентом, а в разделении ролей. Агент быстрее перебирает изменения сервера и режимы нагрузки; команда задаёт экономическую цель, строит воспроизводимый стенд и решает, какие проверки дают право перенести результат в эксплуатацию.
Источники
Иллюстрация: рисунок из статьи «ServerBench: How can your coding agents design specialized LLM serving systems?», Xinrui Zhong, Zhiming Wang, Yongqi Liu и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


