
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Специализированной LLM можно вернуть общие навыки исходной модели, почти не жертвуя приобретённой специализацией. В препринте UC Santa Barbara, который не рецензирован и содержит замеры самих авторов, схема сохранила в среднем 92% выигрыша от дообучения. Готовый специализированный чекпойнт можно дополнить исходной моделью без доступа к весам и нового обучения.
Специализированная модель готовит черновик, исходная — окончательный ответ
Контролируемое дообучение (SFT) учит LLM решать конкретную задачу на примерах с готовыми ответами. Вместе со специализацией модель может потерять прежние навыки: хуже соблюдать формат, отвечать на других языках или распознавать запросы за пределами своей области.
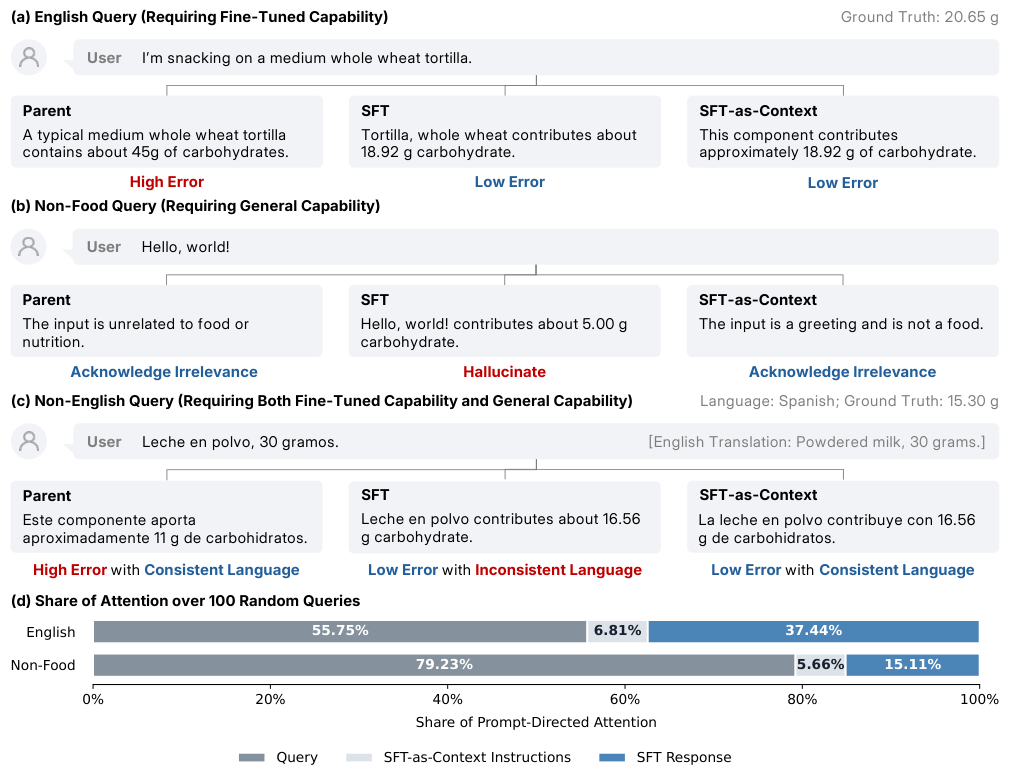
В работе есть наглядный случай с моделью для оценки пищевой ценности. После дообучения она точнее считает углеводы, жиры, белки и энергетическую ценность блюда, но на запрос «Hello, world!» всё равно выдаёт значение углеводов. Исходная модель правильно понимает, что запрос не относится к еде.
SFT-as-Context разделяет ответ на два последовательных прохода. Сначала специализированная модель получает исходный запрос и пишет ответ. Затем исходная модель получает запрос, этот ответ как контекст и инструкцию использовать его, если в нём нет конкретных ошибок.
Первый проход вносит знания и формат, которым научили специализированную модель. Второй возвращает общие способности исходной LLM: понимание языка, следование дополнительным требованиям и обработку запросов вне области специализации. Для каждого из трёх исследованных направлений использовали одну фиксированную инструкцию, не меняя её под отдельные модели и проверки.
Метод проверили на 19 парах исходных и специализированных моделей и 11 наборах задач по математике, программированию и оценке пищевой ценности. Среди проверок были как профильные задачи AIME 2024, LiveCodeBench и NutriBench-English, так и запросы, где специализацию нужно совместить с форматом ответа, другим языком или общими знаниями.
Черновик сохраняет специализацию, второй проход исправляет забывание
На общих задачах итоговая схема в среднем отставала от исходных моделей на 2,2 процентного пункта. При этом на профильных задачах она оставалась близка к специализированным моделям: разрыв составил 2,2 пункта на AIME 2024 и 2,1 пункта на LiveCodeBench.
На NutriBench-English разница со специализированной моделью составила 2,0 единицы агрегированной средней абсолютной ошибки. Здесь меньшая ошибка означает, что оценка пищевой ценности ближе к эталону.
Самый содержательный результат относится к составным запросам. В MathIF специализированная модель могла правильно решить задачу, но нарушить требование писать строчными буквами из-за заглавного символа R. Исходная модель с её ответом в контексте сохраняла решение и исправляла формат.
Авторы также изучили распределение внимания внутри исходной модели. Она сильнее учитывала полезные ответы специализированной модели и слабее — ошибочные ответы на запросы не по теме. Это наблюдение показывает возможный механизм работы метода, но само по себе не доказывает, что внимание служит причиной улучшения.
Теоретическая часть описывает тот же эффект через вероятностную модель. Гарантии действуют при заданных предположениях: исходная LLM уже должна уметь представлять нужный ответ, а добавленный контекст не должен сильно подавлять подходящую область её знаний. Поэтому доказательство объясняет результат в рамках модели, а не обещает его для любой пары чекпойнтов.
Когда SFT-as-Context меняет архитектуру продукта
Работа меняет планы команд, у которых уже есть специализированный чекпойнт, но его забывание проявляется в эксплуатации. Вместо повторного обучения с другими данными или ограничениями можно поставить перед исходной моделью готовый ответ SFT-модели и проверить схему на собственных запросах.
Наиболее подходящий сценарий — запросы, где одновременно нужны профильный навык и общая способность. Это может быть генерация кода с жёстким форматом, расчёт по предметной области на языке пользователя или отказ отвечать на запрос, который не относится к специализации.
Связка не обязана состоять из исходной модели и её производной. Ответ дообученной Qwen3-4B улучшил результат Gemini 3.5 Flash на NutriBench-English: ошибка снизилась с 17,44 до 14,08, и связка обошла обе модели по отдельности. Значит, небольшую открытую модель можно рассматривать как поставщика предметного черновика для более сильной закрытой LLM.
За это приходится платить вторым последовательным вызовом модели. Работа сравнивает качество, а не производственную задержку и стоимость, поэтому перед внедрением нужно отдельно измерить время ответа, расход токенов и долю случаев, когда второй проход действительно исправляет первый.
SFT-as-Context не заменяет дообучение: специализированная модель всё равно должна откуда-то получить предметный навык. Метод меняет следующий этап — вместо попытки вместить специализацию и все общие способности в один чекпойнт команда может разделить их между черновиком и окончательным ответом.
Источники
Иллюстрация: рисунок из статьи «SFT-as-Context Mitigates Forgetting in Supervised Fine-Tuning», Kenan Tang, Andong Hua, Chengxuan Qian и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


