
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
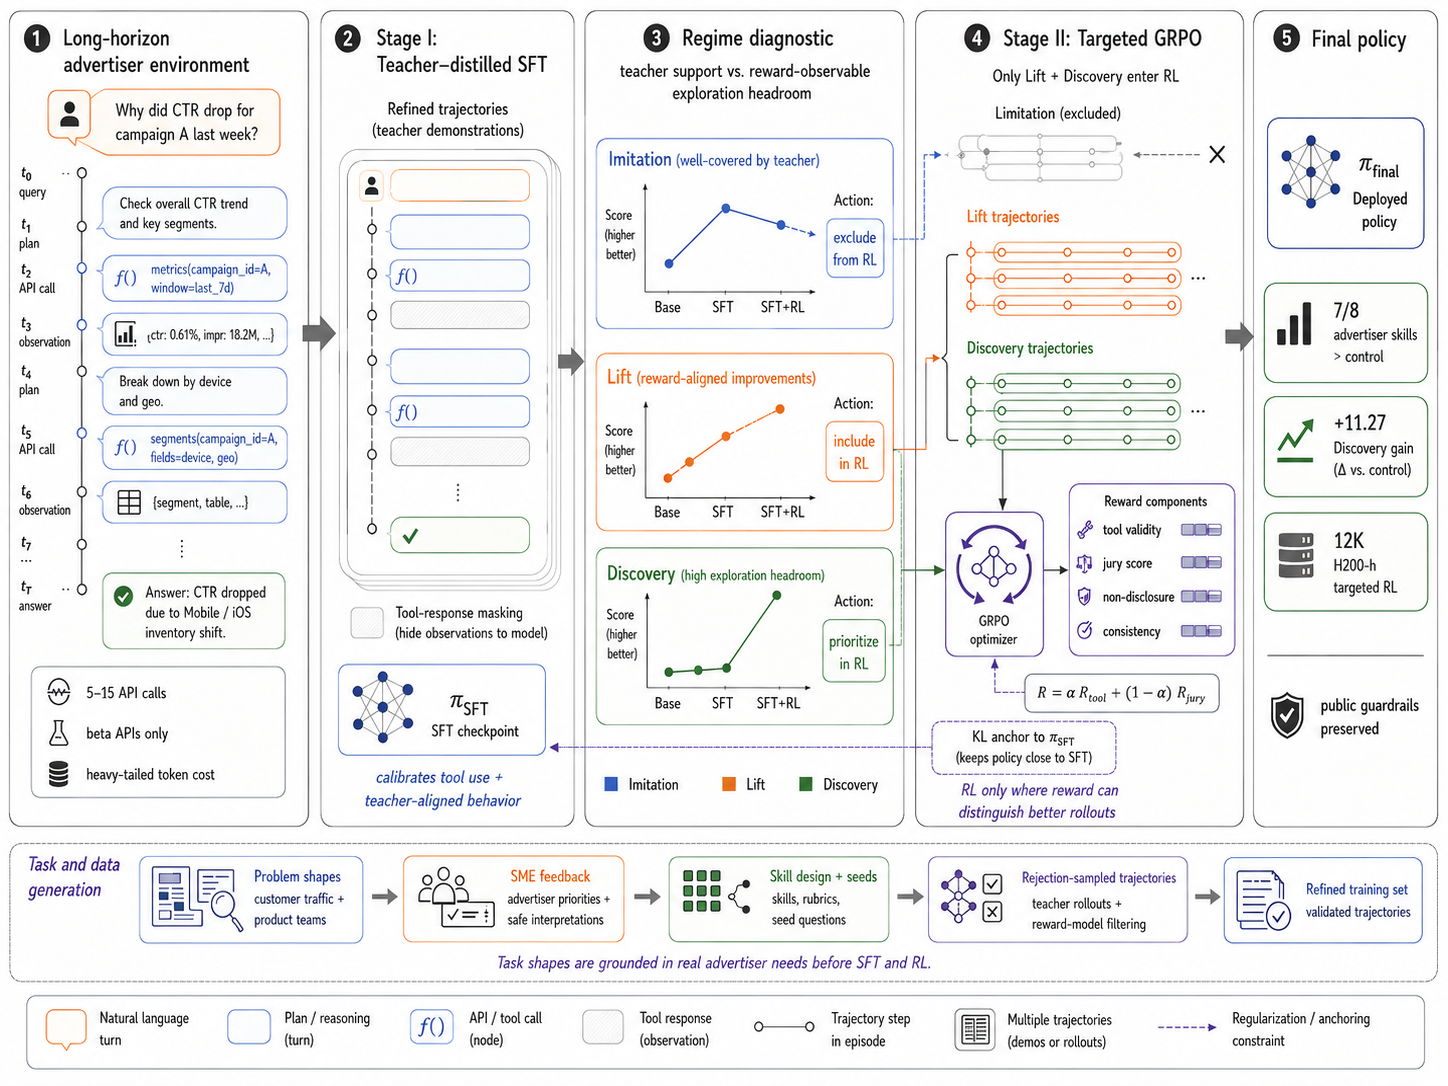
Долгим агентным сценариям не всегда нужно обучение с подкреплением: его можно заранее направить только на навыки, где модель ещё способна найти лучший путь. В препринте Amazon Advertising и Amazon Web Services Agentic AI, который не прошёл рецензирование и где числа получили сами авторы, точечное обучение сократило дополнительные вычисления на 43% против равномерного. Для продуктовой команды это превращает выбор между SFT и RL из общего решения для всей модели в проверку каждого навыка.
Два сигнала показывают, нужен ли навыку RL
Работа посвящена агентам, которые выполняют длинные цепочки действий: находят данные, вызывают API, запускают код и меняют план после промежуточных результатов. В таких задачах дообучение с учителем, SFT, сначала учит модель синтаксису инструментов и воспроизводит удачные траектории модели-учителя.
Но демонстрации покрывают поведение неравномерно. Для одного навыка учитель почти всегда показывает подходящий путь, а для другого пропускает полезные варианты. Если применять обучение с подкреплением, RL, ко всем навыкам подряд, оно тратит вычисления на уже освоенные действия и может расстроить то, что SFT настроило правильно.
Первый диагностический сигнал — поддержка учителя. Команда проверяет, какая доля сгенерированных им траекторий выполняется без ошибок, не искажает данные и проходит предметную рубрику. Высокая поддержка означает, что нужное поведение уже представлено в демонстрациях и его можно перенести через SFT.
Второй сигнал — запас награды. Из замороженной SFT-модели получают несколько ответов на один запрос и сравнивают среднюю награду с наградой лучшего варианта. Награда здесь объединяет корректность вызовов инструментов и качество итогового ответа, которое выставляет жюри из моделей-оценщиков.
Если варианты почти не отличаются, RL не получает полезного сигнала для поиска. Если хотя бы некоторые траектории заметно лучше среднего, среда уже умеет отличать перспективное поведение и может направлять обучение.
Из двух сигналов получаются четыре маршрута. При надёжном учителе и малом запасе награды достаточно SFT. При надёжном учителе и заметном запасе после SFT добавляют RL. При слабом учителе, но различимых наградой удачных ответах, RL получает больше бюджета. Если слабы оба сигнала, сначала дорабатывают задания, рубрики или среду, а не запускают более долгий прогон.
Точечный RL обошёл равномерное обучение
Проверка маршрутизации заранее угадала тип траектории в 83% последующих экспериментов. Это главный практический результат: решение принимали до отдельного RL-прогона, а не объясняли уже получившуюся кривую обучения.
В сопоставимом эксперименте точечный RL и равномерный RL начинали с одной SFT-модели, использовали одинаковые награды и настройки оптимизации. Средний отрыв от контрольной модели составил +3,57 пункта при точечном распределении против +1,62 пункта при равномерном.
Самый заметный эффект появился в навыке неразглашения закрытых данных. При атакующих запросах доля утечек снизилась с 22,9% до 6,8%, а экспертная проверка подтвердила, что ответы сохранили практическую полезность. Значит, модель не просто чаще отказывала, а училась извлекать из закрытых наблюдений безопасный вывод.
RL применяли после SFT и удерживали модель рядом с исходной политикой с помощью штрафа за сильное отклонение. Алгоритм GRPO сравнивал траектории внутри группы, поэтому удачные варианты получали положительный сигнал только относительно других ответов на то же задание.
Планы меняет диагностика навыков, а не новая схема обучения
Командам не требуется менять базовую последовательность этапов: SFT по-прежнему создаёт рабочую политику, а RL улучшает её. Меняется единица планирования. Бюджет стоит распределять не на агента целиком, а на отдельные навыки — вызов инструмента, восстановление после ошибки, анализ показателей или безопасное обобщение данных.
Практический процесс начинается с набора проверенных траекторий учителя и замороженной SFT-модели. Для каждого навыка команда оценивает качество демонстраций, запускает повторные ответы, измеряет разброс награды и только после этого выбирает SFT, SFT с RL либо доработку среды. Такой порядок также показывает, где увеличение вычислений не исправит слабую рубрику.
Проверяли GPT-OSS 120B на восьми рекламных навыках в закрытой среде с beta API, приближёнными к рабочей системе. На каждый навык приходилось не менее 250 отложенных примеров, но повторные оценки относились к одному сохранённому состоянию модели и не измеряли разброс между независимыми обучениями. Режим поиска нового поведения в основном подтверждён навыком неразглашения, а последующие проверки были шире, но менее контролируемыми.
Поэтому предложенные пороги нельзя переносить в другой продукт как готовые константы. Переносима сама процедура: отдельно измерить покрытие демонстрациями и способность награды различать хорошие траектории, затем направить RL туда, где оба свойства позволяют ему найти новое поведение.
Для агентов с доступом к закрытым данным поведенческая настройка не заменяет контроль доступа. Даже после удачного RL нужны минимальные права для инструментов, фильтры ответа, журналирование и отдельная проверка сценариев с чувствительными данными.
Источники
Иллюстрация: рисунок из статьи «A Pinch of SFT, A Dash of RL: When Reinforcement Learning Helps Long-Horizon Advertising Agents», Aakash Kolekar, Sahika Genc, Bunyamin Sisman и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


