
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Дообучение LLM повышает шанс успеха с первой попытки, но может отрезать редкие рабочие стратегии, которые базовая модель ещё способна найти повторными запусками. В препринте команды Meta Superintelligence Labs, University of Wisconsin–Madison, NYU и Stanford, который не прошёл рецензирование и содержит замеры самих авторов, базовая Gemma-4-31B достигла на WebShop охвата выше 85% против 56% у дообученной версии. Для агентных систем с параллельными попытками это меняет критерий выбора модели: точность одного запуска не показывает весь доступный запас решений.
Повторные попытки обнаружили скрытые возможности базовых моделей
Работа сравнивает 14 пар базовых и дообученных моделей из четырёх семейств: Gemma-4, Ministral-3, Qwen2.5 и Qwen3.5. Их проверяли на трёх агентных наборах задач — BFCL v4, WebShop и ACEBench, где модель вызывает инструменты, учитывает ответы среды и выполняет последовательность действий.
Для каждой задачи запускали до 128 независимых попыток. Точность одной попытки показывает вероятность немедленного успеха, а охват — вероятность получить хотя бы одно верное решение при заданном бюджете запусков. Второй показатель важен там, где систему можно запустить параллельно, а результат затем проверить автоматически.
Базовым моделям добавили лёгкую обвязку: общий системный запрос, менее строгий разбор вызовов инструментов и обработку ответов, которая не зависела от конкретного набора задач. Дообученные модели запускали со стандартной для теста обвязкой, поскольку та же добавка ухудшала их результаты. Сравнение поэтому показывает возможности моделей в подходящей для каждой версии конфигурации, а не поведение внутри полностью одинакового контура.
Точные рецепты дообучения открытых контрольных точек описаны не полностью. В работе под дообученными объединены модели, чьё поведение могли менять обучение с подкреплением, обучение на готовых примерах и настройка по человеческим предпочтениям.
Дообучение превращает задачи в «всегда» и «никогда»
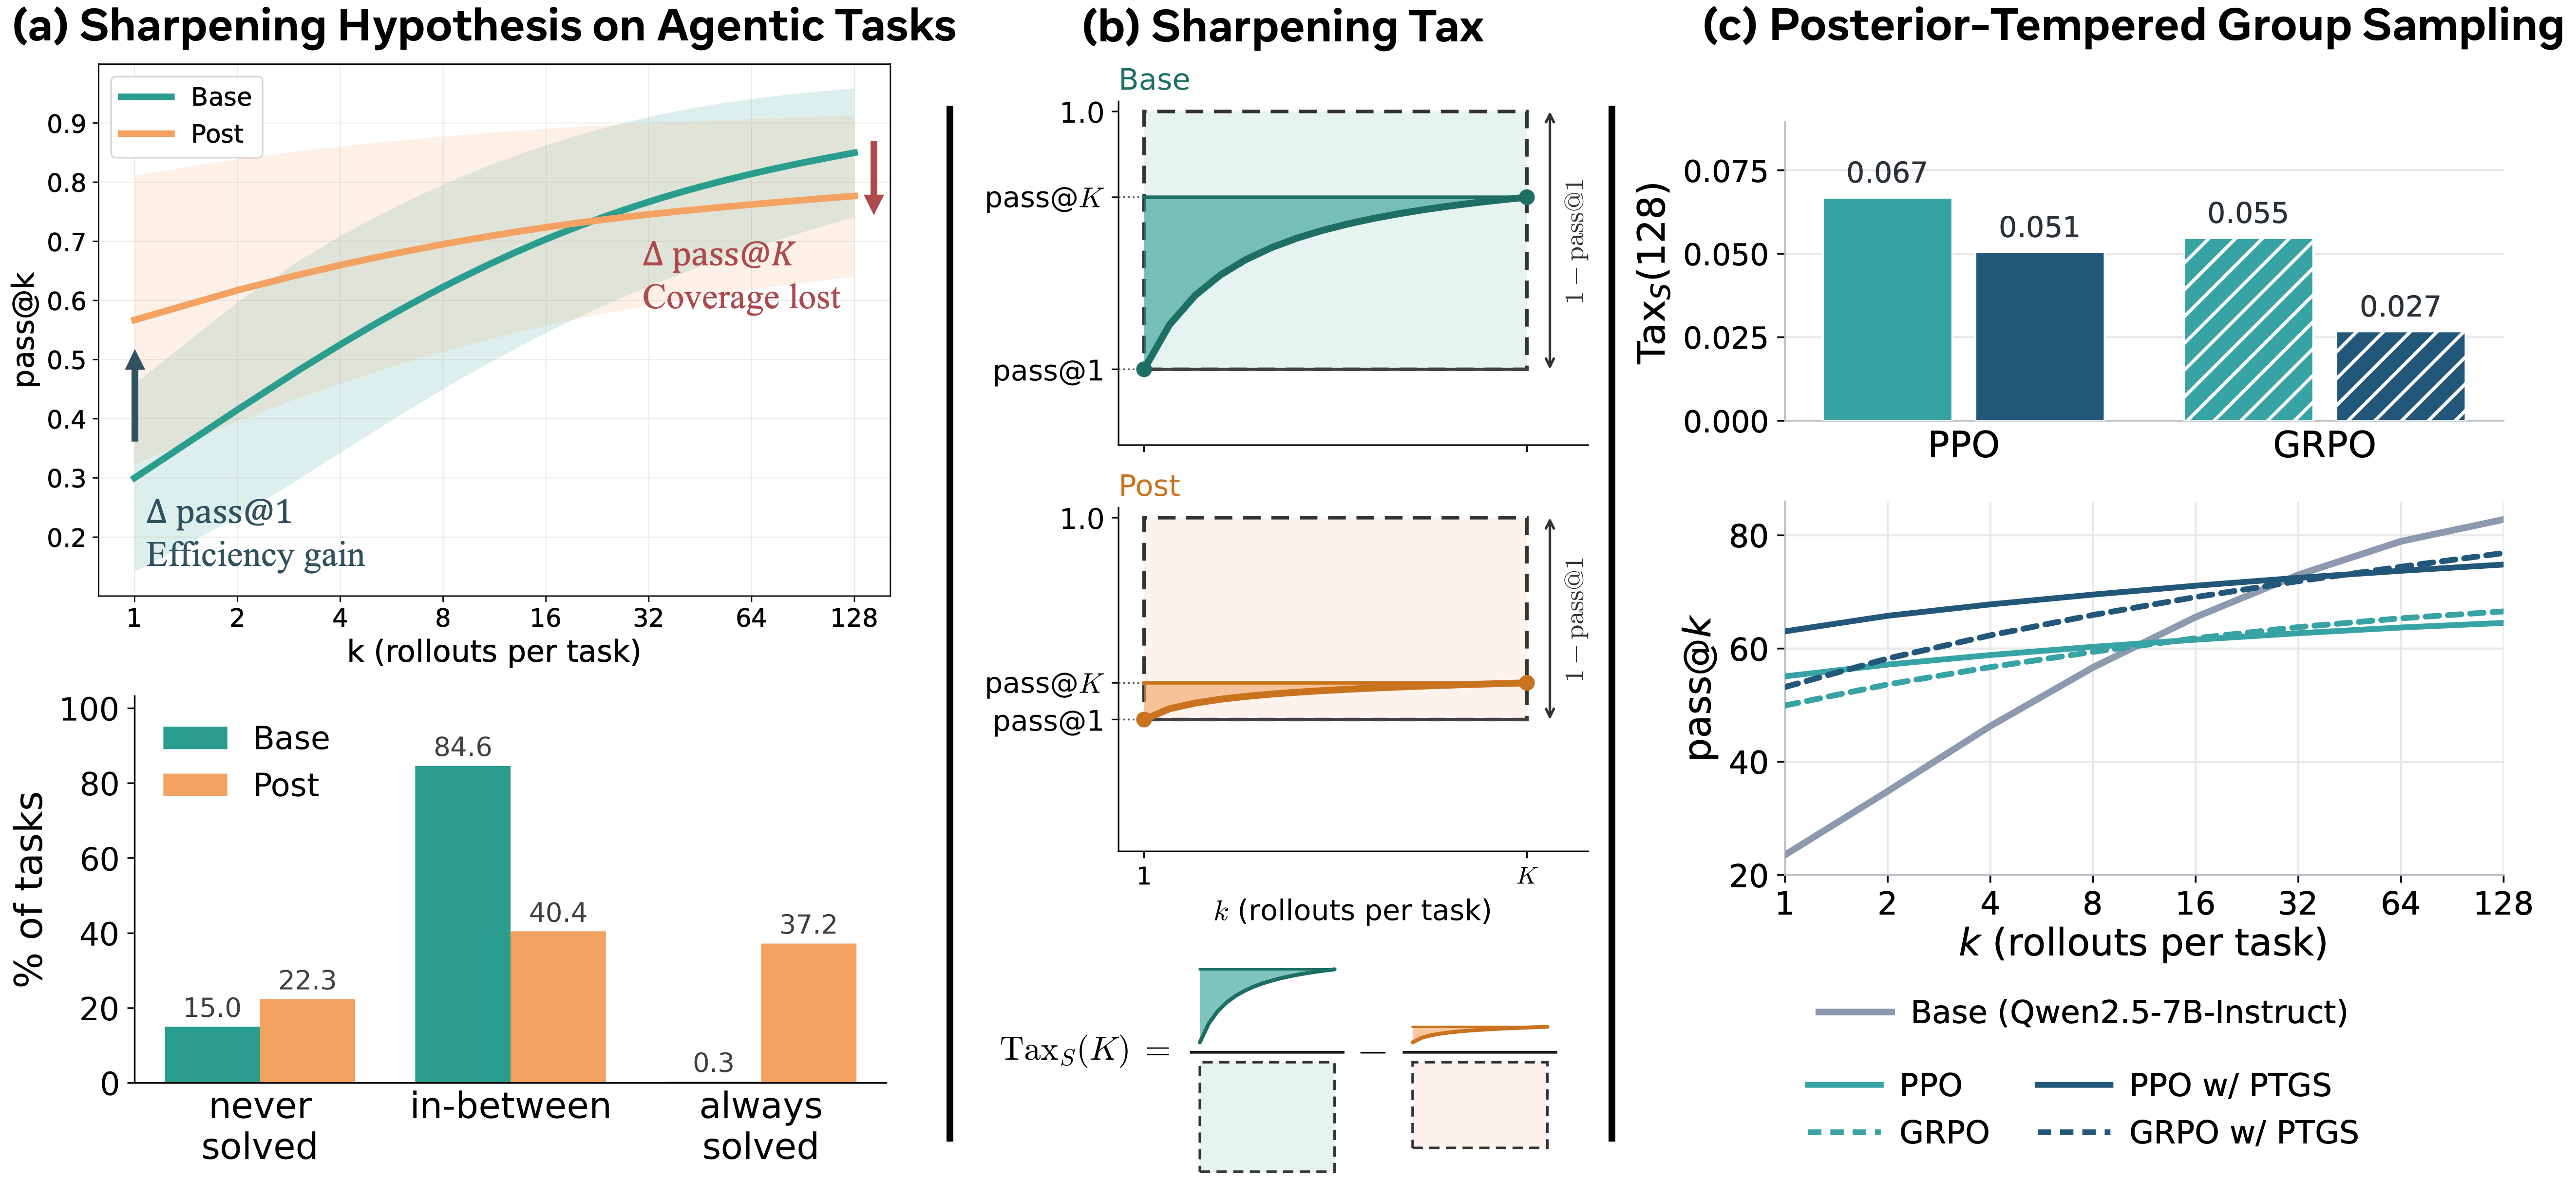
Дообученные модели чаще выигрывали при малом бюджете: они выбирали уже закреплённую успешную стратегию и меньше меняли поведение между запусками. Базовые модели ошибались чаще, но продолжали пробовать другие траектории, поэтому их охват рос быстрее. Чем крупнее была модель, тем раньше этот рост позволял обойти дообученную версию.
Самая наглядная деталь видна в распределении задач для Gemma-4-31B на WebShop. У базовой модели 87,6% задач иногда решались, а иногда нет; после дообучения доля таких задач упала до 30%. Одновременно доля задач, которые модель не решила ни разу, выросла с 12,4% до 44%.
Иными словами, дообучение не только закрепило правильные стратегии. Оно также усилило ошибочные предпочтения там, где модель изначально склонялась к неудачному пути. Повторный запуск такой модели воспроизводит похожую ошибку, а не исследует другой вариант.
Чтобы свести эффект к одному показателю, авторы предложили метрику Sharpening Tax. Она учитывает, как быстро растёт охват при добавлении попыток, нормирует этот рост с учётом исходной частоты ошибок и сравнивает базовую модель с дообученной. Высокий штраф означает, что после дообучения дополнительные вычисления при запуске приносят меньше новых решений.
Это не делает заострение поведения однозначно вредным. Если продукту нужен быстрый и предсказуемый ответ, высокая точность первой попытки полезнее разнообразия. Если можно выполнить несколько запусков и надёжно проверить итог, потеря охвата снижает предельное качество системы.
Командам стоит оценивать модель вместе с бюджетом запусков
Работа меняет план испытаний агентной системы. Сравнивать модели только по точности одного запуска недостаточно: тест должен включать кривую охвата при росте числа попыток. Иначе команда может выбрать более стабильную модель, которая лучше выглядит в обычном тесте, но раньше перестаёт находить новые решения.
Для задач с проверяемым результатом имеет смысл включить в испытания базовую контрольную точку с простой обвязкой. Это касается поиска по каталогу, работы с инструментами и других процессов, где несколько траекторий можно выполнить независимо, а затем отфильтровать. Работа не показывает, что базовая модель должна заменить дообученную везде: преимущество зависит от масштаба модели, задачи и доступного бюджета.
Авторы также предложили метод PTGS для самого обучения. Он оценивает сложность каждого запроса и повышает температуру выборки для трудных случаев, чтобы модель пробовала разные действия, а для простых снижает её и закрепляет найденное решение. Метод подключили к алгоритмам обучения с подкреплением PPO и GRPO в средах FrozenLake и Sokoban; он одновременно улучшил первую попытку и итоговый охват по сравнению с постоянной температурой.
Практический вывод не сводится к отказу от дообучения. Его нужно проектировать вместе с режимом запуска: заранее решить, требуется ли один устойчивый ответ или поиск хотя бы одной успешной траектории, а затем измерять именно этот режим. Sharpening Tax даёт для такого выбора диагностический показатель, но проверка пока ограничена открытыми семействами моделей и агентными тестами из работы.
Источники
Иллюстрация: рисунок из статьи «Sharpening Tax in Post-Training», Changdae Oh, Qi Zeng, Qi Qi и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


