
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
SheetAlign научил компактную локальную LLM надёжнее выполнять сложные правки в Excel-файлах. В нерецензированном препринте The University of Melbourne, где числа получены самими авторами, средняя доля правильных результатов Qwen3-4B выросла на SpreadsheetBench более чем вдвое. Работа предлагает архитектуру для локальных агентов, но достигнутой точности пока недостаточно, чтобы убрать проверку результата человеком или программными правилами.
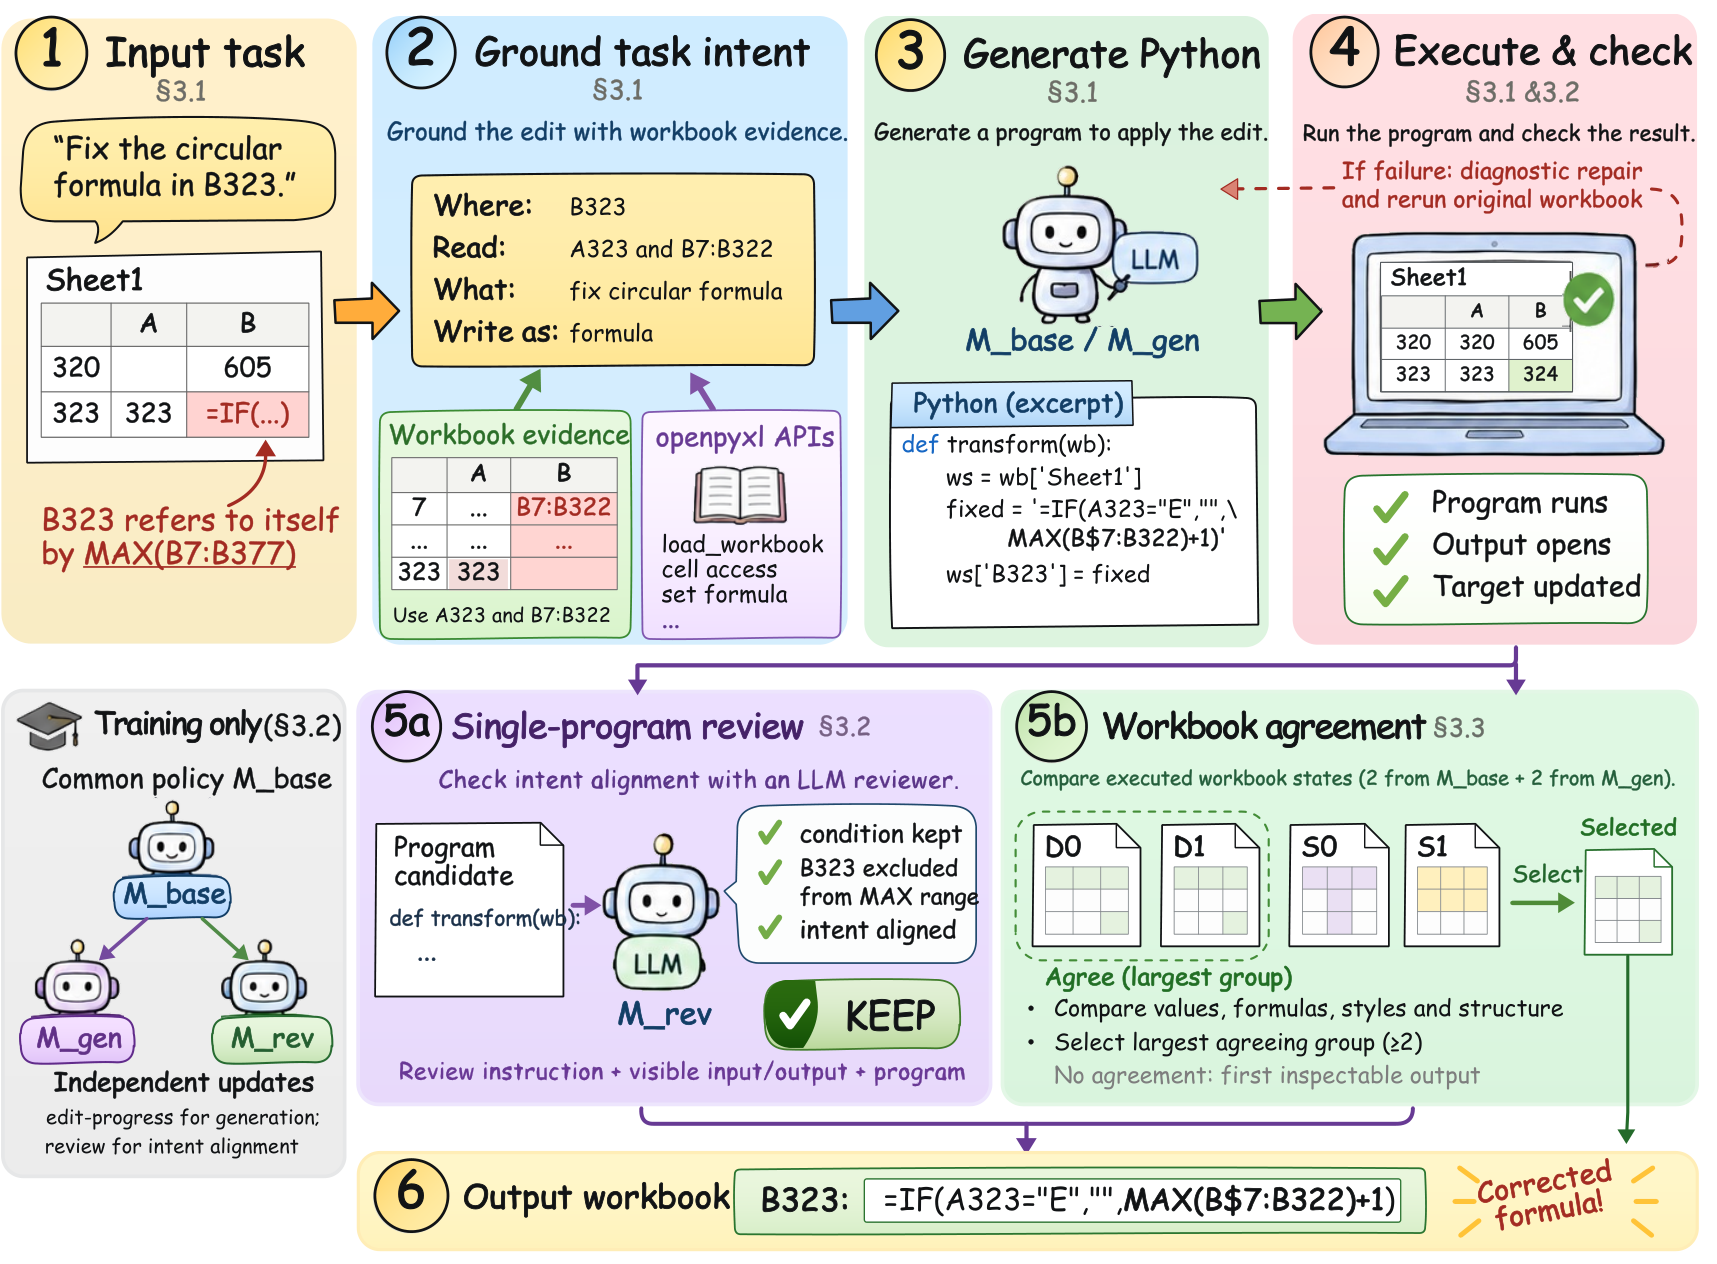
Агент сначала связывает запрос с конкретными областями книги
Обычный агент может написать исполняемый код и всё равно изменить не те ячейки. SheetAlign поэтому разделяет задачу на три вопроса: где работать, что менять и как выполнить преобразование.
Перед генерацией кода модель составляет краткий план. В нём она отмечает целевой диапазон, исходные данные, требуемое изменение, тип результата и нужные возможности openpyxl. Затем среда показывает модели не всю книгу, а связанные с задачей заголовки, ячейки, формулы и объединённые области.
Такой интерфейс привязывает программу к текущему состоянию файла. Вместо общего запроса «рассчитать итог» модель видит, из каких столбцов брать данные, куда записывать формулу и какие методы API для этого подходят. При этом агент не ограничен набором заранее заданных действий: он по-прежнему пишет Python-код.
После запуска среда проверяет, открылся ли изменённый файл и завершилась ли программа без ошибки. Если код упал или создал некорректную книгу, модель получает короткое описание проблемы и исправляет программу, каждый раз начиная с исходного файла. Эта проверка ловит технические сбои, но не гарантирует, что исполняемый код правильно понял намерение пользователя.
Генерацию и проверку обучают раздельно, а результат выбирают по состоянию файла
SheetAlign использует две политики на основе одной исходной модели. Первая пишет программу, вторая получает уже исполняемый код вместе с фрагментами исходной и изменённой книг и решает, сохранить его или исправить. Их обучают независимо, чтобы проверяющая политика не перенимала привычку генератора подтверждать собственное решение.
Награда учитывает не только полный успех задачи, но и прогресс по отдельным правкам. Она повышается, когда программа выполняет требуемые изменения, и снижается, когда затрагивает лишние ячейки. Такой сигнал помогает различать почти готовое решение и программу, которая успешно запустилась, но изменила лишь малую часть нужного.
На запуске система создаёт несколько программ с помощью общей и специализированной политик. Для каждой получившейся книги она строит отпечаток из структуры листов, адресов ячеек, значений, формул и форматирования. Если разные программы привели книгу к одному состоянию, система выбирает кандидата из крупнейшей совпавшей группы, после чего передаёт его проверяющей политике.
На SpreadsheetBench один лишь привязанный к книге интерфейс поднял среднюю точность с 13,5% до 29,2% без обучения. Раздельное обучение довело её до 30,4%, а выбор по согласованности результатов — до 32,8%. На Domain-Spreadsheet полный вариант набрал 30,1%; сравнение первого подходящего кандидата с несколькими согласованными результатами показывает, что часть выигрыша даёт дополнительное вычисление при запуске, а не только обучение.
Архитектуру можно брать в продукт, автономность — пока нет
Работу проверяли на двух наборах задач. SpreadsheetBench содержит сложные правки реальных книг и оценивает связанные экземпляры одной задачи, а Domain-Spreadsheet охватывает финансы, поставки, кадры, продажи и недвижимость. Результат сравнивали как с закрытыми системами, так и с агентами на открытых моделях; отдельно сопоставили варианты на том же Qwen3-4B-Thinking-2507.
Все преобразования выполнялись через Python и openpyxl, а итоговые книги пересчитывались в Microsoft Excel и сравнивались с эталонами официальным инструментом. Поэтому выводы напрямую относятся к агентам, которые правят файлы программно. Для специальных возможностей Excel и внешних интеграций потребуются дополнительные инструменты, а ограниченный просмотр фрагментов книги придётся адаптировать к особенно крупным и сложным файлам.
Для продуктовой команды практический вывод состоит из двух частей. Привязку запроса к областям книги, отдельную проверку исполняемого кода и сравнение итоговых состояний можно закладывать в архитектуру уже сейчас. Но агент должен работать внутри контролируемого процесса: с проверкой допустимых диапазонов, сохранением исходного файла, журналом изменений и подтверждением критичных операций.
Выбор среди нескольких программ повышает качество ценой повторных генераций и запусков кода. Такой подход подходит для фоновой обработки книг и задач, где ошибка дороже дополнительной задержки; для интерактивного редактирования потребуется отдельно измерить время ответа и вычислительную стоимость. Код планируют открыть после публикации, поэтому перенести заявленный результат в собственную инфраструктуру до этого будет сложнее.
Источники
Иллюстрация: рисунок из статьи «SheetAlign: Grounded Interaction and Stage-Isolated Learning for Spreadsheet Agents», Yuxiang Wang, Junhao Gan, Jianzhong Qi, CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


