
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
LLM-агент научили находить решения за пределами версий, которые он уже рассматривает. В работе Stanford University SHELDON обошёл другие агентные подходы на задачах диагностики, абстрактного рассуждения и оптимизации вплоть до 26,7 пункта, хотя работа не рецензирована и числа в ней получили сами авторы. Для команд это повод разделить в архитектуре поиск решений и поиск новых фактов, а не просто запускать больше параллельных кандидатов.
Почему поиск вокруг текущей версии застревает
Обычный агент сначала предлагает гипотезу, затем ищет подтверждающие или опровергающие её данные. Следующую гипотезу он строит по накопленной истории. Даже если агент ведёт несколько веток, каждая ветка направляет сбор фактов в область, которую уже считает перспективной.
Из-за этого система хорошо улучшает известные решения, но редко замечает неизвестную область поиска. Несколько кандидатов могут исходить из одной неверной предпосылки. Сравнение между ними не обнаружит проблему, если ни один кандидат не заставил агента проверить эту предпосылку.
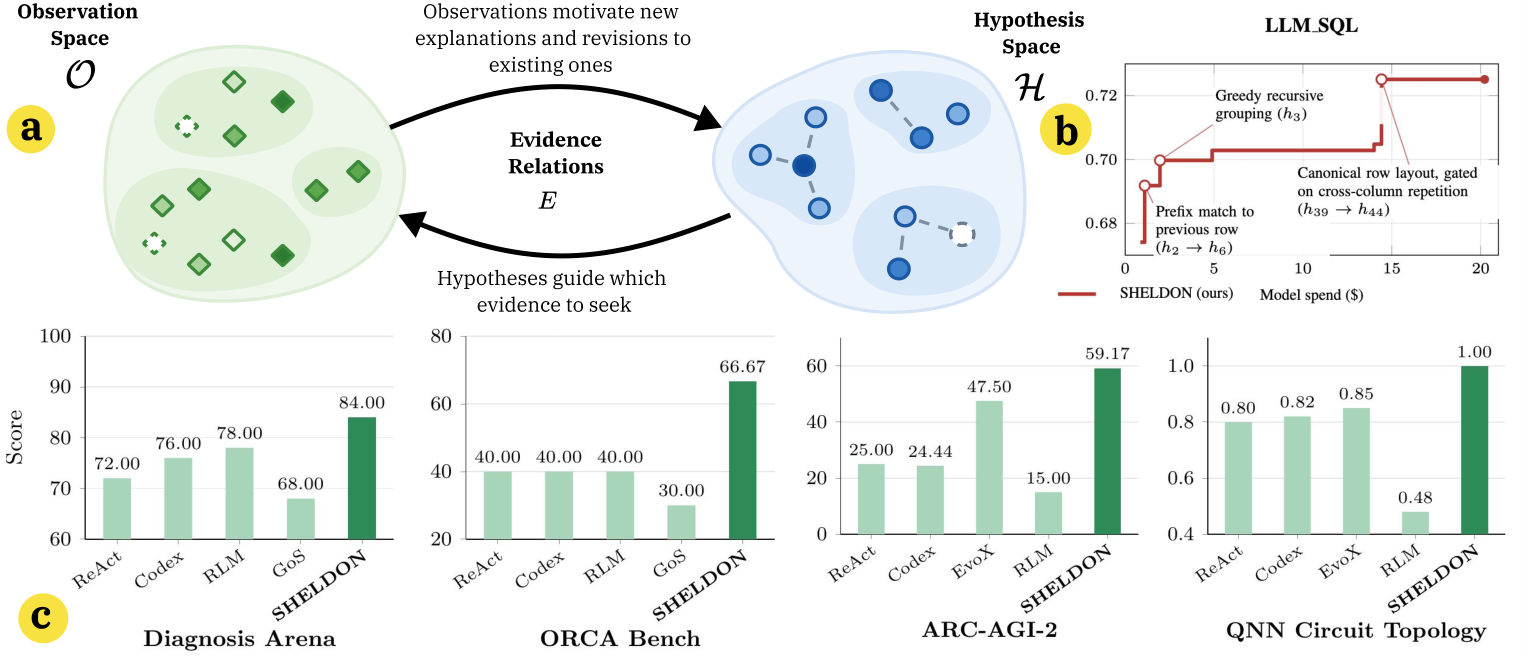
SHELDON хранит раздельно пространство гипотез и пространство наблюдений. Гипотезой может быть причина сбоя, диагноз, правило преобразования или вариант конструкции. Наблюдением система считает результат поиска, проверки журнала, запуска программы, эксперимента или обращения к другому доступному инструменту.
Оба пространства разбиты на направления и области. Для гипотез это могут быть семейства методов и разные исходные предположения, для наблюдений — источники данных, периоды времени, сущности или режимы поведения. Пустая область наблюдений становится явным указанием, где агент ещё ничего не проверял.
Как наблюдения меняют направление поиска
Рабочий цикл состоит из исследования пространства, проверки отдельных гипотез, их совместного сравнения и отбора наиболее перспективных вариантов. На каждом круге агент ищет не только доказательства для конкретного кандидата, но и тесты, которые различают сразу несколько кандидатов или обнаруживают общий для них пробел.
Связь между наблюдением и гипотезой получает один из статусов: поддерживает, опровергает, нейтрально или ещё не оценено. Новое наблюдение сначала считается предварительным. Оно может подсказать следующую проверку, но не может само по себе отбросить гипотезу, пока система не встретит его повторно.
Наблюдения не принадлежат одной ветке. Факт, найденный при проверке одной причины, может опровергнуть другую или породить гипотезу в новой области. В примере с системным инцидентом агент связал время появления ошибок оплаты с отдельным сообщением о неверном токене и сформировал новую версию, которой не было среди исходных веток.
Поиск продолжается, пока остаётся бюджет, появляются новые направления или не достигнут предел в восемь раундов. В конце агент заново оценивает накопленные связи и выбирает решение, которое лучше всего согласуется с фактами и доступной функцией оценки.
Когда подход стоит закладывать в архитектуру
Самый заметный эффект связан не только с итоговым баллом. SHELDON создавал до 4,5 раза больше новых решений, чем сравниваемые подходы. На задаче проектирования квантовой нейронной сети он получил максимальный балл 1,00 против 0,85 у сильнейшего агентного варианта и 0,917 у написанной человеком эталонной конструкции. Если убрать отдельное пространство наблюдений, результат на DiagnosisArena падал на 14 пунктов.
Подход проверяли на DiagnosisArena и ORCA-Bench для поиска причин, ARC-AGI-2 для абстрактных правил, а также на задачах оптимизации QNN и ADRS. В части задач агент видел численную функцию качества, в части должен был оценивать версии по собранным свидетельствам. Медицинские опыты проходили только на контролируемом бенчмарке и не показывают пригодность системы для клинических решений.
Работа меняет планы команд, которые строят долгие агентные исследования с несколькими возможными объяснениями и доступом к журналам, исполнению кода, симуляторам или базам данных. Для такого продукта одного дерева гипотез недостаточно: полезно хранить наблюдения как самостоятельные объекты, связывать их со всеми кандидатами и отдельно планировать проверки общих предпосылок.
Перестраивать короткие сценарии с заранее известной последовательностью действий по этой работе оснований нет. Дополнительный контур нужен там, где агент может получить неожиданный факт и на его основе сменить направление, а не только уточнить текущий ответ.
Практический прототип можно начать без полного воспроизведения SHELDON: разделить состояние агента на кандидаты и проверенные факты, разрешить одному факту влиять на несколько кандидатов и добавить отдельный этап поиска теста, который различает конкурирующие версии. После этого стоит сравнить систему с текущим агентом на одинаковых задачах и бюджете инструментальных вызовов.
Источники
Иллюстрация: рисунок из статьи «SHELDON: Reasoning through Dual Search over Hypothesis and Observation Spaces», Harshit Joshi, Priyank Shethia, Monica S. Lam, CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


