
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Новый тест показал, что агент может выдать правдоподобный результат и всё же провалить рабочий процесс: пропустить проверку, нарушить порядок действий или не соблюсти формат. В препринте команды из MBZUAI, City University of Hong Kong, WeChat AI, Tencent и McGill — Mila, который не прошёл рецензирование и приводит замеры самих авторов, даже Opus 4.8 строго выполнил меньше половины заданий. Для команд, внедряющих агентов, это сдвигает приёмку с проверки конечного файла на проверку всего хода работы.
Спецификация навыка связывает задание с проверкой
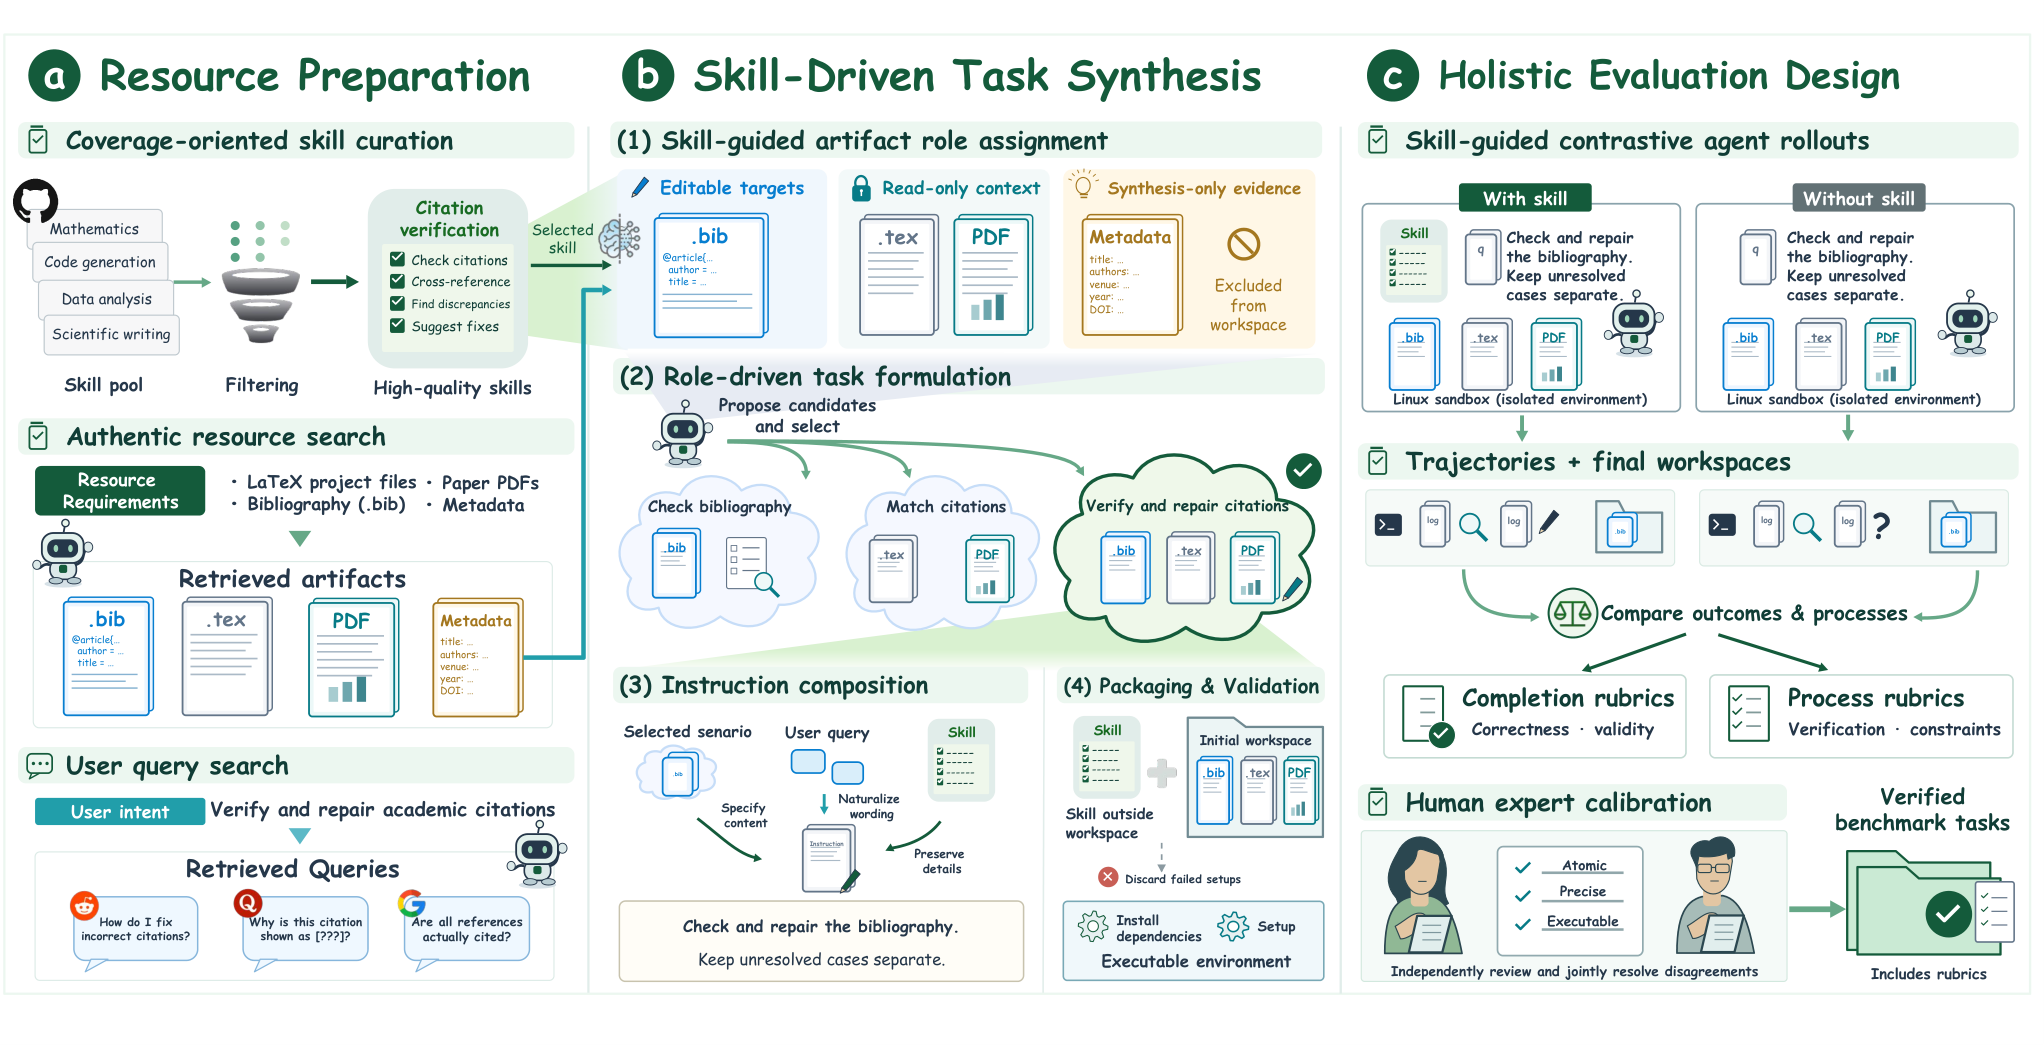
SkillForgeBench строится вокруг спецификации навыка — инструкции, которая описывает профессиональный процесс, обязательные шаги, ограничения и ожидаемый результат. Обычный тест часто задаёт агенту цель и проверяет итоговый файл. Здесь одна и та же спецификация определяет исходные материалы, само задание и критерии оценки.
Авторы собрали 842 задания из пяти областей: технологии, бизнес, творчество, поведение агентной системы и работа со знаниями. Каждому заданию соответствует отдельный навык. Материалы брали из открытых источников, а формулировки пользовательских запросов — из обсуждений на публичных площадках.
Файлы внутри задания получают разные роли. Одни агент может редактировать, другие дают ему контекст только для чтения, третьи содержат эталонные сведения и остаются скрытыми. Например, в задаче на проверку библиографии агент исправляет файл со ссылками, сверяется со статьями, но не видит подготовленный набор правильных метаданных.
Задания запускаются в изолированных Linux-контейнерах. Сценарии, которым нужны постоянные внешние сервисы или которые нельзя воспроизводимо собрать, отбрасывают. Поэтому тест охватывает сложную работу с файлами и инструментами, но его выводы относятся прежде всего к локально исполнимым процессам.
Критерии делятся на две группы. Первая проверяет конечный результат: структуру файла, корректность содержания и соблюдение формата. Вторая проверяет последовательность действий: выполнил ли агент обязательные этапы, сверил ли промежуточный результат и остался ли в заданных границах.
Чтобы получить такие критерии, эталонный агент выполняет одно задание со спецификацией навыка и без неё. Разница между результатами и последовательностями действий помогает выделить требования, которые добавляет инструкция. Эксперты затем разбивают составные правила на отдельные проверяемые условия и для каждого задают однозначный порог прохождения.
Строгая оценка обнаружила ошибки за правдоподобным результатом
На SkillForgeBench проверили восемь закрытых и открытых агентов. При покритериальной оценке модели выполняли до 85,7% отдельных требований. Такой показатель выглядит высоким, но он позволяет компенсировать пропущенную проверку правильно оформленным файлом.
Строгая оценка не усредняет успехи: задание засчитывается только тогда, когда агент выполнил все обязательные требования. Лучший результат показал Opus 4.8 — 40,9%. Остальные модели расположились ниже, а значит, даже лидер чаще проваливал хотя бы одно условие, чем проходил задачу полностью.
Разрыв особенно заметен при проверке процесса. Агенты сравнительно часто создавали файл, который можно открыть и изучить, но хуже соблюдали порядок этапов, правила предметной области и циклы проверки. Haiku 4.5 выполнил все процессные требования менее чем в 3% заданий.
Это объясняет, почему проверка только конечного состояния рабочего каталога переоценивает автономность. Итог может выглядеть приемлемо, хотя агент не сверил данные, вышел за разрешённую область изменений или пропустил обязательный этап. В производственном процессе каждое такое нарушение возвращает задачу человеку.
Планы меняются на уровне приёмки и выбора модели
Работа предлагает практичную схему для внутренних испытаний: использовать одну спецификацию и как инструкцию агенту, и как источник критериев. Тогда тест не сводится к сравнению ответа с эталоном. Он проверяет события в журнале действий, промежуточные состояния и финальный артефакт.
Спецификация при этом не компенсирует слабую базовую модель. Доступ к ней увеличил долю полностью пройденных заданий у Opus 4.8 на 19,2 процентного пункта, а у Haiku 4.5 — на 5,8. Более способный агент лучше превращает подробную инструкцию в дисциплинированное выполнение процесса.
Поэтому план «взять недорогую модель и подробно расписать ей шаги» требует отдельной проверки на реальных сценариях продукта. Инструкция помогает, но эффект зависит от способности модели удерживать ограничения на протяжении всей задачи. Сравнивать кандидатов стоит по доле заданий, где соблюдены все обязательные условия, а покритериальную оценку использовать для диагностики причин провала.
Подход полезен и при создании собственного набора испытаний. Команда может начать с критичных рабочих инструкций, подобрать реальные обезличенные материалы, скрыть эталонные данные и разделить проверки результата и процесса. Такой набор покажет не только способен ли агент получить нужный файл, но и сколько задач действительно можно передать ему без последующей ручной проверки каждого шага.
Источники
Иллюстрация: рисунок из статьи «SkillForgeBench: Evaluating Agent Reliability Grounded in Agent Skill Specifications», Zhengxi Li, Junyi Zhou, Qiyuan Zhang и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


