
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
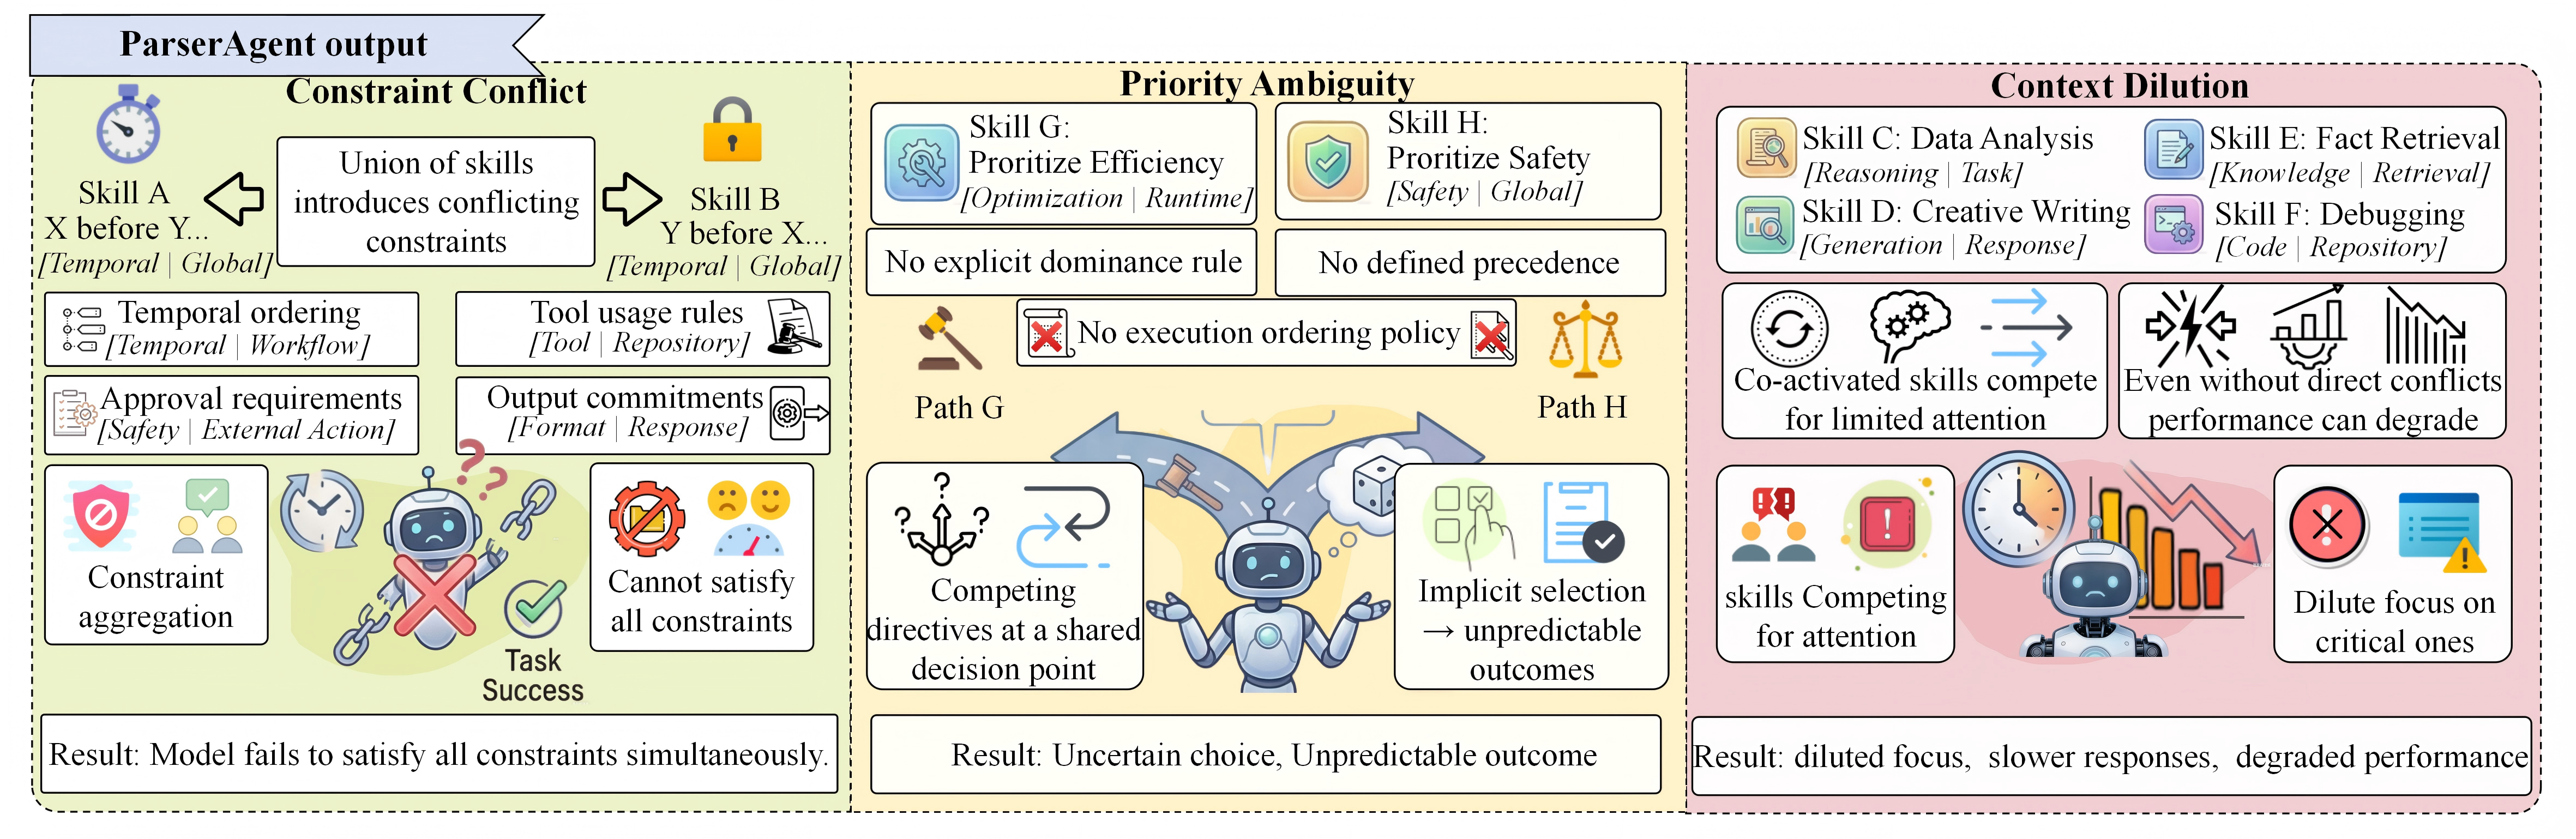
Независимо написанные навыки LLM-агента можно заранее свести в единый набор инструкций, который явно разрешает конфликты до запуска задачи. В препринте команды Zhejiang University, Nanjing University, Nanyang Technological University и City University of Hong Kong объединённый навык дал более чем в 2,5 раза выше долю успешных решений при самой большой проверенной нагрузке, хотя работа не рецензирована, а числа получили сами авторы. Для архитектуры агента это добавляет отдельный этап между выбором навыков и выполнением задачи.
Как компилятор разбирает инструкции
Навыком здесь называют пакет с файлом SKILL.md, инструкциями, исполняемыми сценариями, вспомогательными материалами и описанием для поиска. Проблема возникает, когда агент одновременно загружает несколько таких пакетов: один требует применять библиотеку, другой запрещает внешние зависимости, а третий повторяет часть уже загруженных правил.
SkillFusion работает до выполнения пользовательской задачи. Он разбирает каждый навык на минимальные требования, определяет их тип и условия применения, а также сохраняет связь с исходной инструкцией. Условие позволяет отличить настоящее противоречие от правил для разных этапов работы: например, одна библиотека может использоваться для редактирования таблицы, а другая инструкция — только для её проверки.
Сначала компилятор отбирает пары требований с близким типом и пересекающимися условиями. Затем он возвращает в рассмотрение пары, которые фильтр мог пропустить из-за неуверенной классификации, общего условия или смыслового сходства. В ручной проверке такой возврат восстановил 14 из 24 конфликтующих пар, потерянных строгим фильтром.
Классификатор делит взаимодействия на жёсткие конфликты, конкурирующие предпочтения, повторы и совместимые требования. Неуверенные решения повторно проверяет второй агент с задачей найти ошибку в первом выводе.
Способ объединения зависит от класса. Для жёсткого конфликта компилятор задаёт условный маршрут или явный приоритет. Конкурирующие предпочтения он заменяет общей формулировкой и проверяет её против исходных требований. Повторы сокращает до наиболее точной инструкции. Готовый пакет сохраняет сценарии, ресурсы и описание, по которому агент находит навык.
Где объединённый навык выиграл у переписывания
SkillFusion проверили на SpreadsheetBench Verified, WebArena-Verified и SWE-bench Verified — наборах задач для электронных таблиц, браузера и разработки программ. Во всех случаях он показал лучшую среднюю долю успешно выполненных задач среди методов, которым заранее не известен подходящий навык.
По сравнению с подходом Rewrite–Critique–Revise, который переписывает инструкции, критикует результат и исправляет его, преимущество составило 4,8 процентного пункта на таблицах, 4,0 пункта в браузере и 3,8 пункта в программировании. Разница статистически значима. Результат указывает, что свободного редактирования общего текста недостаточно: полезны явные решения по каждой конфликтующей паре и проверка против исходных правил.
Компилятор работал на DeepSeek-V3.2, после чего один и тот же готовый пакет передавали разным моделям-исполнителям без повторной сборки. Преимущество сохранилось на GLM-4.7 и MiniMax-M2.5. Это отделяет подготовку инструкций от модели, которая непосредственно выполняет задачу.
При росте числа требований необработанная загрузка нескольких навыков ухудшалась быстрее, чем заранее собранный пакет. Контролируемые опыты на HumanEval+ также показали, что результат портят не только прямые противоречия: повторяющиеся инструкции и конкурирующие предпочтения сами по себе отвлекают модель от задачи.
Когда стоит менять архитектуру агента
Работа меняет планы команд, которые уже выбирают навыки из библиотеки, но затем просто складывают их инструкции в контекст модели. В такой схеме разрешение конфликтов неявно поручено исполнителю. SkillFusion предлагает сделать его отдельным проверяемым этапом: маршрутизатор выбирает нужные навыки, компилятор объединяет их, исполнитель получает один согласованный пакет.
Подход особенно подходит для повторяющихся сочетаний навыков. Пакет собирают один раз для определённого набора и затем используют во многих задачах или с несколькими моделями. Связи с исходными требованиями позволяют проверить, какое правило сохранилось, было сокращено или получило приоритет — это полезнее свободного переписывания, где отдельное требование легко потерять незаметно.
Практические границы задаёт сама проверка: использовались публичные навыки, фиксированные наборы задач для таблиц, браузера и программирования, а рост сложности изучали на синтетических инструкциях для HumanEval+. Поэтому результат поддерживает изменение конвейера агента, но не доказывает надёжность конкретной сборки в производственном процессе.
Компиляция также не заменяет контроль доступа, изоляцию исполнения и человеческое подтверждение опасных действий. Модель может неверно определить область применения правила или синтезировать ошибочную инструкцию. Для критичных процессов итоговый пакет стоит проверять как обычный исполняемый артефакт, а не считать безопасным только потому, что конфликты обработаны заранее.
Источники
Иллюстрация: рисунок из статьи «SkillFusion: Towards Reliable Multi-Skill Composition for LLM Agents», Enhao Huang, Xinye Zhao, Yiming Li и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


