
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Маленькие языковые модели можно заставить реже ошибаться, если вовремя передавать сложные запросы более сильной модели. В препринте, который не прошёл рецензирование и содержит замеры самого автора, такая маршрутизация повысила точность на отдельных задачах на 50 процентных пунктов. Экономии вычислений метод не даёт: он помогает тратить их на запросы, с которыми первая модель не справляется.
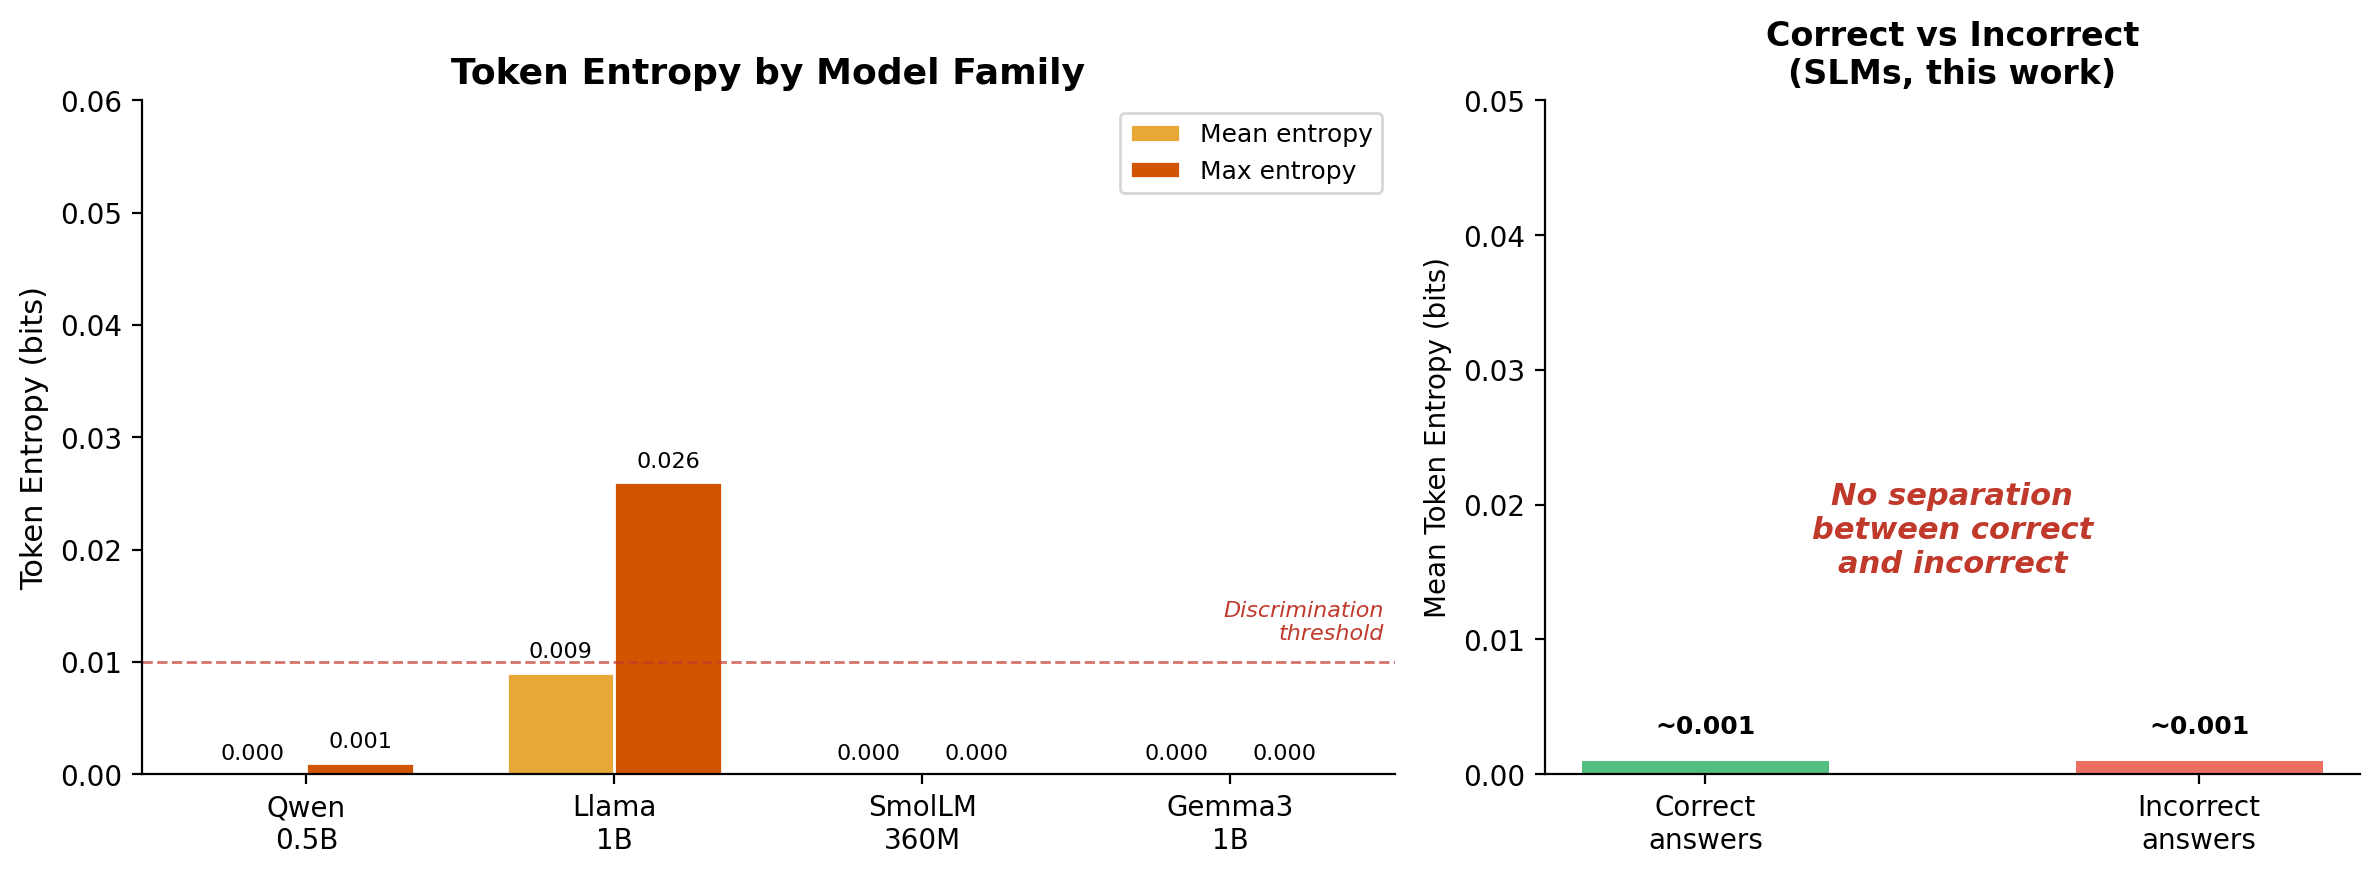
Обычный сигнал уверенности здесь не сработал. Токенная энтропия показывает, насколько широко модель распределяет вероятность между вариантами следующего токена. В 91% сочетаний модели и набора задач она оставалась почти нулевой и для правильных, и для ошибочных ответов: маленькая модель столь же уверенно выбирала неверные «A», «Yes» или «No».
Полезный сигнал появился на уровне смысла ответа. Модель запускали пять раз, группировали совпадающие по смыслу результаты и измеряли расхождение между группами. Если ответы расходились сильнее порога, запрос уходил более крупной модели; если совпадали, система принимала самый частый вариант.
Качество второй модели оказалось важнее принадлежности к тому же семейству. Маршрутизация между разными семействами в среднем прибавила 22 процентных пункта точности, а внутри одного семейства — 6,8. Но схема работает не всегда: Gemma3-1B повторяла одни и те же неверные ответы, поэтому расхождение между попытками не возникало и переключение не срабатывало.
Метод проверяли на семи парах моделей из семейств Qwen, Llama, SmolLM и Gemma с более крупными экспертами. В тест вошли BoolQ, HellaSwag, ARC-Challenge, ARC-Easy и WinoGrande; на каждое сочетание пришлось от 20 до 50 примеров. Все запуски выполняли без квантования на компьютере с Apple Silicon, поэтому результаты описывают локальный сценарий, но небольшие различия на таком масштабе нельзя считать подтверждёнными.
Для архитектуры продукта вывод узкий: токенную энтропию маленькой модели не стоит использовать как единственный переключатель. Несколько независимых ответов дают более полезный сигнал, однако всегда расходуют больше токенов и иногда вызывают вторую модель. Такая каскадная схема подходит там, где точность важнее минимальной стоимости каждого запроса.
Источники
Иллюстрация: рисунок из статьи «Do small language models know what they don't know?», Prashant Mudgal, CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


