
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Диффузионные языковые модели научились квантовать без набора примеров для калибровки. Работа University of Southern California, Yale University и Korea University, которую ещё не рецензировали, приводит замеры самих авторов: с SoloQ полный цикл вывода ускорился до 2,24 раза. Команда может убрать отдельный этап подбора калибровочных данных, но выигрыш в скорости зависит от поддержки NVFP4 на целевом оборудовании.
Почему калибровка плохо переносится между задачами
Обычная языковая модель генерирует текст слева направо. Диффузионная модель начинает с замаскированной последовательности и за несколько проходов восстанавливает токены, используя контекст с обеих сторон.
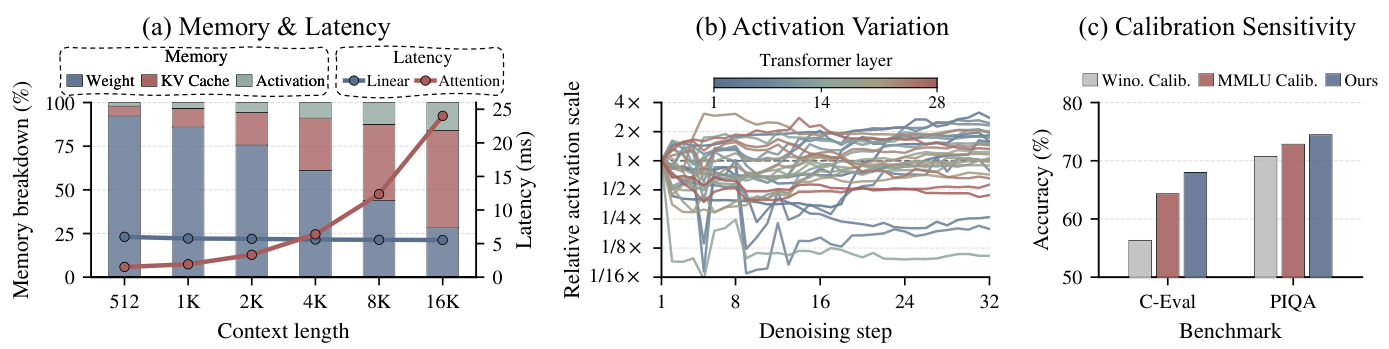
Распределение значений внутри модели при этом меняется от шага к шагу. Оно зависит от доли уже раскрытых токенов, положения масок и текущего этапа очистки последовательности. Калибровочная выборка фиксирует лишь часть этих состояний, поэтому параметры квантования, подобранные на одной задаче, могут хуже работать на другой.
Проблема затрагивает не только веса. Диффузионная модель многократно обрабатывает активации, а блочные варианты дополнительно хранят кэш ключей и значений для уже завершённых блоков. Сжатие одних весов оставляет заметную часть затрат на вычисления и память без изменений.
SoloQ меняет саму постановку задачи: вместо попытки измерить каждое меняющееся распределение метод сначала преобразует данные в форму с заранее предсказуемыми свойствами. Поэтому ему не нужны примеры запросов, накопленная статистика активаций или обучение дополнительных параметров.
Как поворот заменяет калибровочную выборку
SoloQ нормализует векторы и поворачивает их так, чтобы отдельные координаты подчинялись распределению, близкому к гауссовскому. После такого преобразования крупные выбросы распределяются между координатами, а квантователь можно настроить по известной форме распределения, а не по собранным данным.
Для поворота используется K-RPBH. Сначала он случайно переставляет координаты и перемешивает их внутри блоков преобразованием Адамара, затем перераспределяет энергию между блоками. Второй шаг нужен для слоёв, чья ширина разбивается на много блоков: простое локальное перемешивание может оставить одним блокам больше крупных значений, чем другим.
Веса поворачиваются заранее и сохраняются уже в преобразованном виде. Активации приходится поворачивать во время вывода. Небольшая поправка масштаба после квантования восстанавливает длину вектора, которую низкая разрядность может исказить.
У метода есть два варианта. SoloQ-C использует кодовые книги, подобранные под ожидаемое распределение: более сложный поиск выполняется для весов заранее, а для активаций применяется дешёвое скалярное преобразование. SoloQ-N записывает значения в аппаратный формат NVFP4 и вычисляет масштабы непосредственно из текущего тензора. Отсутствие калибровки здесь не означает отсутствие масштабов: они рассчитываются во время обработки данных, а не извлекаются из заранее прогнанной выборки.
В блочных моделях SoloQ сжимает кэш только после того, как блок завершён. Активный блок остаётся в полной точности, пока модель меняет его токены. Это отделяет часто обновляемые данные от постоянного состояния и не вносит ошибку квантования в текущий цикл очистки.
Когда SoloQ меняет план развёртывания
Проверка охватила полнопоследовательные модели семейств LLaDA и Dream, а также блочные Fast-dLLM v2 и Nemotron-Labs-Diffusion. Их сравнивали с калибровочными методами на задачах проверки знаний и рассуждений. Замеры производительности запускали с оптимизированными ядрами на NVIDIA H200 и RTX Pro 6000, поэтому результаты описывают конкретные реализации, а не любой сервер с GPU.
При квантовании весов и активаций до 4 бит SoloQ сохранял качество и на ряде тестов обходил методы, которым нужна калибровочная выборка. В варианте NVFP4 пиковое потребление памяти сократилось до 2,61 раза относительно BF16. Для блочных моделей часть экономии дала компрессия постоянного кэша, поэтому преимущество должно расти вместе с длиной контекста.
Работа меняет план команд, которые уже рассматривают диффузионную модель и контролируют оборудование для вывода. Вместо подготовки калибровочного корпуса можно сразу проверять преобразование на целевых задачах, а один и тот же механизм применять к весам, активациям и кэшу.
Переносить заявленное ускорение в расчёт инфраструктуры без собственного прогона рано. Быстрый вариант опирается на аппаратную поддержку NVFP4, а онлайн-поворот добавляет вычисления. Практический тест должен отдельно измерять качество, максимальную память и задержку на нужной длине контекста: SoloQ убирает зависимость от калибровочных данных, но не от архитектуры модели и GPU.
Источники
Иллюстрация: рисунок из статьи «SoloQ: Calibration-Free Quantization for Diffusion Language Models», Donghyun Lee, Arkapravo Ghosh, Varun Manjunath и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


