
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Языковую модель можно обучить не реагировать на дальний шум, если ближайшего текста уже хватает для предсказания следующего токена. В работе Jinchang Zhu и его коллег, которая не прошла рецензирование и содержит замеры самих авторов, SPAR улучшил средний результат RULER на всех проверенных базовых моделях — от 0,33 до 3,43 пункта. Метод не меняет архитектуру, поэтому его можно рассматривать как дополнение к предварительному или дальнейшему обучению моделей с длинным контекстом.
Как SPAR отделяет полезный контекст от помех
Обычная причинная языковая модель учится предсказывать следующий токен по всему предшествующему тексту. Такая целевая функция поощряет использование полезного контекста, но прямо не учит модель игнорировать далёкие фрагменты, которые не нужны для текущего предсказания.
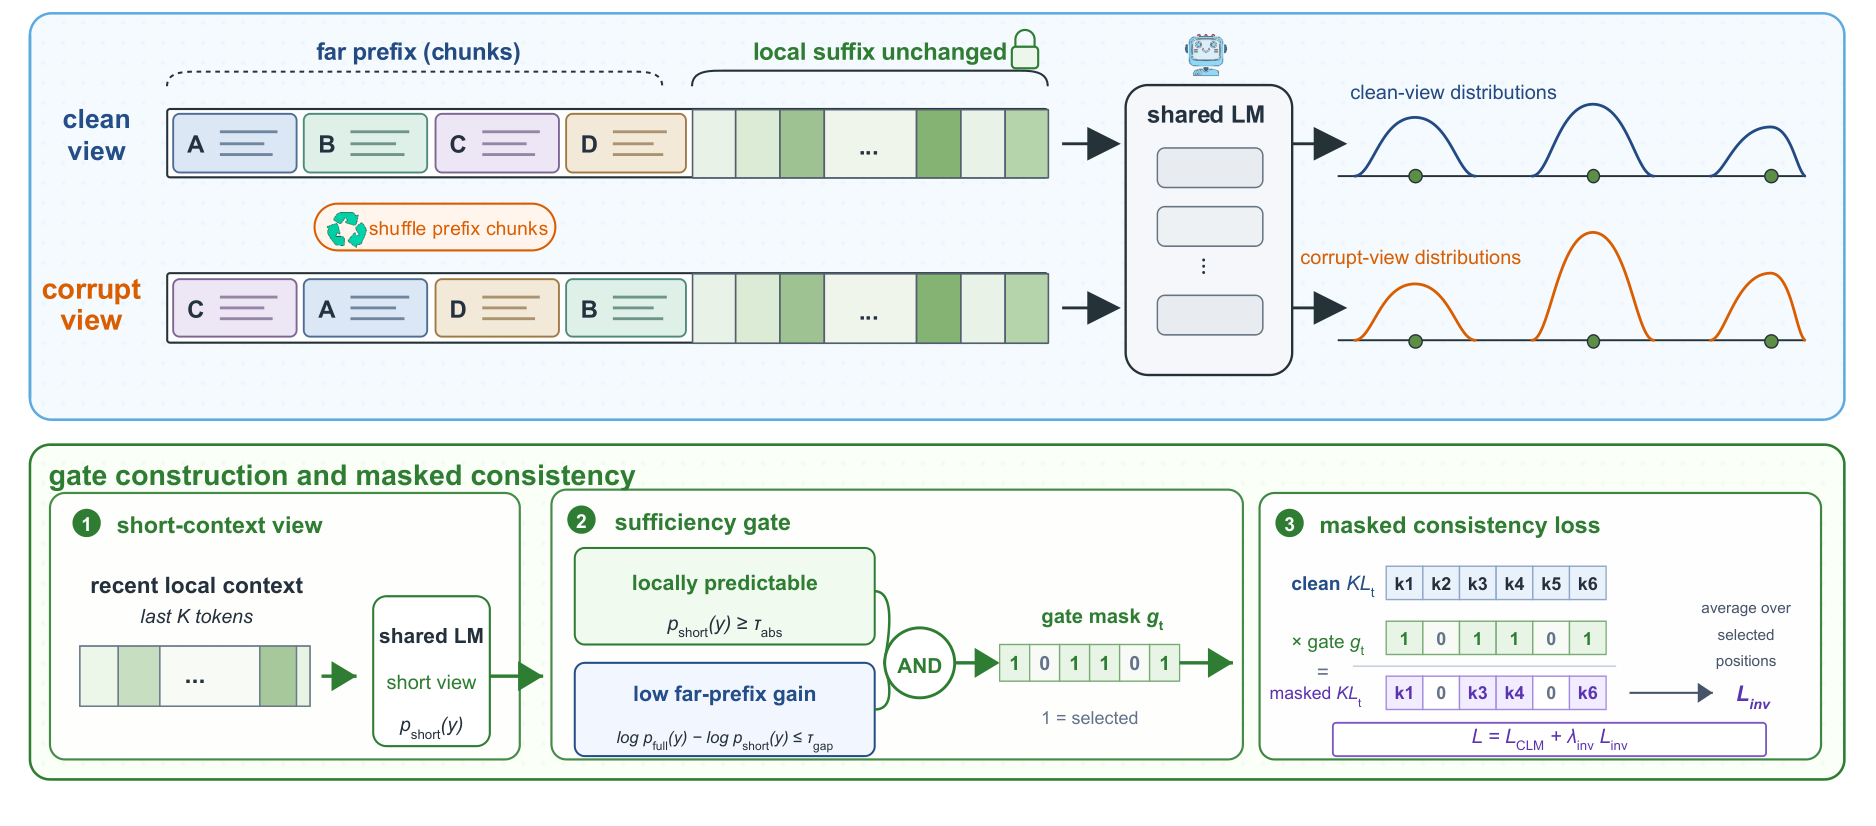
SPAR делит учебную последовательность на дальний префикс и неизменный локальный фрагмент перед целевым токеном. Затем модель получает исходную последовательность и её испорченную копию: в дальнем префиксе переставляют блоки, а ближайший контекст сохраняют без изменений.
Отдельный короткий проход проверяет, достаточно ли модели локального фрагмента. Токен попадает под дополнительное обучение, только если короткий контекст уже позволяет уверенно его предсказать, а полный контекст почти не повышает вероятность правильного ответа. Если дальний префикс действительно содержит полезное свидетельство, SPAR не требует от модели его игнорировать.
Для отобранных токенов метод добавляет штраф за расхождение между предсказаниями на исходной и испорченной последовательностях. Исходное распределение вероятностей служит неподвижным ориентиром, а дополнительный градиент исправляет реакцию на испорченный префикс. Обычное обучение продолжает действовать на всех позициях и отвечает за усвоение полезных зависимостей.
Избирательность здесь важнее самой устойчивости. Если требовать одинаковых ответов после порчи префикса на каждой позиции, модель начнёт пропускать дальние факты, от которых действительно зависит продолжение. SPAR ограничивает это требование позициями, где ближайшего текста уже достаточно.
Где устойчивость превратилась в результат
При дальнейшем обучении проверяли базовые модели семейств Qwen2.5, Llama и GPT2-XL. RULER объединяет синтетические задачи на поиск фактов, прохождение цепочек, агрегацию и ответы по длинному контексту. SPAR превзошёл обычную целевую функцию на каждой модели, хотя величина прибавки заметно различалась между семействами.
Положительный результат сохранился на HELMET, где к поиску по контексту добавлены прикладные вопросы, ранжирование и извлечение значений. При обучении моделей с нуля SPAR также улучшил RULER и NoLiMa на каждом проверенном масштабе. NoLiMa требует находить свидетельство без буквального совпадения слов между вопросом и нужным фрагментом.
Проверка механизма показала, что эффект сосредоточен там, где его ожидали. Ухудшение вероятности правильного токена после порчи префикса сократилось на 0,082 в отобранной области и лишь на 0,004 за её пределами. Это связывает прибавку на тестах не просто с дополнительным штрафом, а с выбором локально достаточных позиций.
Замена содержательного отбора случайной маской дала меньший выигрыш на каждой модели. Штраф без отбора, применённый ко всем позициям суффикса, оказался ещё слабее. Значит, перенос обычного обучения согласованности на весь длинный контекст не заменяет правило, которое сохраняет полезные дальние зависимости.
Границы проверки достаточно широки по семействам моделей, но относятся к базовым моделям и контролируемым тестам. Дальнейшее обучение охватывало контексты до 32 тысяч токенов, а обучение с нуля проверяли на моделях меньшего масштаба. Результаты не показывают напрямую, как изменится готовый диалоговый продукт после настройки на инструкции или подключения поиска по внешним данным.
Меняет ли SPAR планы команд
Для команды, которая обучает базовую модель или продолжает её обучение на длинных и упакованных последовательностях, SPAR даёт конкретный вариант эксперимента. Он особенно близок сценариям, где в одном окне соседствуют несколько документов, диалогов или независимых записей и нерелевантный ранний текст может влиять на локальное продолжение.
Архитектуру модели и формат данных менять не требуется, а специальная разметка задач не нужна. Основные изменения находятся в учебном цикле: нужно построить испорченную копию префикса, выполнить дополнительные проходы и вычислить маску локально достаточных токенов. Это делает SPAR совместимым с существующей моделью, но не бесплатным для обучения.
Сравнения выровнены по учитываемым вычислениям, однако из результатов нельзя вывести универсальную прибавку ко времени и памяти для конкретной инфраструктуры. Перед включением в основной цикл разумно воспроизвести эксперимент на собственных длинах последовательностей и отдельно проверить задачи, где ответ действительно зависит от далёкого фрагмента.
Для команд, которые только вызывают готовую модель через API, работа сама по себе планов не меняет: SPAR действует во время обучения. Для разработчиков моделей она добавляет отдельный рычаг помимо увеличения окна, подбора длинных данных и настройки позиционного кодирования — можно явно учить модель не использовать видимый контекст без необходимости.
Источники
Иллюстрация: рисунок из статьи «Learning When Not to Listen: Selective Anti-Interference Pretraining for Language Models», Jinchang Zhu, Haowei He, Yi Ding и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


