
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Соседний процесс на общей GPU смог определить свойства пользовательского запроса и восстановить ответ LLM, не обращаясь к её API. В препринте, который не прошёл рецензирование, команда Shandong University, Xi’an Jiaotong University и Waseda University приводит собственные замеры: свойства запросов удалось определить с точностью 90,9%. Значит, при совместном использовании ускорителя граница между арендаторами может проходить недостаточно глубоко.
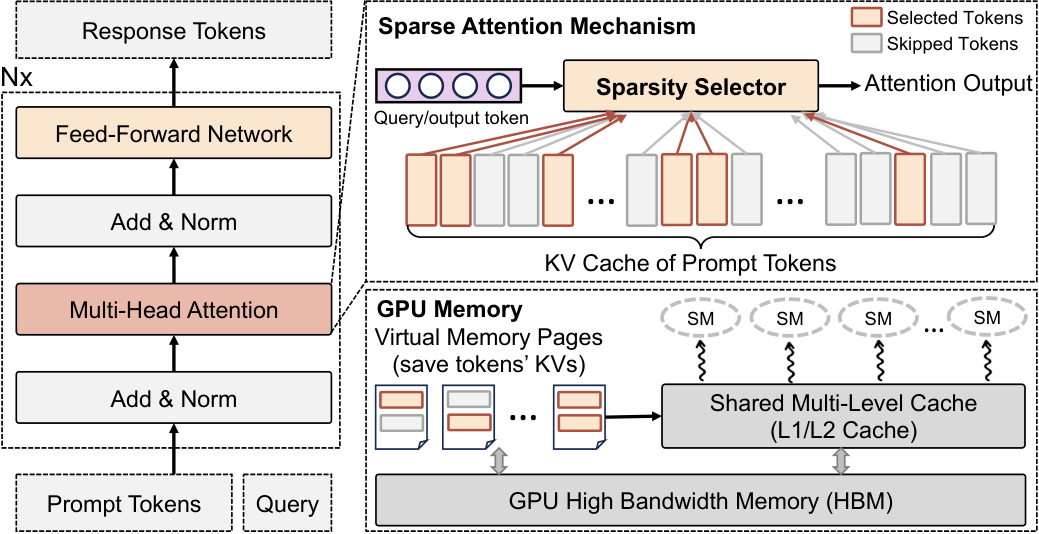
Разреженное внимание (sparse attention) ускоряет обработку длинного контекста: модель обращается не ко всем токенам, а только к выбранным как значимые. Состав этих токенов зависит от запроса и ответа, поэтому меняются обращения к страницам памяти с KV-кэшем. SparLeak косвенно считывает их через конкуренцию за кэш второго уровня и механизм трансляции виртуальных адресов, а затем восстанавливает приблизительный профиль обращений для отдельных токенов.
На этапе обработки запроса этот профиль выдаёт его смысловые свойства, например категорию заболевания. Во время генерации пошаговые следы позволяют восстанавливать токены ответа; средняя доля успешных восстановлений составила 87,3%. Атаку проверяли на LongChat-7B, LLaMA3-8B и Qwen3-8B, трёх механизмах разреженного внимания и трёх наборах чувствительных данных. Сценарий требует, чтобы атакующий процесс работал на той же физической GPU, а перед атакой собрал обучающие следы на копии конфигурации либо через выбранные запросы к цели.
Практическая защита — не размещать недоверенных арендаторов на одной GPU либо разделять между ними кэш и трансляцию адресов на уровне среды выполнения или оборудования. Случайная замена выбранных токенов ослабляет утечку, но портит результат: при замене 30% токенов оценка совпадения текста ROUGE у LLaMA3-8B упала с 0,48 до 0,16. Фиксированные схемы обращений и фиктивные чтения KV-кэша тоже скрывают зависимость от входа, но сокращают выигрыш от разреженного внимания.
Источники
Иллюстрация: рисунок из статьи «SparLeak: Privacy Leakage from Sparse Attention in LLM Inference on Shared GPUs», Fahao Chen, Linkang Du, Jinhao Zhou и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


