
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Очистка и принудительная обрезка коротких реплик мешают голосовому агенту отличать пользователя от телевизора, коллеги или родственника. В работе Abhishek Gautam модель TitaNet-Small на живом трафике обошла более крупную версию и лидера контролируемого теста, хотя работа ещё не рецензирована, а числа в ней получил сам автор. Для конвейера это меняет порядок обработки: проверке говорящего нужен отдельный поток исходного звука, а выбор модели придётся подтверждать на собственных звонках.
Как сравнивали модели на коротких репликах
Модель проверки превращает фрагмент речи в голосовой вектор — набор признаков, по которому можно сопоставить новую реплику с голосом зарегистрированного пользователя. Если система принимает речь постороннего за пользовательскую, агент отвечает на чужую фразу и портит состояние разговора.
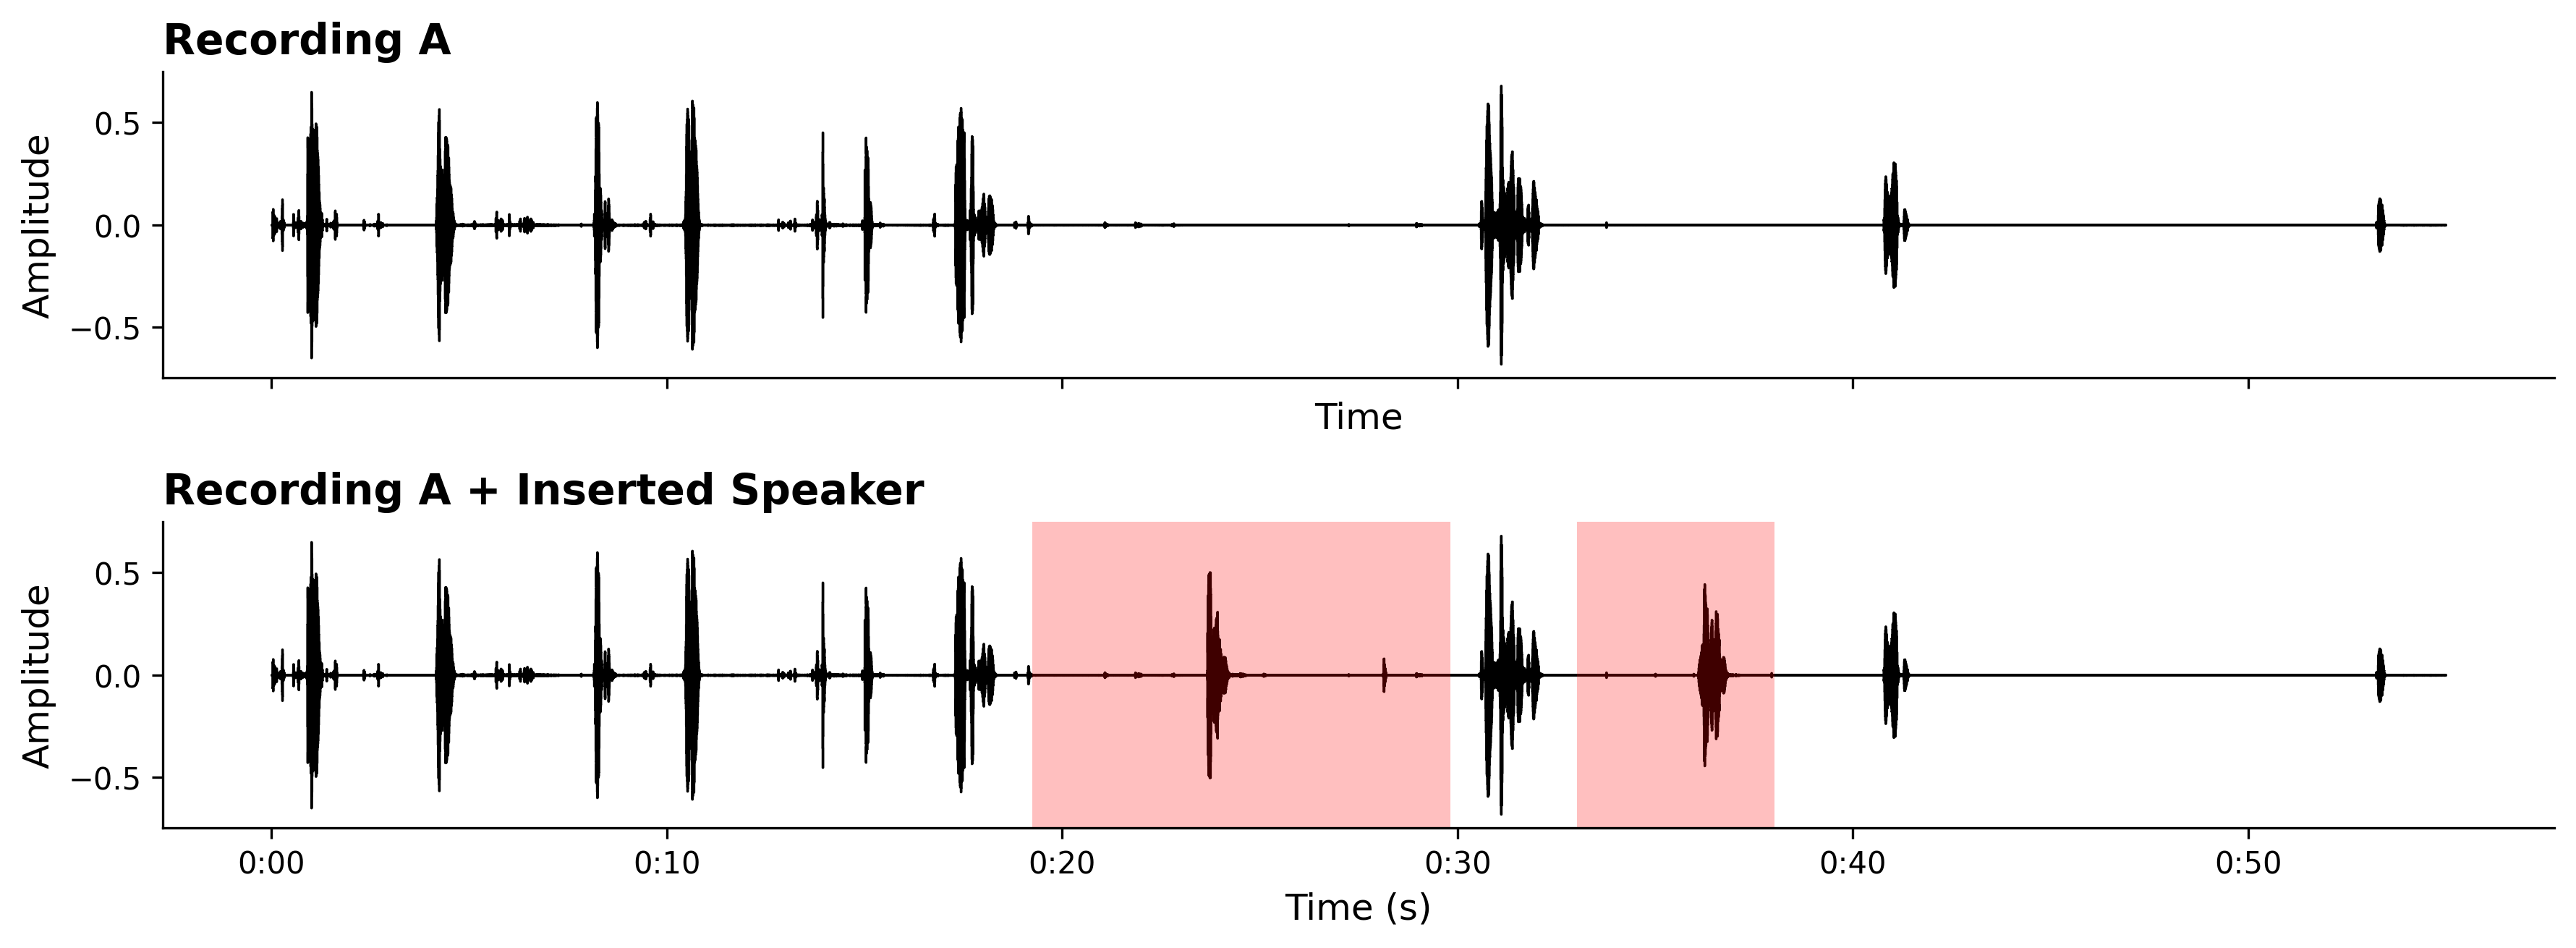
Контролируемый набор собрали из 400 настоящих звонков без синтетической речи. В паузы одного разговора вставляли приглушённую речь другого человека, а детектор голосовой активности делил запись на те же фрагменты, которые получает рабочий голосовой агент. Модели обрабатывали реплики короче одной секунды.
Сравнение охватило TitaNet-Large, TitaNet-Small, ECAPA-TDNN, CAM++ и SpeakerNet. Основной метрикой стала равная частота ошибок, EER: порог выбирают так, чтобы система одинаково часто пропускала постороннего и отклоняла пользователя. Чем ниже значение, тем лучше модель разделяет голоса.
После контролируемого теста кандидатов проверили на размеченном живом трафике с телефонными кодеками, разными микрофонами и шумом каналов. Работа рассматривает отдельные фрагменты речи без одновременного наложения голосов. Вывод о сокращении голосовых векторов получен на аудитории, где преобладали мужчины, говорящие на Hindi, поэтому для более разнообразной базы его нужно проверять заново.
Почему очистка и короткая обрезка ухудшили результат
На исходном звуке контролируемого набора лидировал CAM++ с EER 28,69%. DeepFilterNet ухудшил результат каждой конкурентной модели: очистка сглаживала спектральные детали, по которым система различает голоса. DTLN помог только ECAPA-TDNN, но эта связка всё равно уступила CAM++ без очистки.
Очистка меняла не только звук, но и работу детектора активности. DeepFilterNet подавлял тихие фоновые реплики до такой степени, что детектор их пропускал. DTLN, наоборот, создавал артефакты и дробил длинные реплики на несколько коротких. Поэтому оценивать такой компонент отдельно от сегментации нельзя.
На живом трафике порядок моделей изменился. TitaNet-Small показала лучший EER — 30,57%, а CAM++ уступила обеим версиям TitaNet. ECAPA-TDNN просела до 51,3%, то есть практически перестала отличать пользователя от постороннего, хотя на контролируемом наборе держалась рядом с лидерами.
Фиксированная обрезка до 700 мс ухудшила все конкурентные модели на 0,8–2,2 процентного пункта. Дополнительный контекст в полном фрагменте стабилизировал голосовой вектор, особенно там, где системе нельзя пропускать постороннюю речь. Экономить задержку за счёт удаления уже полученного звука оказалось невыгодно.
Как это меняет архитектуру голосового агента
Если очиститель сейчас стоит перед всеми речевыми компонентами, поток стоит разделить. Исходный звук поступает в проверку говорящего, а очищенный — в распознавание речи, где разборчивость важнее сохранения тонких голосовых признаков. Так один компонент не вынуждают работать с сигналом, который подготовили для другой задачи.
Лабораторный лидер не должен автоматически попадать в рабочую систему. Канал связи, кодек и состав аудитории полностью изменили рейтинг моделей, поэтому финальный выбор требует размеченной выборки из целевого трафика. В этой работе меньшая TitaNet-Small оказалась надёжнее TitaNet-Large и CAM++.
Порог сходства следует настраивать под цену ошибки, а не только под сводную метрику F1. Принятая фраза постороннего меняет ход разговора, тогда как отклонённую пользовательскую реплику можно переспросить. Для голосового агента обычно разумнее реже принимать чужую речь, даже если он чаще просит пользователя повторить ответ.
У TitaNet голосовой вектор удалось сократить со 192 до 92 компонентов без измеримого ухудшения на исследованной аудитории. Это почти вдвое уменьшает объём сохранённых шаблонов и вычисления при поиске похожих голосов. Однако отброшенная часть могла кодировать язык и пол, поэтому переносить сокращение на многоязычную или демографически разнообразную базу без проверки нельзя.
Работа даёт не готовый универсальный стек, а порядок экспериментов: сохранить исходный аудиопоток, использовать полный фрагмент детектора активности, сравнить модели на реальных звонках и только затем сокращать вектор. Такой порядок снижает риск ускорить конвейер ценой ошибок, которые проявятся лишь после запуска.
Источники
Иллюстрация: рисунок из статьи «Benchmarking Speaker Embedders in the Sub-Second Regime for Real-Time Voice AI Agents», Abhishek Gautam, CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


