
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Агента-программиста научили улучшать понимание кодовой базы без изменения весов LLM. Хотя работа не рецензирована и числа получили сами авторы, команда Virginia Tech и NEC Laboratories America довела долю полностью решённых сущностей с Claude-4.5-Sonnet до 94,9%. Для команд это переносит часть улучшения из дообучения модели во внешний контекст, который можно проверить тестами, сравнить и откатить.
Спецификацию проверяют через сгенерированный код
SpecForge работает не с документацией для разработчика, а с поведенческими спецификациями. Они описывают, что должны делать функции, классы и методы: какие данные принимают, что возвращают и какие условия обязаны соблюдать.
Качество такого текста нельзя надёжно оценить по полноте или стилю. Поэтому агент получает спецификацию без исходной реализации, восстанавливает по ней код, а система запускает тесты. Ошибки показывают, какого правила или граничного случая не хватает в описании.
После этого агент переписывает спецификацию, снова генерирует реализацию и повторяет проверку. Веса модели остаются замороженными: накопленное знание хранится в тексте, который команда может читать, версионировать и использовать с другим агентом.
Тесты в основном эксперименте автоматически строили по эталонной реализации и оставляли только после успешного запуска. Перенос спецификаций проверяли отдельно: перевод с Python на Java охватил 208 программных сущностей и 680 тестов, а реализацию новых функций — 10 пакетов и 27 заданий. Тем самым работа охватывает восстановление существующего поведения, межъязыковой перенос и доработку кодовой базы, но не произвольную разработку продукта с нуля.
Почему последовательное исправление спецификаций застревает
Простого цикла «нашли ошибку — переписали описание» недостаточно. Функции зависят друг от друга, а модель видит весь комплект спецификаций. Уточнение одной функции может изменить генерацию остальных и сломать уже проходившие тесты.
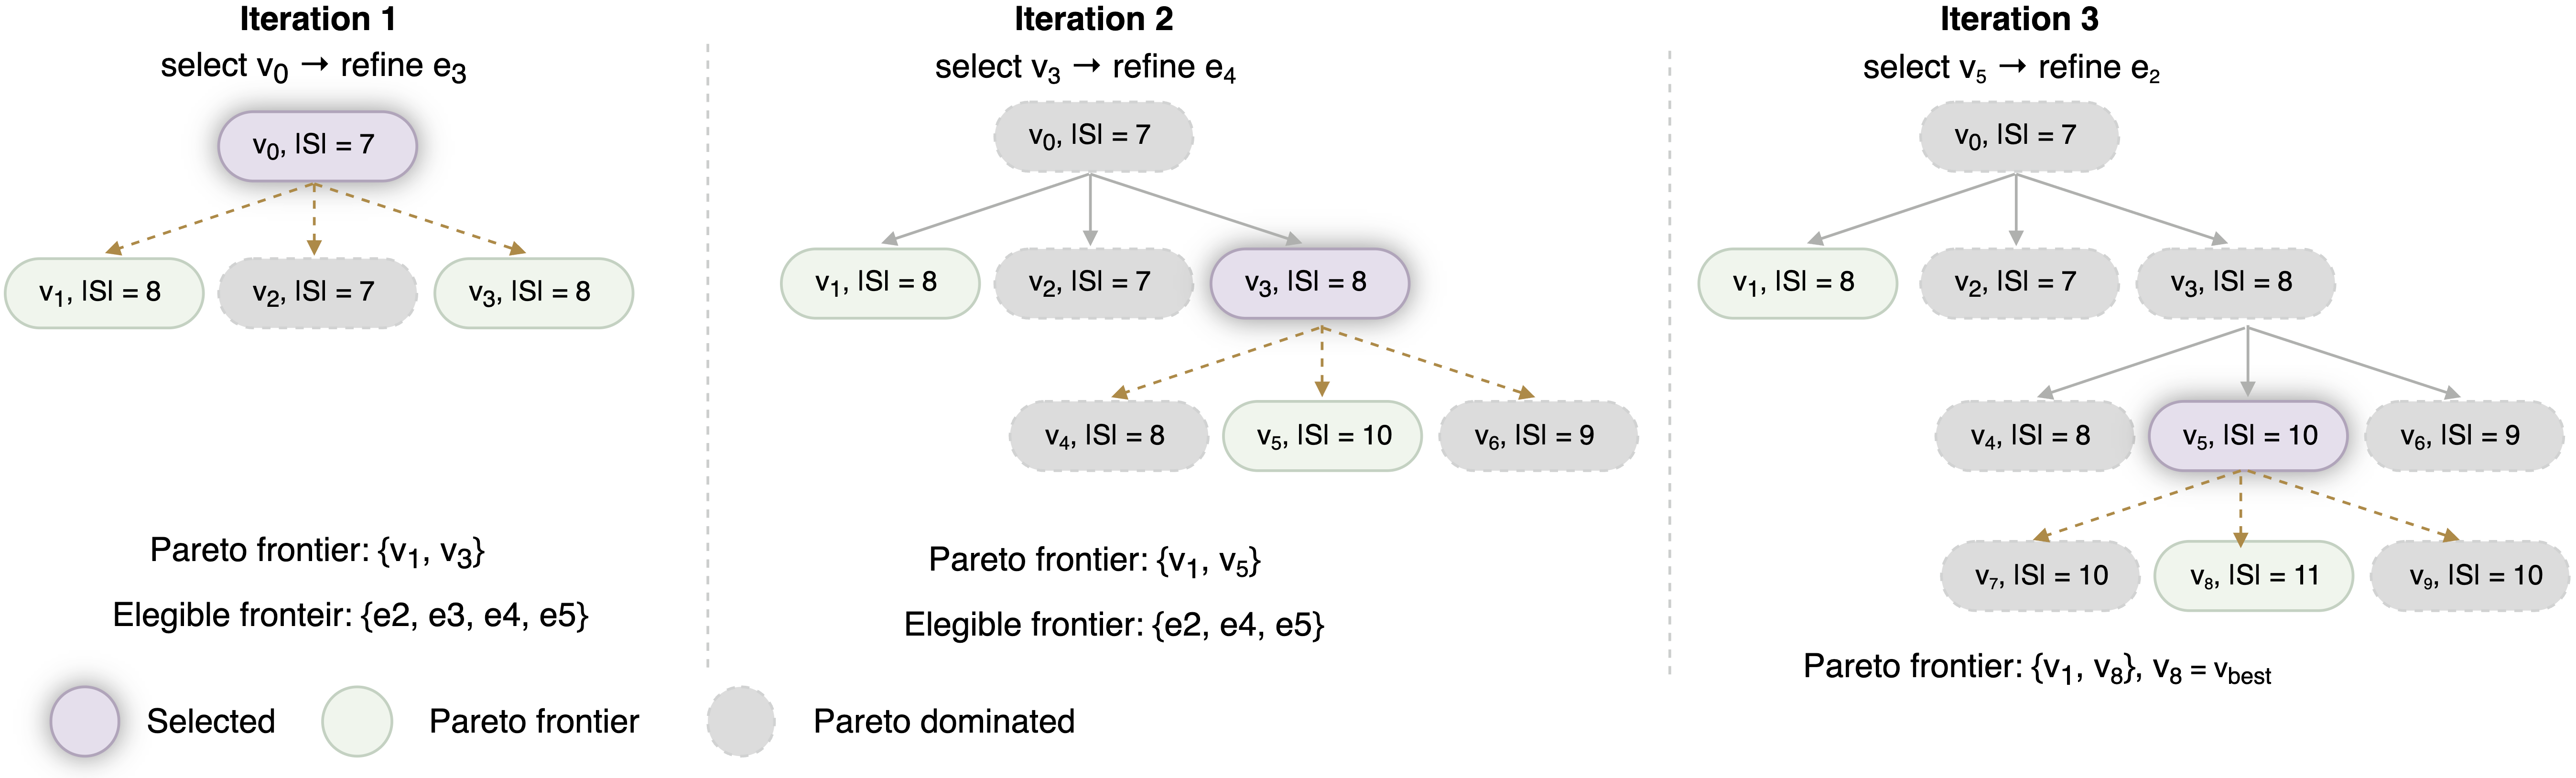
SpecForge не хранит единственную текущую версию. Система ведёт архив вариантов, каждый из которых лучше остальных хотя бы для части программных сущностей. Если один вариант точнее описывает низкоуровневые функции, а другой — управляющую логику, поиск сохраняет оба вместо раннего выбора одного пути.
Следующую сущность выбирают по графу вызовов: сначала уточняют вызываемую функцию и только затем код, который от неё зависит. Рекурсивно связанные функции объединяют и рассматривают вместе. Такой порядок уменьшает риск, что агент объяснит ошибку вызывающего кода неверным поведением ещё не исправленной зависимости.
Для каждого шага система создаёт несколько вариантов спецификации. В них агенту показывают разные подмножества упавших тестов, потому что полный набор ошибок может смешивать полезные сигналы с повторяющимися или вторичными сбоями. После генерации кандидатов SpecForge заново собирает весь модуль и запускает полный комплект тестов, поэтому локальное исправление не принимают без проверки остальных сущностей.
Эти три решения превращают переписывание документации в поиск по состояниям: архив сохраняет альтернативы, граф вызовов задаёт порядок, а разные наборы ошибок дают несколько объяснений сбоя. Улучшение накапливается во внешнем контексте, а не в параметрах модели.
Когда подход стоит включать в планы разработки
На DevEval+ SpecForge превзошёл сильнейший базовый метод в среднем на 5,7 процентного пункта. В переводе Python-кода на Java доля полностью решённых сущностей выросла с 39,7% при передаче только исходного кода до 65,7% при передаче спецификаций. На простых заданиях по добавлению функций результат достиг 74,5% против 55,7% с документами требований из SWE-Dev.
Перенос на другие задачи — более полезный результат, чем улучшение внутри исходного цикла. Агент не просто приспосабливает реализацию к известным тестам: полученный текст помогает воспроизвести поведение на другом языке и встроить новую функцию в существующий пакет.
Подход подходит командам, которые мигрируют старые системы, восстанавливают контракты плохо документированного кода или многократно поручают агенту изменения в одном репозитории. Здесь спецификация становится отдельным активом: её можно хранить рядом с кодом и обновлять по результатам исполняемых проверок.
Менять выбранную LLM ради SpecForge не требуется. Меняется окружение агента: конвейеру нужны эталонный код для начального анализа, тесты с однозначным результатом, граф вызовов и возможность многократно генерировать и запускать модуль. Если тесты нестабильны или поведение системы нельзя воспроизвести автоматически, цикл лишается сигнала, по которому отличает улучшение от правдоподобной правки текста.
Работа не предлагает готовую замену технической документации. Она показывает более узкую архитектуру: описывать поведение для машины, измерять качество через код и сохранять несколько конкурирующих версий, пока тесты не подтвердят устойчивый вариант. Для пилота разумно выбрать один модуль с хорошим покрытием и проверить не только восстановление функций, но и следующую реальную задачу — миграцию или добавление возможности.
Источники
Иллюстрация: рисунок из статьи «SpecForge: Recursive Self-Improvement for Coding Agents via Behavioral Specifications», Yutong Cheng, Haifeng Chen, Peng Gao и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


