
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Черновую модель для спекулятивного декодирования научились обучать без последовательного сбора полных ответов. Хотя работу не рецензировали и числа получили сами авторы, новый подход дал в 16,09 раза больше обучающих токенов за единицу времени. Команды, которые обучают собственные черновые модели, могут ускорить не только выдачу ответа, но и сам цикл их улучшения.
Почему обучение оставалось последовательным
При спекулятивном декодировании небольшая черновая модель предлагает сразу блок токенов, а основная модель проверяет их одним запуском. Подход сохраняет распределение ответов основной модели, но сокращает число последовательных шагов. Итоговая скорость зависит от того, сколько предложенных токенов пройдут проверку подряд.
Параллельные черновые модели DFlash, DSpark и DFlash V2 уже умеют предлагать весь блок за один проход. Узкое место возникает при обучении на данных, которые текущая версия черновика породила сама. Обычная схема сначала предлагает блок, затем проверяет его основной моделью и только после этого выбирает контекст для следующего блока.
Каждый новый контекст зависит от результата предыдущей проверки, поэтому собрать обучающий ответ параллельно нельзя. GPU чередует короткие вычисления с ожиданием, а обновление весов начинается только после завершения траектории.
Команда Qwen Business Unit of Alibaba и университетов показала, что полная траектория для такого обучения не обязательна. Чтобы оценить отдельный блок, основной модели достаточно эталонного префикса и продолжения, которое черновик сгенерировал после него.
Как независимые ветви сохраняют правильную историю
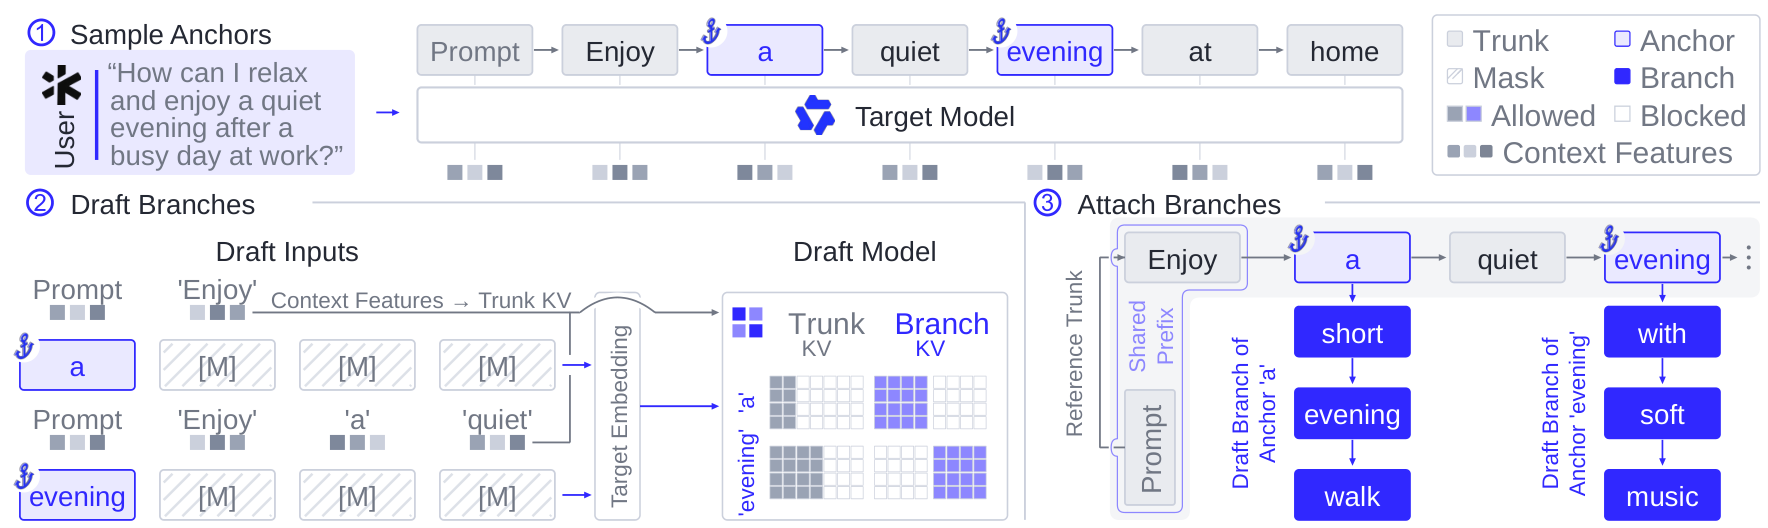
SpecOPD берёт заранее подготовленный ответ основной модели как общий ствол и выбирает в нём несколько опорных позиций. От каждой позиции текущая черновая модель независимо генерирует продолжение. Получается дерево: ветви используют общий префикс, но после разветвления видят только собственные токены.
Основная модель обрабатывает общий ствол один раз, затем параллельно оценивает продолжения. Для полного внимания маска запрещает ветви видеть соседние продолжения. Для разреженного внимания метод отдельно поддерживает группы выбранных блоков, а для линейного внимания восстанавливает состояние в точке ветвления и независимо продвигает его по каждой ветви.
Это различие существенно для реализации. Обычная пакетная обработка ветвей либо повторяет общий префикс, либо смешивает истории после разветвления. SpecOPD переиспользует вычисления до опорной позиции, но сохраняет тот контекст, который основная модель увидела бы при отдельной обработке каждой ветви.
Функция потерь напрямую поощряет длинный принятый префикс. Она сравнивает распределения токенов основной и черновой моделей на каждом шаге ветви и сильнее учитывает ранние расхождения: первая ошибка обрывает пользу от всех следующих предложений.
Метод проверяли на основных моделях размером от 8 до 125 млрд параметров, с полным, разреженным и линейным вниманием. В набор вошли диалоги, код, математика и действия агентов; сравнения проводили на MT-Bench, HumanEval, MATH-500, SWE и Terminal. Замер скорости обучения для модели на 27 млрд параметров выполняли на восьми GPU и не включали подготовку эталонных ответов.
Когда SpecOPD меняет план разработки
Средняя длина принятого блока выросла максимум на 41,45%. При генерации SpecOPD достиг ускорения до 3,56 раза относительно обычного последовательного декодирования. Это связывает ускорение обучения с метрикой, которая непосредственно определяет число запусков основной модели.
Прирост пропускной способности обучения складывается из двух эффектов: обновления весов выполнялись в 4,95 раза быстрее, а одно обновление содержало в 3,25 раза больше токенов с обучающим сигналом. Метод не просто переносит прежний объём работы в более крупный пакет, а извлекает больше независимых примеров из каждого эталонного ответа.
Для команды с уже работающим спекулятивным декодированием работа меняет приоритет оптимизации. После ускорения чернового прохода следующим ограничением становится не архитектура черновика, а последовательный сбор данных для его дообучения. Здесь ветвление позволяет лучше загрузить GPU и чаще обновлять модель.
SpecOPD не заменяет саму схему декодирования и не даёт ускорения без обучаемой черновой модели. Для внедрения нужны эталонные ответы, доступ к распределениям основной модели и исполнитель, который умеет разделять историю ветвей для используемого механизма внимания. Поэтому ближайший практический сценарий — обучение DFlash, DSpark или DFlash V2 внутри собственного контура выдачи, а не смена основной LLM.
Результаты охватывают разные размеры моделей и типы внимания, но остаются привязаны к трём архитектурам черновика и выбранным задачам. Перед изменением производственного контура стоит проверить две метрики на своих запросах: длину принятого блока и реальную скорость выдачи при рабочей параллельности.
Источники
Иллюстрация: рисунок из статьи «SpecOPD: Branch-Parallel On-Policy Distillation for Speculative Decoding», Tianyu Liu, Jun Zhang, Wenjie Huang и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


