
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Spexis позволяет полезно занять простаивающие ресурсы при обслуживании LLM на нескольких GPU, не выделяя дополнительную память под спекулятивные токены. Работа Seoul National University и Hanyang University показывает ускорение до 34% относительно лучшей комбинации стандартных схем параллелизма, хотя препринт не рецензирован и числа получили сами авторы. Подход может изменить конфигурацию серверов, где обмен между GPU или нехватка памяти уже ограничивают пропускную способность.
Спекуляция становится отдельной схемой параллелизма
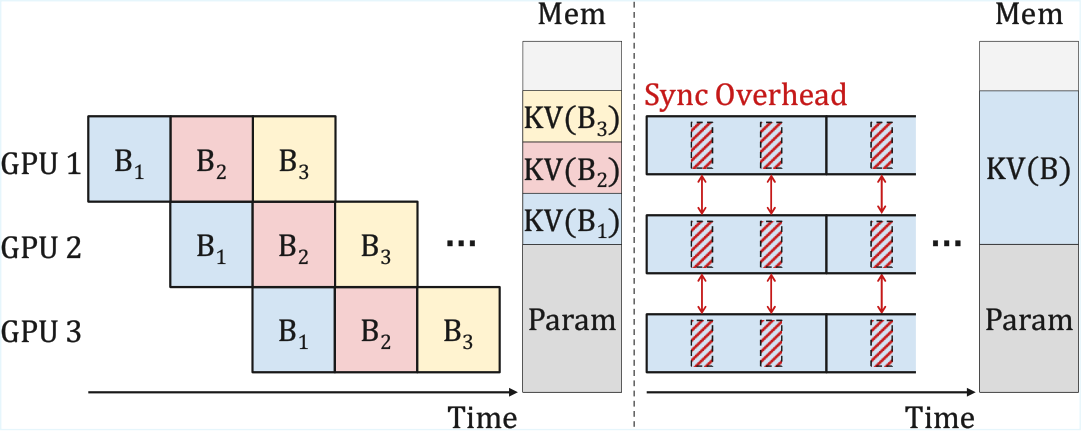
При конвейерном параллелизме слои модели распределяют между GPU, а запросы делят на микропакеты. Это сокращает простой этапов конвейера, но каждому микропакету нужен собственный кэш ключей и значений (KV-кэш). Чем глубже конвейер, тем меньше запросов помещается в память одновременно.
Тензорный параллелизм делит вычисления каждого слоя между несколькими GPU. Он меньше зависит от размера KV-кэша, но требует часто синхронизировать частичные результаты. При медленном соединении между ускорителями время обмена начинает перекрывать выигрыш от параллельных вычислений.
Spexis добавляет третью ось — спекулятивный параллелизм. Ранние слои модели предлагают следующие токены, а оставшиеся проверяют их. Пока поздний этап проверяет уже предложенные токены, ранний этап продолжает строить новые предположения вместо ожидания следующего обычного прохода.
Спекулятивная и обычная ветви используют общий KV-кэш. Поэтому Spexis заполняет паузы конвейера, но не создаёт отдельный набор записей для каждого предположения. Если модель отвергает токен, соответствующую работу приходится повторить, поэтому результат зависит от того, как часто черновая ветвь угадывает продолжение.
Spexis построен поверх vLLM. Перед запуском система измеряет задержки разных размеров пакета и оценивает пропускную способность доступных комбинаций конвейерного, тензорного и спекулятивного параллелизма. Затем она выбирает конфигурацию, которая лучше соответствует модели и соединению между GPU.
Планировщик отбрасывает плохие предположения и бережёт память
Выполнять все спекулятивные ветви невыгодно: токены с низкой уверенностью редко проходят проверку. Spexis ранжирует их и отбрасывает нижние 15–30%, а освободившиеся ресурсы направляет на более вероятные продолжения. Порог подбирают по профилю конкретной модели, а не задают одинаковым для всех развёртываний.
Вторая задача — решить, когда принимать новый запрос. Немедленный запуск повышает текущую загрузку, но может вытеснить KV-кэш уже работающей последовательности. Если её затем вернуть, серверу придётся повторно вычислить потерянное состояние.
Для этого отдельный предсказатель оценивает, сколько токенов осталось у активных ответов. Планировщик смотрит на ожидаемое потребление памяти в ближайшие 64 шага и откладывает подготовку нового запроса, если ранний запуск приведёт к дорогому вытеснению. При этом он сравнивает стоимость повторного вычисления с потерей пропускной способности от ожидания: короткая задержка не всегда выгоднее немедленного приёма.
Такой прогноз не пытается точно угадать длину ответа. Ему достаточно понять, скоро ли запрос завершится и освободит память. Это снижает требования к предсказателю, но добавляет в развёртывание два обучаемых компонента: адаптер для черновых токенов и модель остаточной длины.
Менять конфигурацию стоит после замера на своём трафике
В основном сравнении Spexis ускорил обслуживание до 34% относительно заранее подобранной лучшей комбинации конвейерного и тензорного параллелизма. Сам спекулятивный параллелизм дал 10–15%, выбор уверенных токенов добавил до 12 процентных пунктов, а прогноз памяти — ещё 3 пункта. Значит, основной эффект даёт не только предсказание токенов: заметная часть выигрыша приходит от того, как планировщик распределяет память и работу.
Облачные замеры показывают зависимость от оборудования. На проверенных системах с PCIe Spexis всегда опережал чистый тензорный параллелизм, но на части конфигураций с NVLink проиграл ему; в худшей паре пропускная способность Spexis составила 0,47 от базовой. Быстрый обмен между GPU уменьшает цену синхронизации, и тогда ошибки спекуляции могут стоить дороже сэкономленного времени.
Эксперименты охватывают Llama-3.3-70B и Qwen3-32B, SpecBench, несколько NVIDIA GPU и соединения PCIe и NVLink. Обслуживание запросов измеряли на собственном кластере, а облачные тесты проводили с фиксированным пакетом. Предсказатель длины обучали на ShareGPT и дополнительно проверяли на SpecBench и UltraChat.
Для команды с несколькими GPU и узким межсоединением работа даёт практический план эксперимента: встроить реализацию поверх vLLM, измерить долю принятых черновых токенов на рабочем трафике и сравнить Spexis с лучшей конфигурацией без спекуляции. Если тензорный параллелизм уже хорошо масштабируется на NVLink, менять архитектуру заранее не стоит. Если сервер упирается в обмен по PCIe, малые микропакеты или повторное построение KV-кэша, новая ось параллелизма может дать выигрыш без покупки дополнительной памяти.
Источники
Иллюстрация: рисунок из статьи «Spexis: Speculative Lookahead Scheduling for LLM Inference», Hyungyu Jung, Jaehyeok Yu, Hoonseo Choi и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


