
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
У LLM удалось отделить внутренние каналы, которые поддерживают связность текста, от каналов, где меняется математическое рассуждение. В препринте IIT Dhanbad и National University of Singapore, который не прошёл рецензирование и содержит собственные замеры авторов, метод SphereGate с 0,1 млн обучаемых параметров обошёл другие компактные методы на MATH-500 на 2,0–7,3 процентного пункта. Это даёт командам новый вариант дообучения с подкреплением без изменения весов основной модели.
Как отделили связность текста от рассуждения
После каждого блока Transformer остаётся вектор признаков — остаточный поток. Отдельные координаты этого вектора авторы называют каналами. У некоторых каналов средняя активация заметно выше обычной: такое неравномерное распределение называют анизотропией.
Авторы выделяли эти каналы без разметки правильных и неправильных ответов. Они пропускали через модель калибровочные задания, вычисляли среднюю абсолютную активацию каждого канала и выбирали статистические выбросы. В Qwen2.5-1.5B после контролируемого дообучения SFT в эту группу попало около 5% координат.
Удаление выбранных каналов почти разрушило предсказание обычного текста. На WikiText-2 перплексия выросла с 10,44 до 2,01 млн, тогда как удаление такого же числа случайно выбранных остальных каналов подняло её лишь до 35,06. Перплексия показывает, насколько модель не уверена в следующем токене: чем она ниже, тем точнее предсказание.
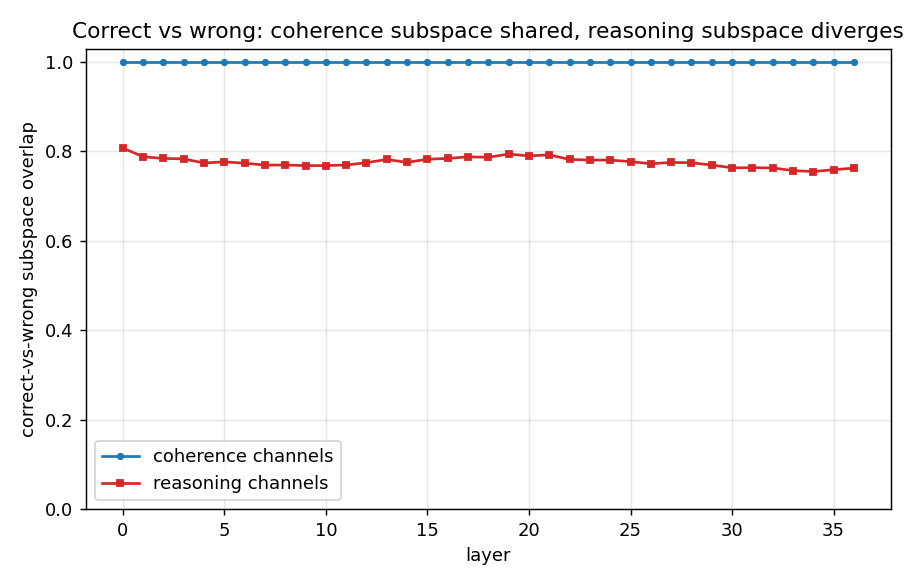
При этом выбранная группа почти одинаково представляла правильные и ошибочные решения математических задач. У остальных каналов внутренние представления двух типов решений расходились сильнее. Поэтому первую группу авторы используют как приближённый показатель связности, а дополнение к ней — как пространство, где легче менять рассуждение.
Разные режимы дообучения тоже действовали на эти группы неодинаково. SFT заметнее меняло состав анизотропных каналов, когда его и прямое обучение с подкреплением GRPO запускали от одной исходной модели. В отдельном запуске GRPO после SFT сильнее менялись остальные каналы, хотя анизотропная группа также не оставалась полностью неподвижной.
Как SphereGate сохраняет одни каналы и меняет другие
SphereGate добавляет после каждого блока отдельный положительный коэффициент для каждого канала. Коэффициент умножает соответствующую координату остаточного потока, а все веса основной модели остаются замороженными. В начале коэффициенты равны единице, поэтому модель сохраняет исходное поведение.
Во время GRPO обучаются только эти коэффициенты. Их значения ограничены, чтобы отдельный канал нельзя было бесконтрольно усилить или подавить. По умолчанию SphereGate обучает коэффициенты всех каналов, а не использует найденное разделение как жёсткую маску.
Градиент каждого коэффициента зависит от активации канала. Авторы доказывают для заданных условий оптимизации, что каналы с высокой энергией получают меньший относительный сдвиг. Это не гарантирует сохранность связности при любом обучении, но объясняет, почему метод может почти не двигать анизотропную группу и оставлять остальным каналам больше пространства для адаптации.
На Qwen2.5-0.5B SphereGate набрал 42,3 балла MATH-500 против 35,0 у лучшего из сравниваемых компактных методов. Обучение только дополнительных каналов отстало от версии со всеми коэффициентами лишь на 0,6 процентного пункта. SphereGate также оказался сопоставим с полным GRPO или превзошёл его на проверенных моделях, хотя менял лишь поканальные множители.
Меняет ли работа планы дообучения LLM
Работа не меняет выбор базовой модели, но добавляет разумную ветку в план экспериментов. Если продукт дообучает открытую LLM на задачах с проверяемой наградой, SphereGate можно сравнить с LoRA-подобными методами и полным GRPO. Метод особенно уместен, когда требуется сохранить основную модель замороженной и контролировать небольшое число параметров.
Для внедрения нужен доступ к остаточному потоку после каждого блока: одних ответов модели через внешний API недостаточно. Также придётся поддержать дополнительные коэффициенты в обучающем и исполняющем коде. Работа не даёт замеров скорости, расхода GPU или задержки генерации, поэтому преимущество по числу обучаемых параметров нельзя автоматически считать преимуществом по стоимости.
Проверка охватывает модели Qwen2.5 и Llama-3 размером от 0.5B до 8B параметров. Обучение и основные сравнения сосредоточены на математике: MATH, DAPO-Math, AMC23, Minerva Math, AIME24 и OlympiadBench. Связность оценивали косвенно через предсказание следующего токена на WikiText-2, поэтому работа не доказывает, что конкретные каналы исключительно отвечают за смысловую цельность во всех доменах.
Практический вывод уже достаточно узкий: при GRPO не обязательно менять веса всей модели или искать подпространство только среди весов. Поканальное масштабирование внутренних представлений стоит добавить в испытания, если команда контролирует архитектуру модели и обучает рассуждение на проверяемых ответах. Для диалогов, инструментальных вызовов и бизнес-задач потребуются отдельные замеры.
Источники
Иллюстрация: рисунок из статьи «Understanding and Exploiting Anisotropy in Post-Training», Samyak Jha, Harshvardhan Saini, Yizhen Liao и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


