
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Появился способ заранее решать, куда направить фиксированный бюджет LLM: на дополнительные ответы, смешивание моделей или более тщательную проверку. В нерецензированном препринте, где все числа получил сам автор, SPLIT отставал от лучшей конфигурации, выбранной задним числом, не более чем на 0,8 процентного пункта. Такой расчёт может заменить постоянное правило вроде «всегда генерировать больше вариантов».
Почему дополнительные ответы перестают повышать точность
Система с повторной генерацией должна решить разные задачи. Сначала ей нужно получить хотя бы один правильный вариант, затем — выбрать именно его. Вероятность первого события обычно растёт вместе с числом попыток, но качество итогового ответа ограничивает проверяющий механизм.
На MATH большинство голосов среди ответов Llama-3-8B-Instruct удерживало точность около 43%, хотя правильный вариант присутствовал среди кандидатов в 98% случаев. Дополнительные попытки почти гарантировали наличие решения, но не помогали распознать его.
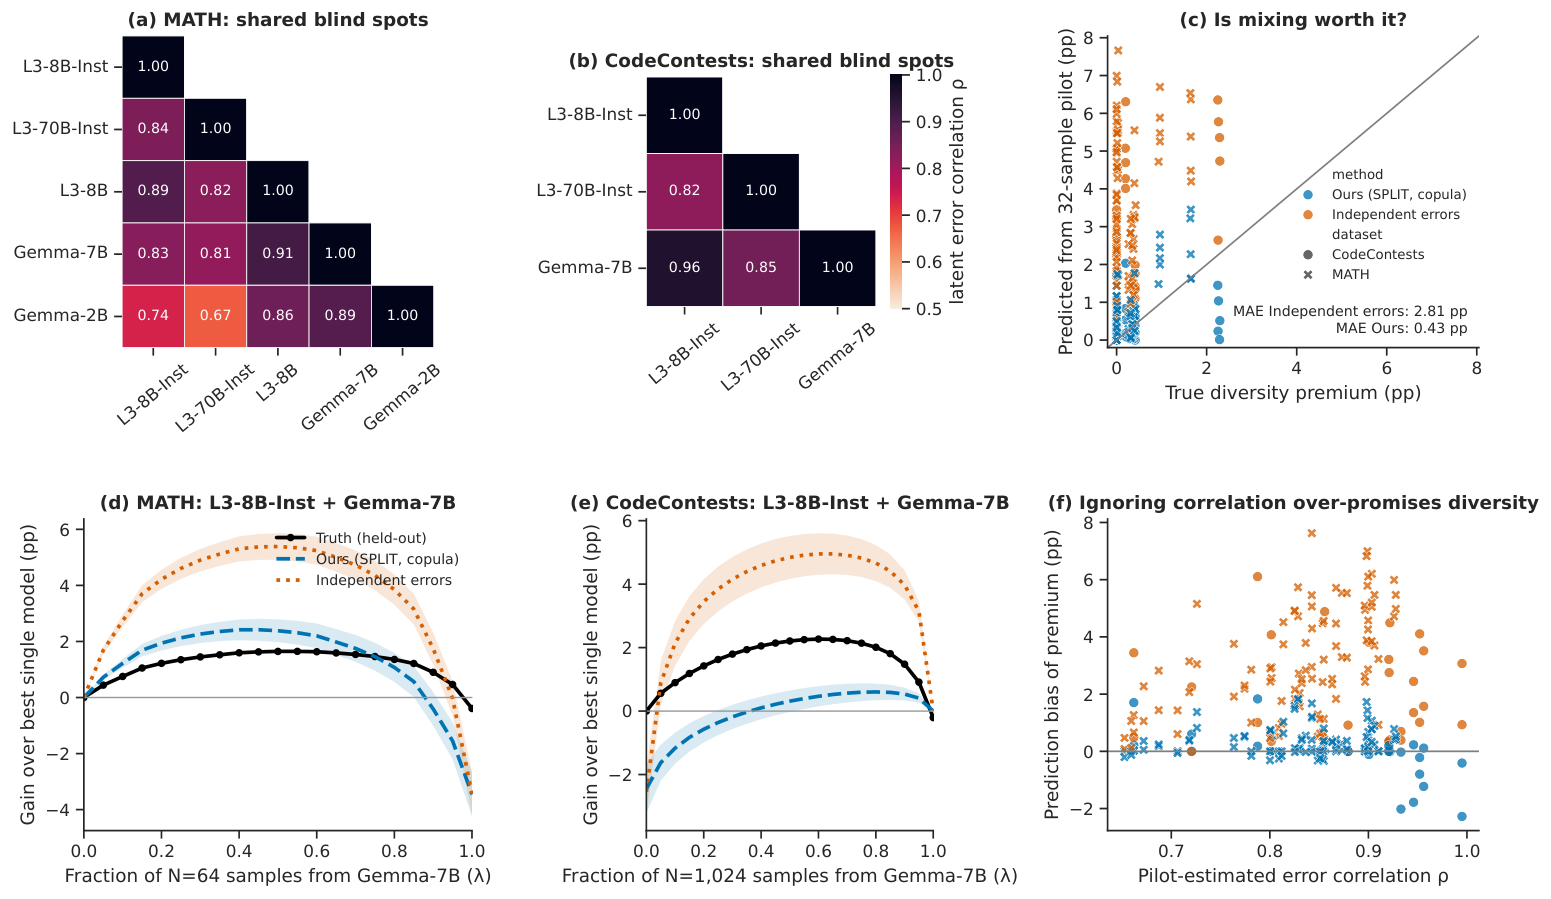
Причина не сводится к средней точности проверки. Сложные задачи остаются сложными для разных генераторов, поэтому их ошибки связаны. Неверный, но убедительный ответ также может обмануть несколько моделей-оценщиков подряд. Повторные вызовы в таком случае воспроизводят общий слепой участок, а не дают независимую проверку.
SPLIT разделяет вероятность успеха на наличие правильного кандидата и вероятность выбрать его. Формула учитывает сложность конкретной задачи, общие ошибки генераторов, ложное принятие неверных ответов и связь между повторными решениями проверяющего механизма.
Метод поддерживает принятие или отклонение кандидатов по порогу и выбор ответа с максимальной оценкой. В первом случае предел задаёт точность среди принятых вариантов. Во втором важнее то, насколько хорошо проверка различает правильные и ошибочные ответы в верхней части шкалы.
Как SPLIT выбирает конфигурацию по размеченной пробе
Перед запуском команда собирает небольшую пробу задач с известными правильными ответами. Для каждого генератора она сохраняет кандидатов, метки правильности и решения проверки. SPLIT по этим данным оценивает распределение сложности задач и вероятность того, что модели застрянут на одних и тех же примерах.
Отдельно метод оценивает, как проверка принимает правильные и ошибочные ответы. Для повторных вызовов он также определяет, насколько решения связаны между собой. Если модель-оценщик снова и снова принимает одну убедительную ошибку, планировщик не считает эти вызовы независимыми.
Затем SPLIT перебирает доступные конфигурации: какие генераторы использовать, сколько кандидатов получить, сколько раз их проверить и какой порог применить. Ограничением может служить объём вычислений, цена или задержка. Для выбора достаточно правильно упорядочить конфигурации по ожидаемому качеству — точный прогноз каждой кривой не обязателен.
Метод проверили на семи бенчмарках по математике, естественным наукам, программированию и разработке программных агентов. В эксперименты вошли 26 моделей, шесть видов реальных проверяющих механизмов и пул из 175 агентных систем. Использовались опубликованные ответы и вердикты, а программы из CodeContests автор запускал локально.
Каждое постоянное правило хотя бы в одном сценарии уступало лучшему распределению бюджета на 2,5 процентного пункта или больше. Не сработало и универсальное соотношение между генерацией и проверкой: лучший вариант менялся вместе с бюджетом, генератором и характером ошибок проверяющего механизма.
Когда команде стоит пересмотреть архитектуру вывода
Работа меняет планы систем, которые уже генерируют несколько ответов и автоматически выбирают один. Вместо фиксированного числа попыток им имеет смысл добавить этап калибровки на собственных размеченных задачах и сравнивать целые конфигурации, а не отдельные модели.
- Проверять генератор вместе с проверкой. Более сильная модель может выдавать меньше неверных ответов, но её ошибки иногда лучше проходят прежние тесты. После смены генератора нужно заново измерять ложные принятия.
- Не считать голоса независимыми. Несколько моделей-оценщиков помогают только тогда, когда их дополнительные решения чаще усиливают принятие правильных ответов, чем ошибочных.
- Оценивать смешивание по остаточным ошибкам. Вторая модель полезна не сама по себе, а когда решает задачи, на которых застревает первая. Две модели с одинаковыми слепыми участками лишь делят бюджет.
Проба должна представлять модели и задачи, которые попадут в эксплуатацию. В опыте с более старыми агентными системами прогноз хуже переносился на поздние и более сильные системы. Это делает SPLIT процедурой регулярной калибровки, а не настройкой, которую можно выполнить один раз.
Границы проверки тоже существенны. Самый длинный опыт с повторными запусками одного агента охватывал 16 отложенных попыток на задачу; более длинный горизонт изучали только как покрытие пула разных систем, без общего проверяющего механизма. При выборе ответа с максимальной оценкой SPLIT не превзошёл простую подгонку кривой, поэтому переносить выводы на любой вариант best-of-N пока нельзя.
Практический результат — не готовый универсальный коэффициент, а схема измерений. Если цена ошибки или вывода оправдывает размеченную пробу, команда может определить, где следующий вызов принесёт больше пользы: в генерации, разнообразии моделей или проверке.
Источники
Иллюстрация: рисунок из статьи «Sample, Mix, or Verify? Allocating Test-Time Compute under Imperfect Verifiers», Srinivasan Iyengar, CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


