
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Ложные начала речи у полнодуплексных моделей удалось подавить без дообучения и без возврата к жёсткому чередованию реплик. Kento Nishi отсеял 13 из 13 таких случаев у Moshi и 9 из 9 у PersonaPlex, сохранив по 40 из 40 настоящих ответов. Хотя препринт не рецензирован и все числа получил сам автор, метод даёт командам конкретный защитный слой для уже развёрнутых моделей.
Модель решает заговорить за один кадр
Полнодуплексная речевая LLM одновременно принимает звук пользователя и генерирует собственную речь. Ей не нужен явный сигнал, что реплика закончилась: модель сама выбирает момент ответа, может перебивать, реагировать на перебивание и поддерживать разговор с наложением голосов.
Такая схема создаёт отдельный класс ошибки. После ответа модель продолжает генерировать служебные и неречевые элементы, даже если пользователь молчит. Накопленная собственная история иногда приводит её к новой фразе без внешнего повода.
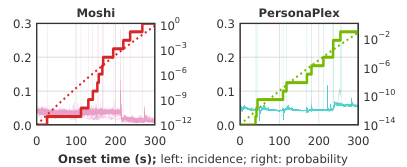
В пяти минутах цифровой тишины Moshi самопроизвольно заговорила в 30% прогонов, PersonaPlex — в 27,5%. Проверка охватывала по 40 продолжений официальных контрольных версий моделей с исходными настройками выборки.
Причиной оказался не небольшой шанс речи, который рано или поздно реализуется при многократной выборке. Перед каждым зафиксированным началом вероятность речевого элемента возрастала более чем на девять порядков за один кадр длительностью 80 мс и становилась близкой к единице.
Поэтому ограничение top-k не решает проблему. Оно отбрасывает элементы с низкой вероятностью, но в момент ошибки речь уже находится в верхней части распределения. По одному скачку тоже нельзя заблокировать начало: настоящие ответы возникают таким же образом.
Как контрфактическая проверка отделяет ответ от сбоя
Метод проверяет не силу намерения говорить, а его зависимость от последней реплики пользователя. Для каждого предложенного начала речи система строит две версии ближайшего продолжения.
- Основная версия получает реальный звук пользователя и сохраняет обычную историю диалога.
- Контрфактическая версия стартует из того же потокового состояния, но вместо последней пользовательской реплики получает тишину.
- Обеим версиям передают одинаковые ранее сгенерированные текстовые элементы, чтобы различие возникало только из-за входного звука.
- Система сравнивает распределения следующего элемента через дивергенцию Jensen–Shannon — симметричную меру различия двух распределений вероятностей.
Если замена реплики тишиной почти не меняет предсказание, предлагаемая фраза не зависит от пользователя и её подавляют. Если распределения заметно расходятся, начало считают настоящим ответом и выпускают в звуковой поток.
Порог выбирают на отдельных калибровочных прогонах. Низкий порог отдаёт приоритет сохранению ответов, высокий — подавлению ложной речи. В эксперименте оценки настоящих и ложных начал разделились полностью, но более агрессивный вариант порога уже отбрасывал часть корректных ответов.
Детектор голосовой активности здесь нужен только для поиска состояния перед пользовательской репликой. Он не закрывает ход пользователя и не решает, когда модели разрешено говорить, поэтому система сохраняет полнодуплексное поведение.
Метод стоит закладывать как защитный слой, а не свойство модели
Для команды, которая внедряет Moshi или PersonaPlex, работа меняет план вывода в эксплуатацию. Полагаться на настройки выборки и ожидать, что длительная тишина останется тишиной, нельзя. Нужны сохранение потокового состояния, параллельный проход с заглушённым звуком и порог, настроенный на целевой акустике.
Дополнительное вычисление укладывается в потоковый режим: на одной NVIDIA RTX PRO 6000 время решения в 95-м процентиле не превысило 61 мс при бюджете кадра 80 мс. Это показывает техническую выполнимость, но не определяет требования к другим GPU или числу одновременных разговоров.
Проверка охватывала две родственные модели, один запрос и запись фонового шума с одного устройства. Moshi и PersonaPlex используют сходную организацию звуковых и текстовых потоков, поэтому результат нельзя напрямую переносить на полнодуплексные модели с другой архитектурой.
Есть и смысловой риск. Если пользователь попросит модель заговорить через десять секунд, а затем продолжит говорить, заглушение только последней реплики может скрыть причину отложенного ответа. Для таких сценариев точку ветвления придётся выбирать с учётом нескольких реплик, а не только по ближайшему участку голоса.
Работа не даёт универсального контроллера очередности речи. Она предлагает практическую проверку для существующих Moshi и PersonaPlex: перед выпуском каждой новой фразы установить, изменила ли пользовательская речь решение модели. Такой слой стоит тестировать отдельно на реальных голосах, микрофонах и типах диалога продукта.
Источники
Иллюстрация: рисунок из статьи «Causal Analysis and Mitigation of Spurious Onsets in Full-Duplex Speech LLMs», Kento Nishi, CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


