
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Переводческую систему научили обращаться к внешним источникам только для фраз, которым действительно не хватает контекста, и искать сведения под итоговый перевод. В работе The University of Texas at Austin и Amazon, которая не прошла рецензирование, авторы сами получили все числа: выборочный поиск снизил штраф MQM относительно постоянного поиска на 5,4–20,6% — эта метрика учитывает типы и тяжесть ошибок. Политику поиска можно отделить от переводчика и обучать даже поверх закрытой модели без изменения её параметров.
Почему поиск не стоит включать для каждого перевода
В обычной схеме система сначала находит похожие документы, а затем добавляет их в запрос к LLM. Такой поиск помогает с идиомами, терминами, именами и фоновыми знаниями, но применяется одинаково ко всем входным текстам.
Для перевода это не всегда полезно. Модель уже знает достаточно для многих фраз, а лишний документ может отвлечь её или подсказать неверный вариант. При этом наиболее похожий по смыслу текст не обязательно содержит нужное толкование идиомы или принятое написание имени.
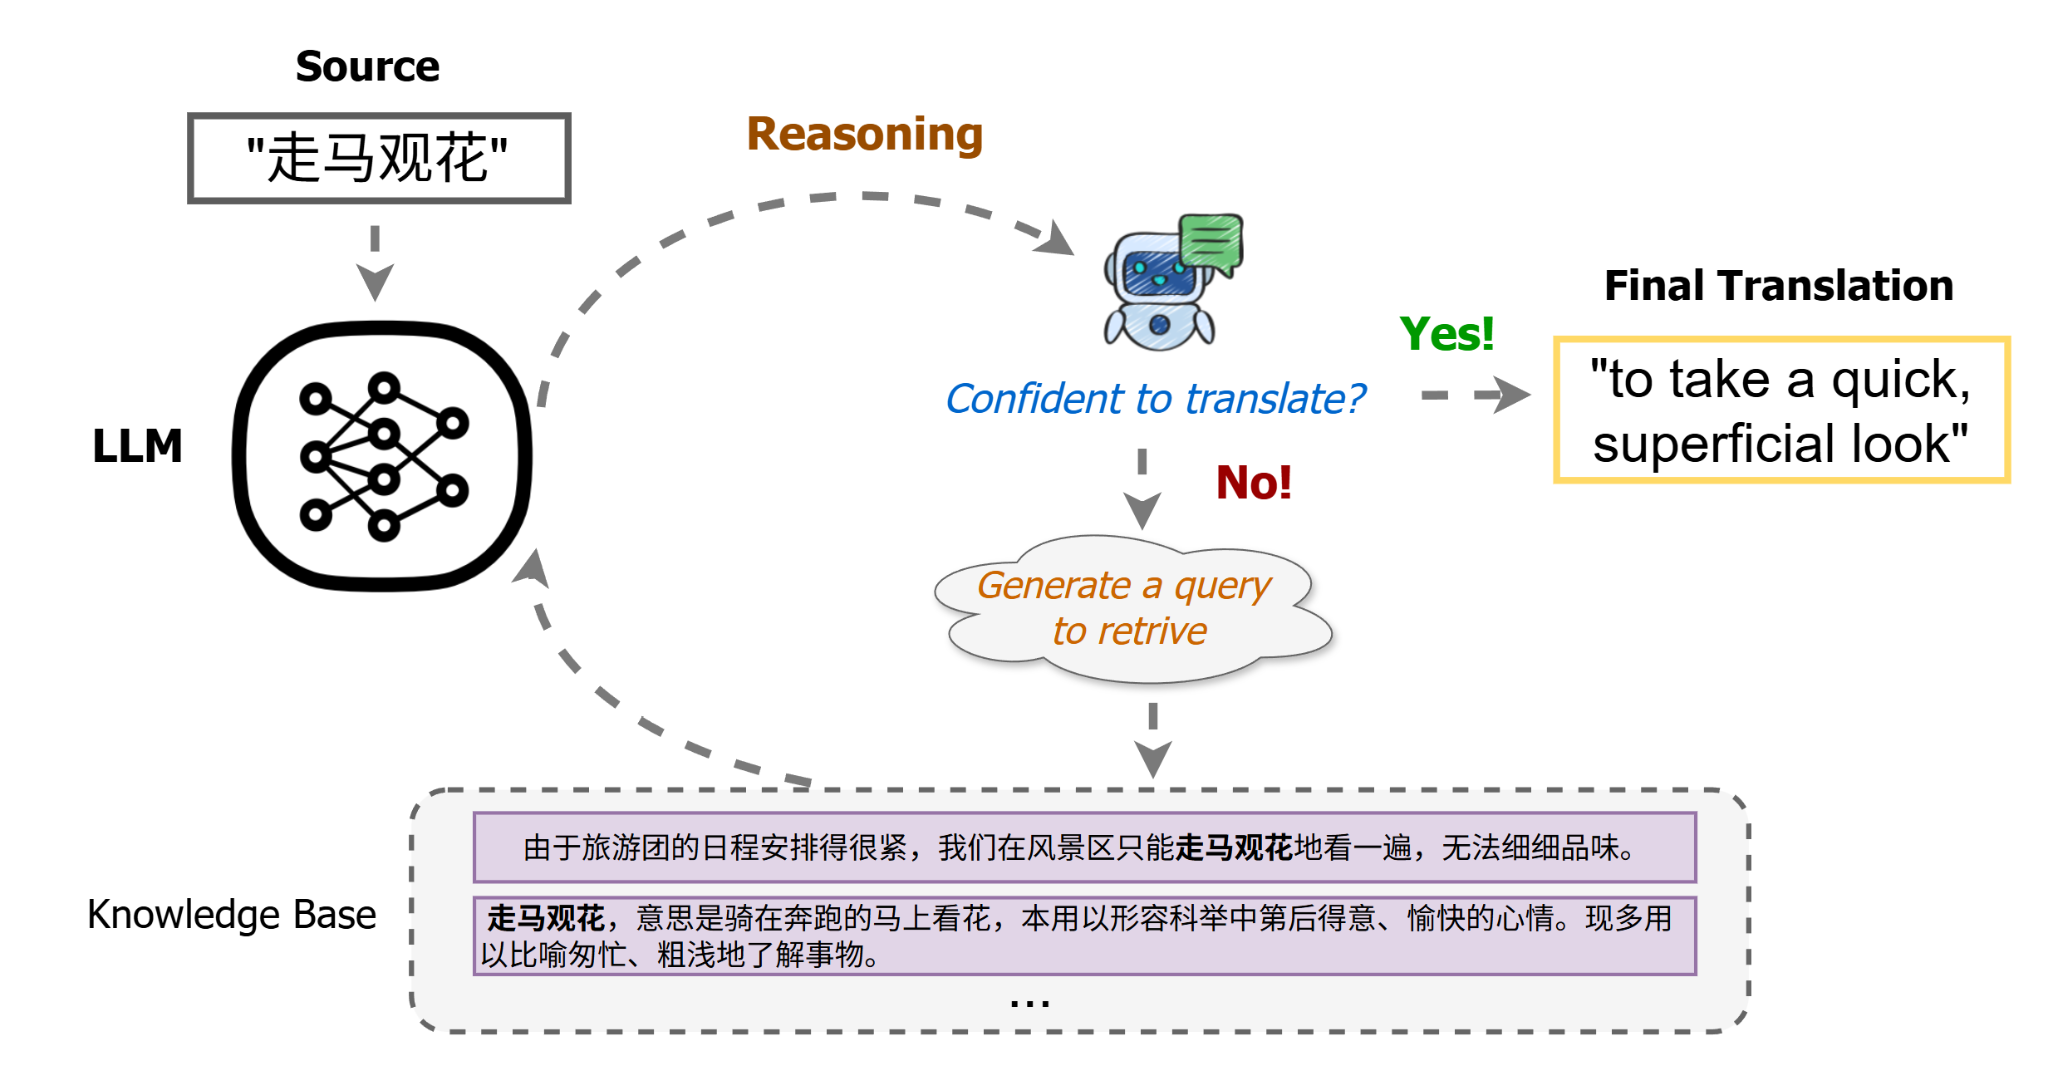
SRAT рассматривает рассуждение, поиск и перевод как доступные модели действия. Она может сразу выдать перевод, сформулировать запрос к внешнему корпусу или изучить найденный документ и повторить поиск. Решение принимает одна обучаемая политика, поэтому отдельный классификатор сложных фраз и заранее заданная доля запросов не нужны.
Это отличает перевод от поиска ответа. Документ редко содержит готовую целевую фразу: чаще он лишь уточняет смысл, после чего переводчик должен сам выбрать формулировку. Поэтому полезность документа определяет не сходство с запросом, а его влияние на конечный текст.
Как итоговый перевод обучает поиск
Во время обучения для одного исходного текста создают несколько траекторий. Они различаются рассуждениями, поисковыми запросами, выбранными документами и переводами. Награда объединяет COMET, который оценивает смысловое соответствие перевода, и вердикт модели-оценщика; отдельные штрафы учитывают сломанный формат и повторы.
Алгоритм GRPO сравнивает траектории внутри одной группы. Если вариант с поиском дал лучший перевод, система повышает вероятность такого поведения. Если прямой перевод оказался лучше, она учится обходиться собственными знаниями. Размечать примеры на категории «искать» и «не искать» не требуется.
Обучение с нуля легко сводится к отказу от поиска: первые запросы получаются слабыми, поэтому прямой перевод чаще выигрывает. SRAT сначала отбирает лучшие 40% заранее созданных траекторий с поиском и обучается повторять их. Затем временный штраф уводит систему от привычки искать всегда, после чего остаётся только награда за качество перевода.
Отдельная задача — научить сам модуль поиска выбирать полезные документы. В первом варианте ранжирование Plackett–Luce случайно выбирает документы с учётом их оценок, благодаря чему итоговая награда обновляет и переводчик, и поисковый модуль. Но сигнал получается шумным: один результат нужно распределить между множеством решений модели и несколькими выбранными документами.
Контрастное обучение даёт поиску более прямую обратную связь. Переводчик фиксируют, каждый документ-кандидат по очереди добавляют к одному исходному тексту, а затем сравнивают получившиеся переводы. Документ, который дал лучший результат, становится положительным примером. Такой способ требует дополнительных прогонов, зато учит искать то, чем конкретный переводчик умеет воспользоваться.
При работе системы эталонный перевод и модель-оценщик уже не нужны. Политика сама решает, вызывать ли поиск, а число обращений и длину ответа можно ограничить бюджетом.
Когда SRAT меняет архитектуру продукта
SRAT проверяли на переводе идиом, текстах с внешними знаниями и документах. Первые два сценария использовали подготовленные корпуса, а документный перевод с английского на русский — поиск в интернете. Систему сравнивали с прямым переводом, постоянным поиском и несколькими вариантами обучения с учителем.
Доля обращений к источникам не сошлась к одному правилу. На IdiomKB она менялась от 30,6 до 77% в зависимости от направления перевода, на RAGtrans составляла примерно половину входов, а в документном переводе достигла 88,6%. Значит, фиксированный переключатель «искать всегда» не воспроизводит выученное поведение.
Настройка поискового модуля особенно помогла на RAGtrans, где смысловое сходство хуже отражало полезность документа. Контрастный вариант улучшил MQM ещё на 6,8–7,4%. На задаче с идиомами, где исходный поиск уже часто находил подходящее объяснение, дополнительный выигрыш был меньше.
Политику также подключили к замороженной Claude Sonnet 4.6: Qwen решала, когда искать, формировала запрос и собирала контекст, а Claude только переводила. На RAGtrans штраф MQM снизился на 12,4–16,8% относительно прямого перевода Claude. Простая инструкция самой Claude обращаться к поиску давала непостоянный результат.
Для продукта это аргумент не за новый переводчик, а за отдельный обучаемый слой перед ним. Такая схема подходит потоку, где простые фразы перемешаны с терминами, идиомами и документами, требующими внешнего контекста. При этом SRAT не лидировал по BLEU, который измеряет совпадение словесных фрагментов с эталоном: метод оптимизировали под смысловые и экспертные оценки, а не под близость формулировок.
Перенос в рабочую систему всё равно потребует собственных замеров задержки и стоимости поиска. Эксперименты показывают выигрыш в качестве и уменьшение лишних обращений, но не заменяют проверку на реальном корпусе, выбранном поисковом сервисе и допустимом времени ответа.
Источники
Иллюстрация: рисунок из статьи «Retrieve What Helps, Only When It Helps: Agentic Reinforcement Learning for Selective Retrieval-Augmented Machine Translation», Shijun Li, Yang Liu, Najmeh Sadoughi и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


