
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Языковую модель научили улучшать математические рассуждения на собственных решениях без эталонных ответов и предварительного выбора правильной траектории. В нерецензированном препринте, где все числа получили сами авторы, показатель Qwen3-4B на AIME24–26 вырос с 19,07% до 45,46%. Для команд это открывает вариант постобучения на неразмеченных задачах, но пока только в узкой математической постановке.
Как извлечь пользу из ответа с ошибкой
Обычные методы постобучения сначала решают, какому ответу доверять. GRPO использует проверяемую награду, дистилляция — ответы внешнего учителя, а обучение по мнению большинства превращает самый частый итог в псевдоэталон. Если проверить результат нельзя, ошибка в последней строке обесценивает всю траекторию, хотя промежуточные шаги могли быть полезны.
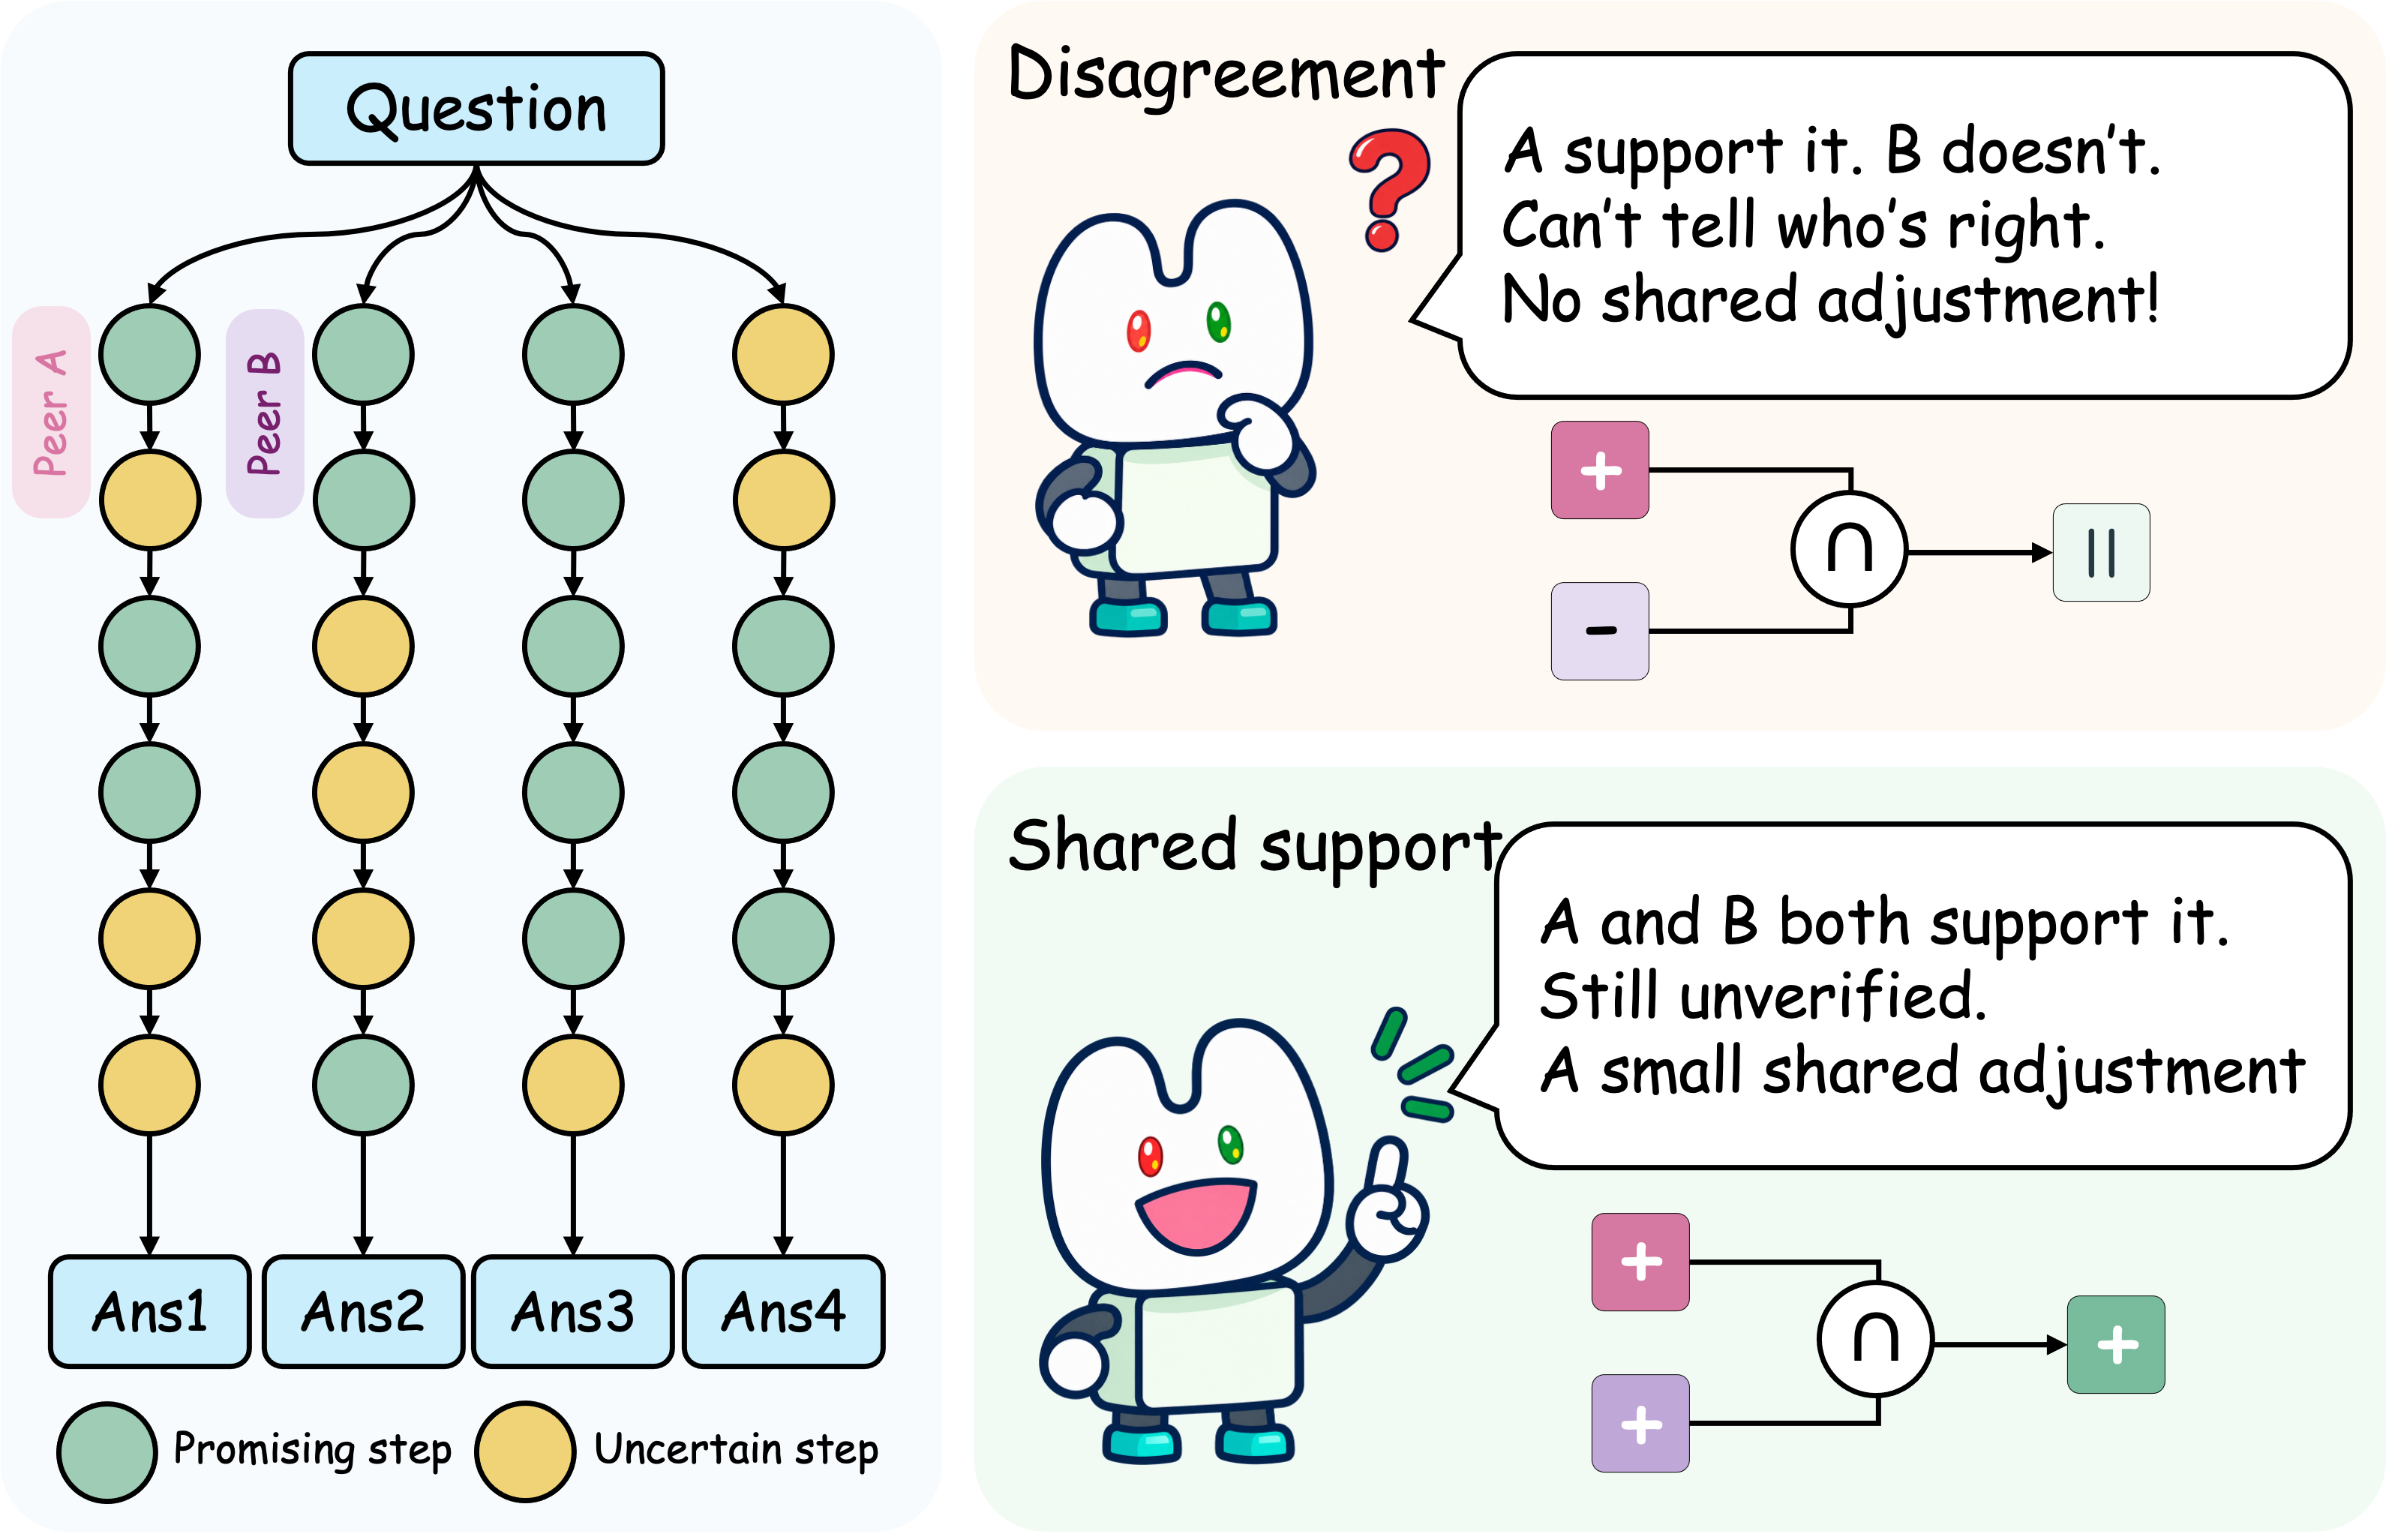
Shared Residual Distillation, или SRD, не оценивает решения целиком. Модель генерирует несколько вариантов для одной задачи, после чего её замороженная исходная копия смотрит, как каждый вариант меняет распределение вероятностей следующего токена. Метод сохраняет только изменения, у которых совпадает направление, и ограничивает их величину самым слабым совпавшим сигналом.
Контрольным примером служит решение другой задачи из той же учебной пачки. Оно помогает отделить влияние содержательной подсказки от общих эффектов длинного дополнительного текста — например, склонности продолжать доказательство в похожем стиле. Итоговую поправку накладывают на прогноз замороженной модели без дополнительных решений.
На основном опыте для каждой задачи генерировали четыре траектории: две становились подсказками, ещё две — материалом для обучения. Студент видел только условие и уже написанную часть собственного ответа. После постобучения ему больше не нужны ни соседние решения, ни контрольный пример, поэтому сам механизм SRD не добавляет вызовов модели при использовании.
Согласие шагов оказалось полезнее усреднения
Метод проверяли на трёх размерах Qwen3 и на математическом наборе OpenThoughts. Качество оценивали на AIME, HMMT и MATH-500; отдельно проверяли следование инструкциям на IFEval и общие знания на MMLU-Pro. Средняя доля правильных ответов по нескольким запускам выросла и на младшей, и на старшей модели: у старшей версии результат AIME поднялся с 21,39% до 54,44%.
Контрольные опыты показывают, что результат даёт не простое добавление чужих рассуждений. Если для совпавших поправок брать среднюю величину вместо самой осторожной, качество на AIME оказывается почти на 8 процентных пунктов ниже. Замена решения другой задачи обычным прогнозом модели тоже ухудшила итог, поэтому контрольный контекст работает как содержательная часть метода.
На IFEval и MMLU-Pro обученные модели не уступили исходным в проведённых замерах. Это снижает риск того, что математическое постобучение сразу испортит общие возможности, но не доказывает сохранность поведения на прикладных сценариях, которых не было в проверке.
Улучшение рассуждений также потребовало более длинных ответов: у средней модели их размер вырос примерно на 61%. Дополнительные решения не нужны после обучения, однако стоимость использования может увеличиться из-за большей генерации. Кроме того, лучшие контрольные точки появлялись раньше конца расписания, а затем качество части моделей снижалось — длительность постобучения придётся подбирать отдельно.
Когда SRD может изменить план постобучения
Работа меняет выбор метода для продуктов, где накоплено много задач без ответов, а результат нельзя автоматически проверить. Вместо разметки или внешней модели-учителя команда может генерировать несколько собственных решений и извлекать учебный сигнал из совпадающих локальных шагов. Это особенно уместно, если ошибочный итог не означает, что вся цепочка бесполезна.
Экономия на разметке не означает дешёвое обучение. Для каждого фрагмента ответа замороженная модель должна отдельно оценить обычный контекст, контроль из другой задачи и каждую подсказку. К этому добавляются несколько полных траекторий, поэтому до выбора SRD нужно сравнить вычислительные расходы с ценой проверяемой награды, синтетической разметки или внешнего учителя.
Перестраивать вокруг SRD обучение универсального помощника пока рано. Эксперименты охватывают математические задачи и модели одного семейства, а на открытых запросах метод не проверяли. Согласие нескольких решений также не гарантирует правильность: модели могут повторить одну ошибку, а посторонний контрольный пример способен сам изменить направление поправки.
Практичный следующий шаг — небольшой опыт на собственном домене с фиксированным бюджетом генерации. Сравнивать стоит не только точность, но и длину ответа, устойчивость после дополнительных шагов обучения и качество на прежних задачах продукта. Если локальное согласие даёт прибавку без псевдоэталонов, SRD позволяет отложить разметку; если нет, работа не предлагает способа проверить, где именно модель коллективно ошиблась.
Источники
Иллюстрация: рисунок из статьи «Learning from Unverified Peers via Shared Residual Distillation», Feiyang Chen, Runze Ma, Zichen Wang и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


