
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Пост-дообучение LLM научились автоматизировать так, чтобы система сама составляла набор допустимых решений под конкретные задачи, а затем повторно комбинировала удачные варианты. В работе Oxford, LIGHTSPEED и Cambridge метод SRO набрал 53,8 балла против 40,8 у сильнейшей альтернативы в одном из многодоменных запусков; поскольку препринт не рецензирован, эти числа получили сами авторы. Для команды это превращает серию разрозненных экспериментов в переносимую схему поиска, но пока не доказывает экономию на крупных производственных моделях.
Пространство рецептов меняется вместе с задачей
Автоматизация пост-дообучения обычно выбирает между двумя подходами. Можно заранее перечислить допустимые наборы данных, способы обработки и параметры обучения, а затем систематически искать лучшее сочетание. Такой поиск хорошо сравнивает варианты, но не добавляет решения, которые нужны именно новой задаче.
Другой вариант — поручить весь эксперимент LLM-агенту. Он может найти данные, изменить обучение после неудачного запуска и предложить нестандартный ход. Однако такие изменения часто остаются внутри одного эксперимента: агент не оформляет их как отдельные варианты, которые можно сравнивать и сочетать в следующих запусках.
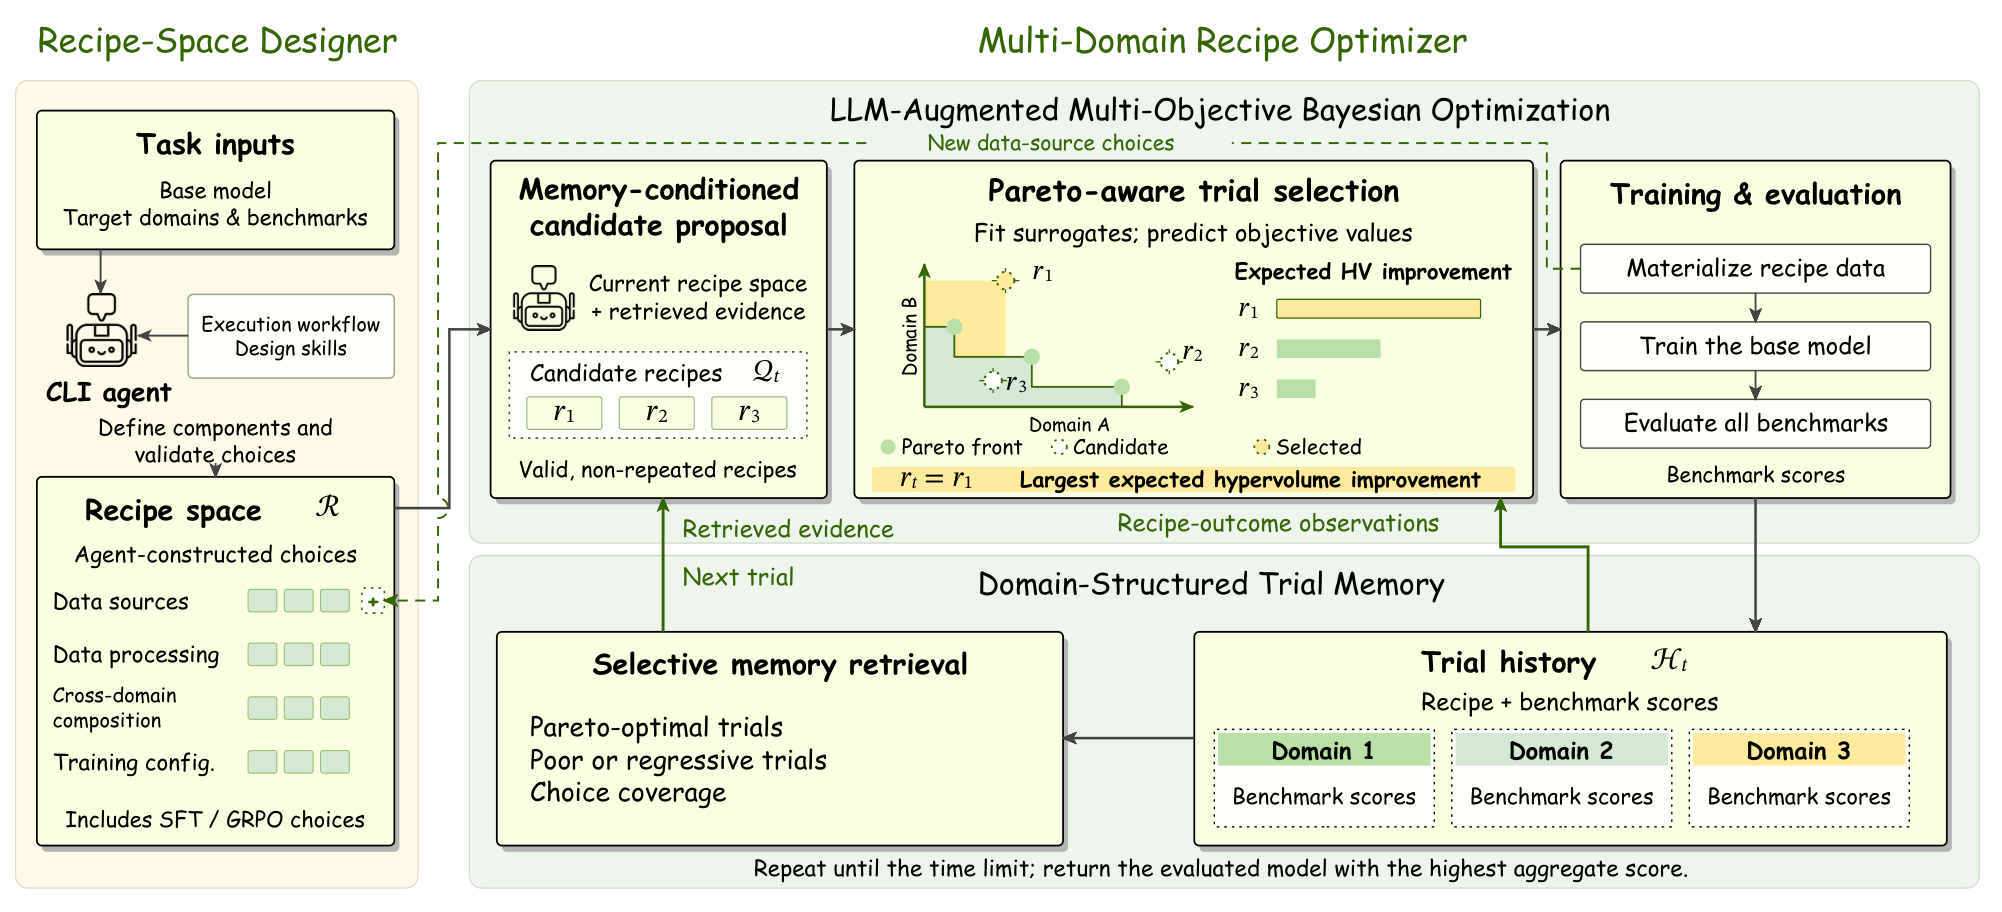
SRO совмещает эти подходы. Сначала LLM составляет пространство рецептов для заданных областей. Каждый рецепт разбит на явные компоненты: источники данных, способы их обработки, пропорции между областями и настройки обучения. Для каждого компонента агент предлагает несколько допустимых вариантов.
Отдельный исполняемый процесс загружает и форматирует данные, запускает обучение и оценку, проверяет рецепты и не допускает попадания тестовых примеров в обучающую выборку. Поэтому агент меняет содержательные решения, а не пишет новый конвейер для каждого эксперимента. Рецепты остаются сопоставимыми и пригодными для повторного запуска.
Пространство поиска при этом не застывает после старта. Если один из рецептов создаёт новый набор примеров через переписывание заданий или исправление ошибок модели, система проверяет этот набор и регистрирует его как новый источник. Следующий рецепт уже может сочетать эти данные с другой пропорцией областей или другим способом обучения.
Предложение рецепта отделено от дорогого запуска
SRO хранит каждый завершённый эксперимент как пару из рецепта и оценок по отдельным областям. История не сводится к одному среднему баллу: система видит, что изменение помогло программированию, но ухудшило ответы по медицине. Это позволяет искать компромисс, а не незаметно подменять общий прогресс успехом на одном тесте.
Перед следующим запуском система выбирает из истории сильные и слабые рецепты, а также отмечает редко проверявшиеся варианты. LLM получает эту выжимку и собирает несколько кандидатов из доступных компонентов. Она может повторить удачное сочетание, заменить один элемент или проверить малоизученный источник данных.
Запуск выбирает не сама LLM по уверенности в своём ответе. Байесовский оптимизатор строит приближённую модель результатов для каждой области и оценивает, какой кандидат вероятнее улучшит текущий набор компромиссов. Так дешёвое составление кандидатов отделяется от обучения и оценки модели, которые требуют вычислений.
Эта архитектура важнее конкретных подсказок агенту. В собственном конвейере можно заменить модель, систему обучения или способ оценки, сохранив три части: явную схему рецепта, структурированную историю запусков и отдельный механизм выбора следующего эксперимента. Результат каждого запуска тогда становится данными для поиска, а не записью в журнале, которую человеку придётся разбирать вручную.
Менять стоит устройство экспериментов, а не выбор базовой модели
В другом многодоменном запуске SRO получил 41,1 балла против 15,4 у сильнейшей альтернативы. Когда из системы убрали заранее построенное структурированное пространство рецептов, итог на одном из вариантов Qwen снизился с 45,3 до 34,5. Это указывает, что основной вклад даёт не только LLM-агент: важно оформить найденные решения как повторно используемые компоненты.
Метод проверяли на Qwen3-1.7B и Qwen3-4B, а рецепты составляли GPT-5.4 и DeepSeek-V4-Flash. Эксперименты охватывали математические задачи, программирование и работу с инструментами, а также вопросы по науке и здоровью. Все кандидаты проходили обучение и оценку, поэтому сравнение отражает полный цикл, а не качество текстового плана агента.
Работа меняет планы команд, которые уже строят автоматизацию пост-дообучения или регулярно перебирают данные и параметры вручную. Им имеет смысл хранить источники, преобразования и настройки как типизированные варианты, а результаты — раздельно по целевым областям. Это позволит повторно сочетать решения и подключить формальный выбор следующего запуска.
Для команды, которая лишь выбирает базовую LLM или один раз дообучает модель на стабильном наборе данных, SRO не требует перестройки проекта. Исследование измеряет качество сохранённых версий модели на ограниченном наборе небольших Qwen, а не стоимость эксплуатации такой системы на производственном масштабе. Его практический результат — схема экспериментального конвейера, которую ещё нужно проверить на собственных моделях, данных и вычислительном бюджете.
Источники
Иллюстрация: рисунок из статьи «LLM Agents for Automated Post-Training via Structured Recipe Optimization», Ruohong Liu, Bohan Tang, Lekang Jiang и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


