
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Большую языковую модель научились дообучать новым задачам почти без потери прежних навыков. В препринте UC Berkeley, Mila, Google и других организаций, который не прошёл рецензирование и где числа получены самими авторами, модели от 8 млрд параметров после дообучения с SST оставались примерно в пределах одного процентного пункта от исходного качества. Метод может изменить саму схему адаптации моделей: вместо восстановления утраченных возможностей после обучения он защищает их во время каждого обновления весов.
Как SST отделяет новые навыки от старых
Обычное обучение с учителем меняет веса модели во всех доступных направлениях. Новая специализация может затронуть параметры, на которых держатся следование инструкциям, программирование, рассуждения и общие знания. Так возникает катастрофическое забывание: модель лучше решает новую задачу, но хуже справляется с тем, что умела до обучения.
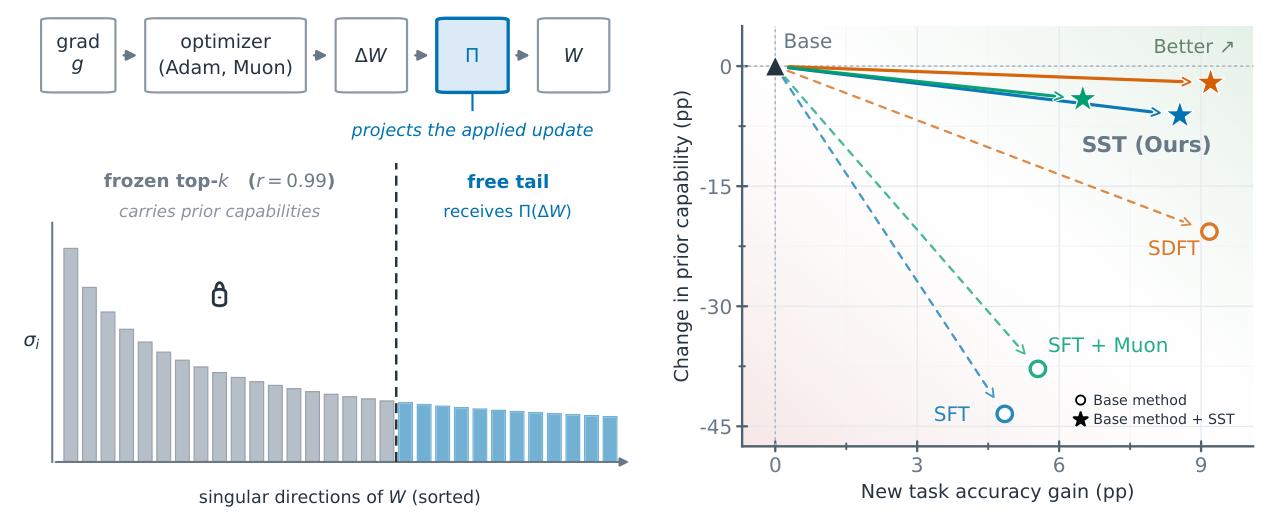
SST исходит из структуры матриц весов. Сингулярное разложение выделяет в каждой матрице главные направления, которые несут основную часть её структуры, и менее выраженный хвост. Метод защищает до 99% главных направлений, а обновления пропускает только через оставшееся подпространство.
Проекция действует с двух сторон: обновление не должно ни читать из защищённых направлений, ни записывать в них. При этом SST не заменяет оптимизатор и не требует отдельной функции потерь. Он берёт шаг, который уже подготовил Adam, Muon или другой оптимизатор, отбрасывает запрещённые компоненты и только затем меняет веса.
Место проекции принципиально. Adam накапливает статистику градиентов и отдельно масштабирует каждую координату, поэтому предварительно ограниченный градиент после обработки снова выходит в защищённое подпространство. В контрольном опыте такая схема пропустила туда 69% итогового изменения. SST ограничивает уже готовый шаг оптимизатора и устраняет эту утечку.
Для длинного обучения авторы добавили обновление защищённого базиса. Оно заново вычисляет главные направления по текущим весам и открывает модели новые пути для адаптации. Частое обновление помогает осваивать задачу, но немного ослабляет защиту исходных навыков; фиксированный базис даёт обратный баланс.
Модель сохраняет код, формат ответов и общие знания
Основные опыты провели на Qwen3-8B, который дообучали на научных, финансовых и медицинских задачах, а также на патологии. Прежние способности проверяли по GPQA-Diamond, MMLU-Pro, GSM8K, HumanEval и IFEval: этот набор охватывает знания, математику, код и следование формату.
Обычное обучение с учителем на разных размерах Qwen3 снижало средний результат прежних задач на 30–40 процентных пунктов. SST при этом сохранял или улучшал качество на новой задаче, поэтому разница возникла не из-за того, что модель просто училась слабее.
Поведение модели тоже оставалось ближе к исходному. Расхождение между распределениями ответов базовой и дообученной модели оказалось в 2–4 раза меньше, чем у обычных схем. Это проявлялось в деталях, которые средняя точность скрывает: модель сохраняла привычную длину рассуждения, реже переставала выдавать компилируемый код и лучше соблюдала запрошенный формат.
SST сочетался как с обычным обучением с учителем, так и с самодистилляцией, когда модель учится на собственных переработанных ответах. В последовательном обучении новый навык поднимался после своего этапа и удерживался на следующих, тогда как без ограничения весов очередная специализация ухудшала предыдущую.
Когда SST стоит включать в план дообучения
SST меняет планы команд, которые адаптируют открытые модели на собственных данных и при этом рассчитывают сохранить универсальные возможности основы. Вместо одной проверки качества на целевой задаче понадобится второй контур оценки: код, рассуждения, формат ответов и другие способности, ради которых выбрали базовую модель.
Метод требует доступа к итоговому шагу оптимизатора и сингулярным направлениям матриц. Поэтому его можно встроить в собственный цикл обучения, но нельзя воспроизвести по описанной схеме через сервис, который скрывает обновления весов. Начинать разумно с фиксированного базиса, а обновление направлений добавлять, если защищённый хвост ограничивает освоение новой задачи.
Проверки охватывают модели Qwen и Olmo, разные оптимизаторы, несколько предметных областей и масштаб до 32 млрд параметров. Последовательные опыты ограничены короткими цепочками задач, поэтому работа пока обосновывает SST как кандидата на стандартную схему дообучения, а не как универсальную гарантию для любой модели и длительной эксплуатации.
Источники
Иллюстрация: рисунок из статьи «Towards Continual Learning: Mitigating Forgetting With Subspace Tuning», Arnav Chavan, Kusha Sareen, Rishabh Tiwari и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


