
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Готовую LLM расширили статической памятью так, чтобы не переучивать её с нуля и почти не замедлять генерацию. В работе Ranajoy Sadhukhan и соавторов STAPLE обошёл продолжение обычного плотного обучения и MoE по среднему качеству, хотя препринт не рецензирован и числа получили сами авторы. Для команд с собственными весами это добавляет ещё один путь масштабирования помимо увеличения плотной модели и смеси экспертов.
Новая память дополняет вычисления, а не заменяет их
STAPLE добавляет в выбранные слои таблицы, где каждой единице словаря соответствует отдельная строка параметров. Когда модель обрабатывает токен, она извлекает только связанную с ним строку. Доступ известен заранее, поэтому таблицу можно хранить вне GPU и подгружать нужные части.
Предшествующий метод STEM заменял такой таблицей одну из обученных проекций полносвязного блока. Это экономило вычисления, но заставляло новую память заново осваивать функцию удалённого компонента. При ограниченном дообучении редкие строки таблицы получали слишком мало обновлений, поэтому STEM не догонял плотную исходную модель.
STAPLE сохраняет обученную проекцию и прибавляет к её результату строку из таблицы. Плотный путь продолжает выполнять прежние вычисления, а память учит дополнительную информацию, связанную с конкретными токенами. Анализ направлений векторов показал, что новые строки не копируют выход сохранённой проекции, а дополняют его.
Таблицы сначала заполняют нулями, поэтому сразу после расширения модель ведёт себя как исходная. Затем следует короткий разогрев на части корпуса предобучения: старые проекции временно замораживают, чтобы обновлялась новая память. Для этого этапа использовали около 2,5% исходного корпуса; сильнее всего он помог задачам на общие знания и здравый смысл, но не дал устойчивого выигрыша в математике и программировании.
Ёмкость можно наращивать двумя способами: добавлять таблицы в большее число слоёв или увеличивать размер строк. Авторы также проверили низкоранговый вариант, который сжимает строки и восстанавливает нужную размерность обучаемой проекцией. Качество при таком сжатии немного снизилось, но осталось выше продолжения плотного обучения.
Таблицы остаются в оперативной памяти сервера
Главная системная деталь STAPLE — параметры памяти не обязаны постоянно занимать видеопамять. Полные таблицы хранятся в оперативной памяти сервера, а на GPU передают только строки для токенов текущего пакета. Около 5% самых частых строк остаются в видеокэше.
При генерации система заранее запрашивает строки для следующих слоёв и совмещает передачу с вычислениями предыдущих. При обработке входного текста одинаковые токены объединяют, чтобы не копировать одну строку несколько раз. Во время обучения оптимизатор также обновляет только строки, к которым обращался текущий пакет, а его состояния остаются на стороне центрального процессора.
Такой подход не устраняет стоимость памяти, а переносит её из видеопамяти в оперативную память сервера и добавляет обмен по PCIe. Результат зависит от того, удаётся ли скрыть передачу данных за вычислениями трансформера. Поэтому реализация использует асинхронную загрузку, отдельные потоки и заранее закреплённые области памяти, а не просто размещает таблицу на центральном процессоре.
Когда STAPLE меняет план развития модели
Основные опыты провели на OLMo-2 1B, а сохранение выигрыша проверили на OLMo-2 7B. STAPLE сравнивали с продолжением плотного обучения, STEM, моделью в стиле Engram и вариантом MoE. Качество оценивали на программировании, математике, общих знаниях, здравом смысле и понимании текста.
На HumanEval прибавка к продолжению плотного обучения составила 4,27 пункта. Улучшения также получили на MBPP, GSM8K и DROP, а самый заметный средний выигрыш пришёлся на программирование. Рост числа дополненных слоёв и размера памяти повышал средний результат, то есть дополнительная ёмкость не осталась неиспользованной в пределах этих опытов.
Системные замеры выполнили на NVIDIA B200. При ориентированной на пропускную способность генерации STAPLE декодировал в 2,04 раза быстрее проверенного MoE, занимал меньше половины его видеопамяти и отставал от плотной модели по скорости не более чем на 1,5%. Обучение также осталось близким по пропускной способности к плотному варианту, хотя таблицы и состояния оптимизатора занимали значительный объём оперативной памяти сервера.
Работа меняет планы команд, у которых есть доступ к весам и инфраструктуре обучения: вместо переноса модели на MoE можно сначала проверить остаточную статическую память. Этот вариант особенно уместен, когда видеопамять ограничивает размер пакета или кэш внимания, но сервер располагает достаточной оперативной памятью и быстрым соединением с GPU.
Для моделей, доступных только через API, рецепт неприменим: он требует менять слои, обучать новые параметры и контролировать систему загрузки. Перенос на другие архитектуры и оборудование тоже потребует собственных замеров, поскольку в работе проверены два масштаба одной серии моделей и конкретный серверный ускоритель.
Статическая память допускает точечное редактирование: замена строки одного числового токена заставила модель согласованно пересчитать все последующие шаги арифметического решения. Этот опыт показывает, что таблица влияет на дальнейшее рассуждение, но не доказывает надёжность редактирования фактов в общем случае. Практическая ценность STAPLE пока убедительнее как способ недорого добавить ёмкость готовой модели, чем как универсальный механизм управления знаниями.
Источники
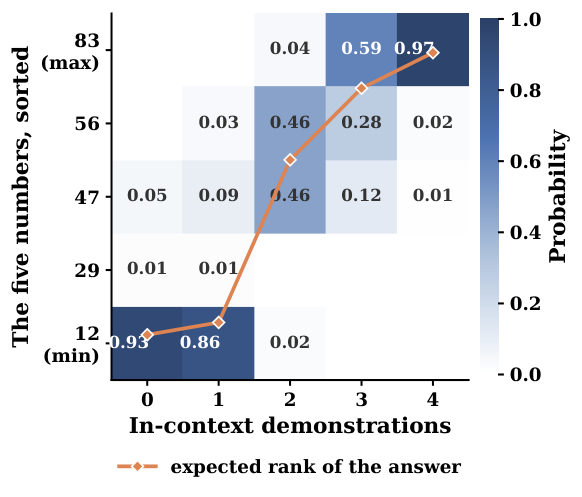
Иллюстрация: рисунок из статьи «STAPLE: Static Sparse Upcycling of Pretrained Checkpoints via Embedding Modules», Ranajoy Sadhukhan, Euijin Hong, Sheng Cao и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


