
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Меньшая языковая модель стала чаще доводить до конца многошаговые задания после обучения у крупной модели. Хотя препринт не прошёл рецензирование и числа получили сами авторы, State-OPD поднял среднюю долю успеха Qwen3-4B с 26,07 до 31,74%. Метод меняет не устройство агента, а контекст учителя и распределение вычислений во время обучения.
Прежние рассуждения ученика сбивают учителя
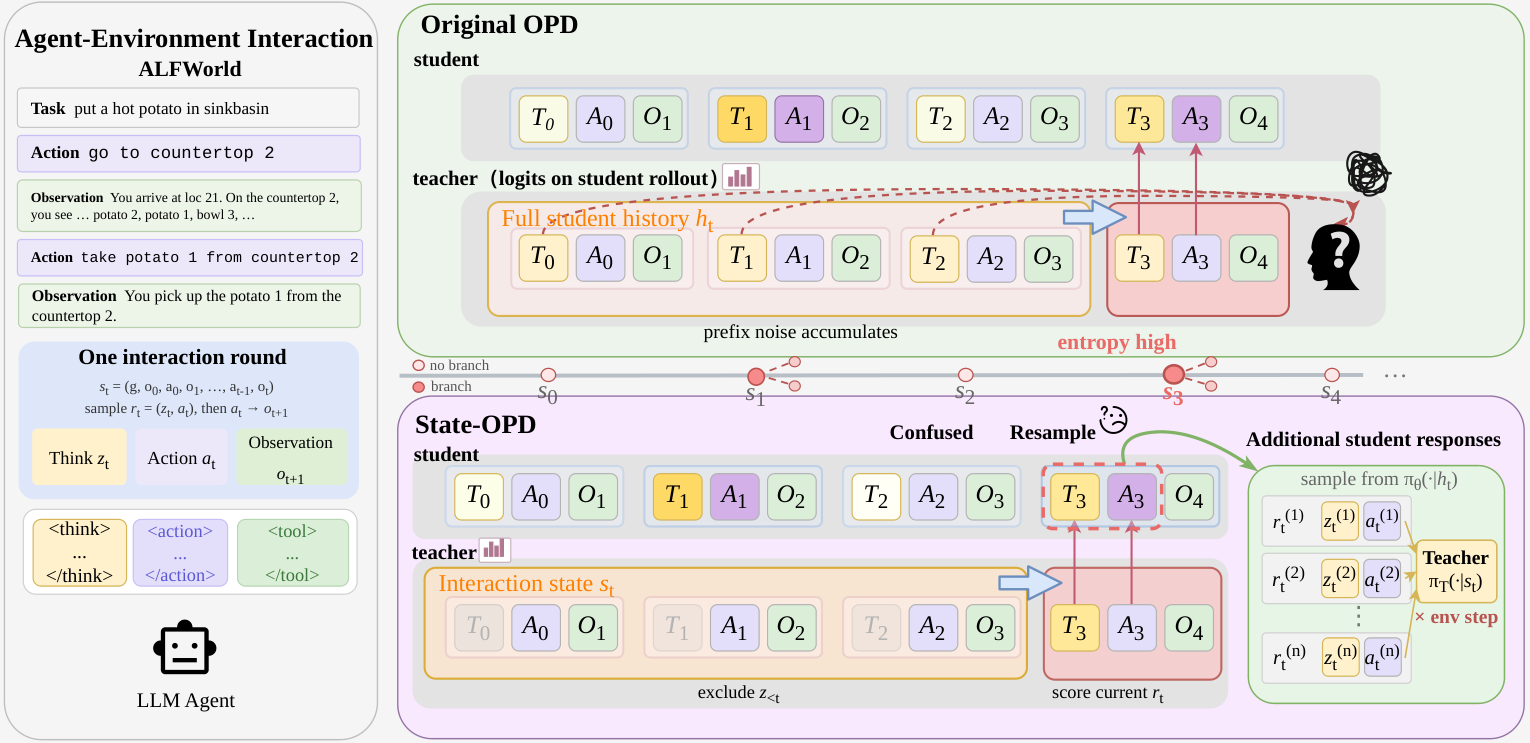
При дистилляции на собственных ответах ученик выполняет задания, а более крупная модель оценивает каждый следующий токен. В многошаговом агенте контекст постепенно накапливает инструкцию, наблюдения среды, выполненные действия и внутренние рассуждения ученика.
State-OPD разделяет эту историю на две части. Состояние взаимодействия содержит исходное задание, совершённые действия и ответы среды. Рассуждения, которыми ученик объяснял прежние решения, в состояние не входят.
Такое разделение опирается на простое условие: ответ модели влияет на среду только через исполненное действие, а среда возвращает результат в наблюдении. Тогда прежнее рассуждение ничего не добавляет к сведениям о фактическом состоянии задачи, но может направить учителя вслед за ошибочной интерпретацией ученика.
Авторы проверили это на одинаковых состояниях ALFWorld. Учитель Qwen3-32B продолжал одну и ту же траекторию либо с полной историей ученика, либо только с действиями и наблюдениями. Без унаследованных рассуждений учитель успешнее завершал задачи во всех проверенных частях траектории, а на поздних шагах преимущество доходило до 20,3 процентного пункта.
Изменялся и сам обучающий сигнал. Когда учитель видел полную историю, его распределение ответов на поздних шагах становилось ближе к ответам ученика, хотя завершать задачу он начинал хуже. Это означает, что малое расхождение между моделями не всегда говорит о хорошем обучении: учитель мог просто перенять ошибочную линию рассуждений из контекста.
Бюджет выборки перенесли на неоднозначные состояния
Удалять прежние рассуждения полезно только из контекста учителя. Ученик по-прежнему получает полную историю: она нужна, чтобы его ответы во время обучения совпадали с теми, которые он будет генерировать после запуска.
Текущие рассуждения играют другую роль. Они определяют, какие действия модель вообще рассмотрит. Если зафиксировать одну цепочку рассуждений и повторно выбирать только действие, модель часто возвращает один и тот же вариант. В эксперименте это произошло у 88,5% состояний. При повторной генерации полного ответа — рассуждения вместе с действием — доля таких состояний снизилась до 44,3%.
State-OPD поэтому измеряет неопределённость полного ответа в каждом посещённом состоянии. Чем равномернее модель распределяет вероятность между вариантами токенов, тем выше неопределённость и тем больше шанс найти другое действие. Дополнительные полные ответы генерируются прежде всего для таких состояний.
Эти варианты не исполняются в среде и не создают новые ветви траектории. Они только расширяют набор решений, на которых учитель обучает модель. Метод сохраняет примерно тот же бюджет контролируемых ответов, но концентрирует его на меньшем числе состояний, где дополнительная выборка приносит больше альтернатив.
Планы стоит менять для агентов с доступным состоянием среды
Метод проверяли с учениками Qwen3-1.7B и Qwen3-4B, учителем Qwen3-32B и тремя текстовыми средами: ALFWorld, ScienceWorld и WebShop. Они моделируют бытовые действия, научные задачи и покупки. Во всех пяти режимах оценки State-OPD показал лучшую среднюю долю успеха среди рассмотренных способов обучения для обоих размеров ученика.
На знакомых заданиях ALFWorld ученик Qwen3-4B достиг 43,39% успеха против 38,39% у учителя. Этот результат не означает общего превосходства меньшей модели: он получен в одном режиме одной среды. Зато он показывает, что дистилляция может приспособить ученика к конкретной интерактивной задаче лучше исходного учителя.
На ALFWorld преимущество сохранилось при меньшем объёме обучения: State-OPD обработал около 286 тысяч ответов на отдельных шагах против 302 тысяч у обычной дистилляции. Разбор компонентов также показал, что пользу дают обе части метода, но очистка контекста учителя влияет сильнее, чем перераспределение выборки.
Работа меняет планы команд, которые уже обучают агентов на собственных траекториях. Вместо передачи учителю всего журнала следует хранить отдельно исполненные действия, наблюдения среды и внутренние рассуждения модели. Это требует формального состояния взаимодействия и возможности восстановить его без скрытых сведений из рассуждений.
В описанной реализации также нужен доступ к вероятностям токенов учителя, поэтому метод нельзя без изменений перенести на любой закрытый API. На этапе выполнения агент остаётся прежним: дополнительные ответы, крупная модель и расчёт неопределённости нужны только при обучении.
Для процессов, где действие однозначно меняет систему, а результат полностью попадает в журнал, State-OPD даёт практическую схему подготовки данных. Если часть состояния скрыта в памяти агента или не отражается в наблюдениях, удаление рассуждений может убрать сведения, которые нужны учителю.
Источники
Иллюстрация: рисунок из статьи «State-OPD: State-Grounded On-Policy Distillation for Multi-Turn Agents», Zhentao Zhang, Yanzhao Zheng, Yanlin Liu и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


