
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Долгие LLM-агенты могут сохранять результаты работы, не сохраняя собственный диалог. Команда Stanford University, Carnegie Mellon University, University of Washington, SambaNova Systems и UC Berkeley представила SLA: на оптимизации ядра система достигла результата сильнейшего конкурента, потратив на 93% меньше токенов, хотя работа ещё не рецензирована, а замеры выполнили сами авторы.
Для команд, которые строят многочасовой поиск по коду, архитектурное следствие прямое: историю экспериментов стоит хранить в управляющем контуре, а каждому агенту собирать новый контекст под конкретную задачу.
Состояние поиска отделили от памяти агента
Обычный агент продолжает один диалог: читает старые сообщения, добавляет рассуждения и постепенно раздувает контекст. Вместе с полезными результатами он наследует прежние предположения, повторяющиеся инструкции и решения прекратить поиск.
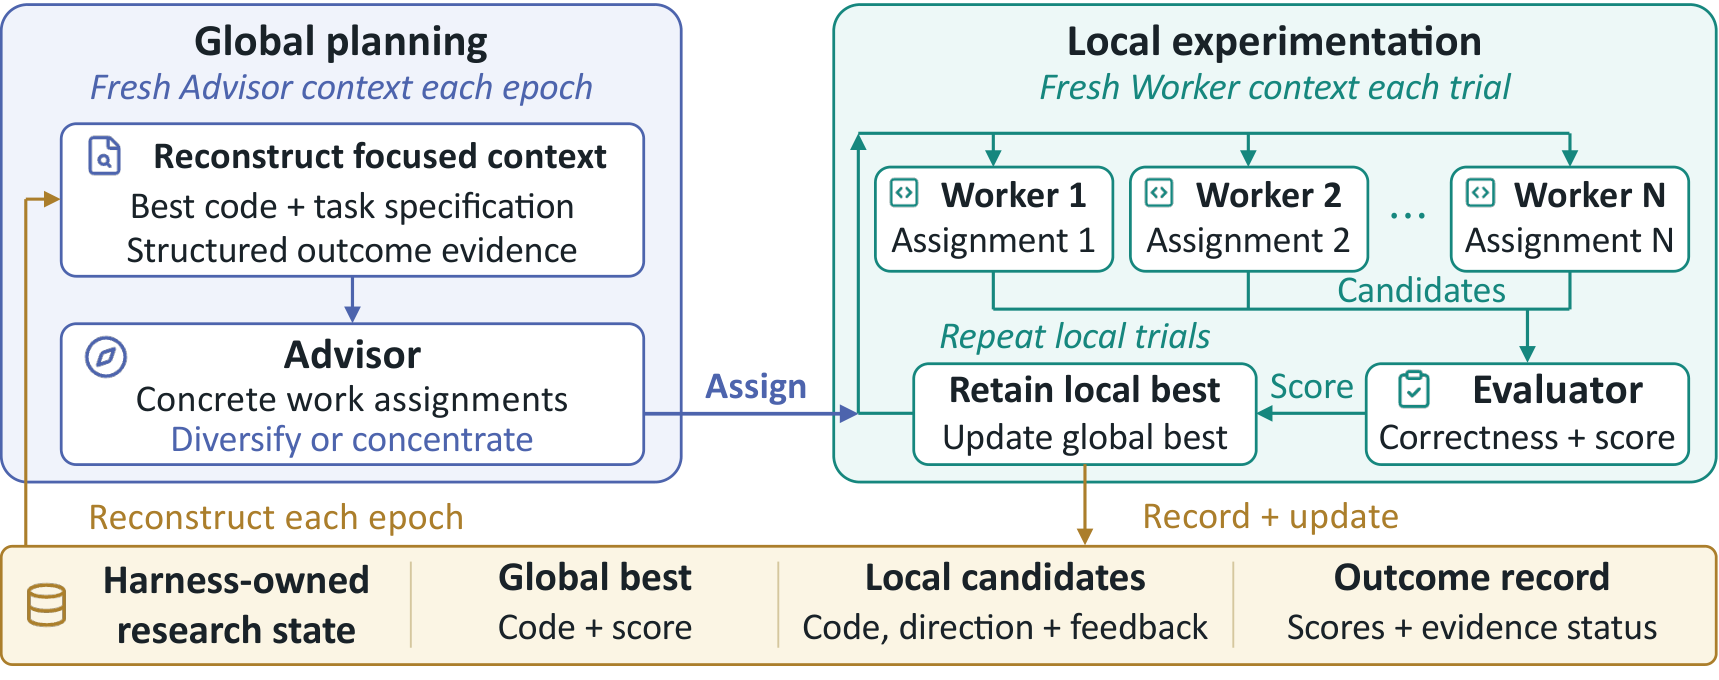
В SLA постоянное состояние хранит управляющий контур (harness). Он записывает варианты кода, результаты автоматической проверки, неудачные попытки и текущие направления поиска. Каждый вызов агента начинается с чистой сессии, а нужные сведения заново собираются из этих записей.
Работу делят две роли. Координатор Advisor видит сводку по всем направлениям, сравнивает результаты и назначает конкретные эксперименты. Параллельные исполнители Worker получают только задание, свой сохранённый вариант решения и локальную обратную связь.
Такое разделение меняет не только размер контекста. Система отличает проверенную неудачную идею от сбоя при запуске, разводит исполнителей по разным направлениям и не позволяет старому решению «дальше пробовать бессмысленно» автоматически перейти в следующую сессию.
Код и измеренные результаты при этом не теряются. Исчезает лишь разговор, который привёл к ним. Поэтому состояние можно проверить, сохранить в контрольной точке или откатить без восстановления внутренней истории каждого агента.
Преимущество проявилось только на длинной дистанции
SLA сравнивали с EvoX, CORAL и SwarmResearch на разработке программ, оптимизации вычислительных ядер и проектировании алгоритмов. Использовали Codex с GPT-5.5 и Claude Code с Claude Opus 4.8; бюджет отдельных запусков доходил до миллиарда токенов.
На задаче Anthropic по оптимизации ядра конфигурация с Codex достигла итогового уровня сильнейшей альтернативы с экономией 93% токенов. С Claude Code экономия составила 84%. На FrontierSWE SLA уступала лучшей альтернативе при 175 миллионах токенов, но лидировала при 700 миллионах.
Этот разворот важнее итогового места в таблице. Короткий запуск оценивал скорость раннего поиска, но не показывал, продолжит ли система находить улучшения после накопления большой истории. В одном запуске CORAL агенты перестали вызывать инструменты и продолжили расходовать токены, поскольку возобновлялись из диалогов, где уже решили, что решение оптимально.
Проверки с общих контрольных точек показали, что вклад дают оба элемента: изолированный контекст исполнителей и конкретные назначения от Advisor. Сам координатор расходовал меньше 0,6% токенов, поэтому экономия возникла не из-за отказа от координации, а из-за её отделения от исполнения.
Границы эксперимента заданы задачами с исполняемыми автоматическими проверками и понятной численной целью. Большинство дорогих конфигураций запускали по одному разу; повторяли только опыт с ядром Anthropic на Codex и проверки отдельных компонентов. Сравнение учитывает токены моделей, но не вычисления для запуска и оценки созданных программ.
Когда ради SLA стоит менять архитектуру продукта
Работа меняет планы систем, где агент часами улучшает код, конфигурацию или другой проверяемый результат. В такой системе долговременную память лучше проектировать как явную модель данных: кандидат, измеренный результат, статус попытки, направление поиска и источник изменения. Диалог агента не должен оставаться единственным местом, где хранится эта информация.
Следующий практический шаг — собирать контекст по роли. Координатору нужна картина направлений и результатов, исполнителю — узкое задание и локальная обратная связь. Это упрощает замену модели для отдельной роли и позволяет независимо ограничивать её контекст.
Меняется и метод испытаний. Пилот на малом бюджете может выбрать систему, которая быстро находит первый приемлемый вариант, но затем перестаёт экспериментировать. Сравнивать архитектуры нужно в нескольких точках бюджета и отдельно проверять, продолжают ли агенты запускать осмысленные опыты.
Для коротких помощников, разовых задач и процессов без автоматического оценщика вывод слабее. SLA проверяли там, где результат можно исполнить и сразу измерить; работа с расплывчатой целью или медленной ручной проверкой в эти эксперименты не входила.
Главная инженерная идея не требует копировать весь SLA. Если поиск должен жить дольше одного контекстного окна, постоянное состояние стоит вынести из разговора и сделать частью инфраструктуры. Тогда дополнительный бюджет покупает новые эксперименты, а не повторное чтение старой переписки.
Источники
Иллюстрация: рисунок из статьи «Stateless Language Agents: Scaling Long-Horizon Automated Research», Qizheng Zhang, Changxiu Ji, Isaac Sun и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


