
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Квантизированного ИИ-агента научили исправлять ошибки, вызванные уменьшенной разрядностью весов, и затем работать без помощи полноточной модели. В работе AIR, Tsinghua University и University of Science and Technology of China, которая не прошла рецензирование и в которой все числа получили сами авторы, SteerDistill поднял средний результат Qwen3-8B на 2,18 пункта относительно сильнейшего квантизированного конкурента. Это позволяет сокращать требования к памяти, не меняя архитектуру агента и не подключая модель-учителя при каждом запросе.
Квантизация хранит веса модели с меньшей точностью, но агент из-за этого может пропускать условия задачи. Например, он пытается прочитать файл до перехода в нужный каталог или создаёт запрошенные файлы, но оставляет часть из них пустыми. Обычное обучение по готовому набору данных часто не содержит именно того состояния, в котором агент ошибся.
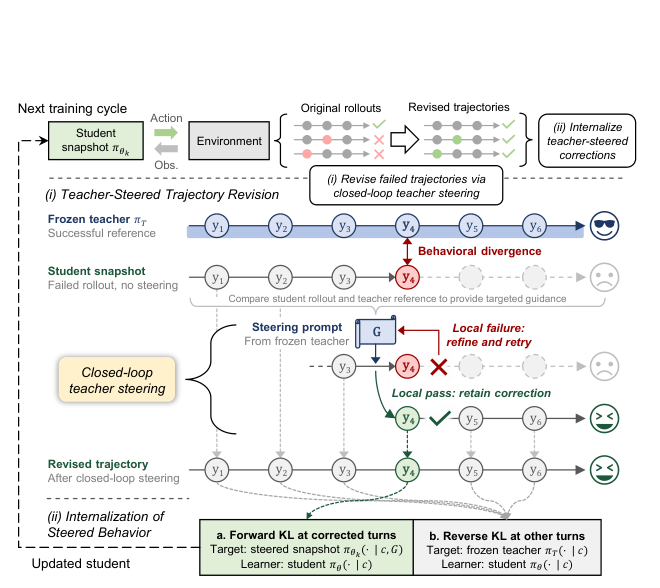
SteerDistill сравнивает не формулировки действий, а изменения среды после них. При расхождении система возвращает агента к состоянию перед ошибкой, а полноточная модель указывает пропущенное условие. Агент сам предлагает исправленное действие, выполняет его, а учитель уточняет подсказку по результату; исправление сохраняют, только если среда перешла в нужное состояние.
Затем подсказки убирают и переучивают агента воспроизводить исправленное поведение самостоятельно. В диагностике BFCL V4 четыре повторные попытки без помощи давали верное действие на 9,6% проблемных шагов, а управление со стороны учителя подняло долю до 82,3%. При работе SteerDistill использует только квантизированную модель.
Метод проверили на BFCL V4, τ2-Bench, WebShop, ALFWorld и Search QA с моделями Qwen3-8B, Qwen3.5-4B и Gemma 4 12B-it. Основной режим использовал четырёхбитные веса и активации BF16; сравнение включало GPTQ, EfficientQAT, BitDistiller, On-Policy QAD и QeRL. Поэтому результат относится прежде всего к агентам, которые вызывают инструменты и проходят многошаговые задачи, а не к обычным одиночным ответам LLM.
Источники
Иллюстрация: рисунок из статьи «SteerDistill: Quantizing LLM Agents via Closed-Loop Teacher Steering», Genming Cui, Xiangyu Li, Zixu Hao и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


