
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Сжатие памяти LLM-агента научились согласовывать с его шагами: раннее наблюдение можно сохранить, даже если модель давно перестала часто к нему обращаться. В препринте Boyu Feng и соавторов, который не проходил рецензирование и содержит замеры самих авторов, удаление оценки шага из StepKV снизило долю точных ответов на 2Wiki на 15,6 процентного пункта. Для команд это новый вариант оптимизации агентов с длинными цепочками поиска и вызовов инструментов.
Токен не всегда отражает ценность шага
При генерации модель хранит ключи и значения предыдущих токенов в кеше ключей и значений (KV-кеше). Благодаря этому ей не приходится заново вычислять всё предыдущее состояние, однако кеш растёт вместе с контекстом и требует всё больше памяти и операций чтения.
Обычные методы сжатия оставляют токены, которые недавно использовались или получили высокие оценки внимания. Для простого длинного текста этого может быть достаточно. У агента контекст устроен иначе: он состоит из рассуждений, действий, ответов инструментов и найденных свидетельств.
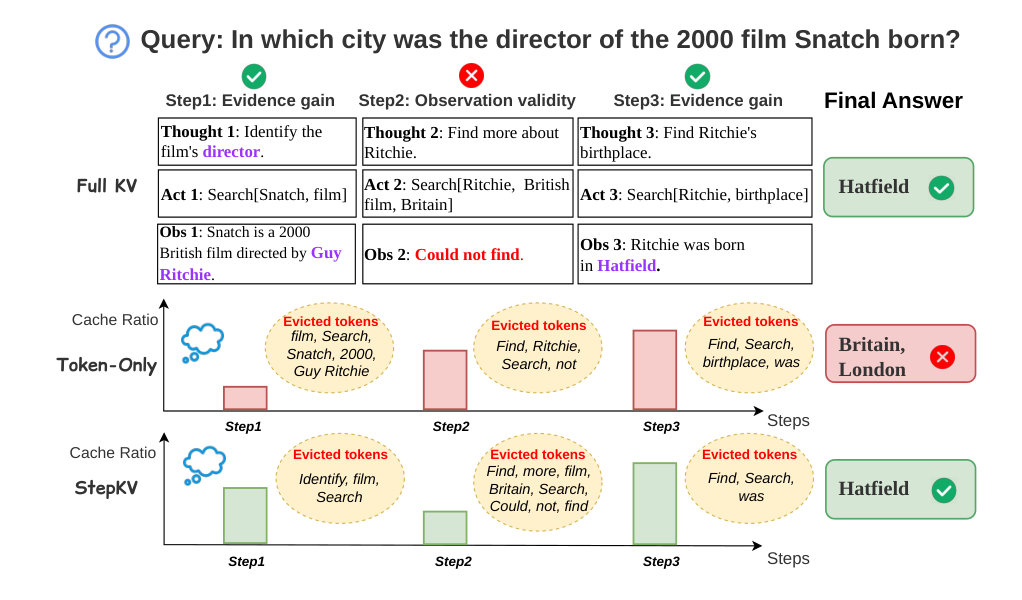
Ценное наблюдение может появиться в начале поиска, несколько шагов не привлекать внимания, а затем понадобиться для окончательного вывода. Если оценивать только отдельные токены, от такого шага остаются фрагменты. Авторы называют этот сбой разрывом непрерывности рассуждения: бюджет кеша соблюдён, но агент уже не может восстановить связь между собранными фактами.
В контрольном опыте удаление предыдущего или более раннего шага ухудшало долю точных ответов и качество совпадения с эталоном. Удаление всей истории, кроме недавней, тоже вредило результату. Значит, возраст записи сам по себе плохо показывает, понадобится ли она дальше.
Как StepKV оценивает полезность шага
StepKV не сохраняет каждый важный шаг целиком. Метод назначает общую оценку завершённому шагу, а затем объединяет её со значимостью отдельных токенов. В пределах полезного шага кеш всё ещё можно сократить, удалив второстепенные формулировки.
Начальная оценка опирается на структуру типичного агента: рассуждение, действие и наблюдение. Метод проверяет, вернул ли инструмент пригодный результат, добавил ли шаг новые свидетельства и не повторяет ли действие уже пройденный путь. Ошибка инструмента или пустой ответ не получают такой же приоритет, как новое наблюдение.
Оценка не остаётся постоянной. Когда последующие рассуждения повторно используют сведения из раннего шага, StepKV повышает его полезность. Это позволяет учитывать отложенную ценность: во время появления факта ещё может быть неясно, что через несколько вызовов инструмента он свяжет остальные свидетельства.
После обновления оценок метод смешивает полезность шага со значимостью токена. Все доступные для удаления токены попадают в общий рейтинг, а кеш сохраняет верхнюю часть списка в пределах заданного бюджета. Поэтому StepKV не делит память поровну между шагами: важные получают больше места, повторные и неудачные — меньше.
Разбор компонентов подтверждает, что двух уровней недостаточно по отдельности. Без оценки шага качество падало сильнее и стабильнее, чем без оценки токена. Но отказ от токенной оценки тоже ухудшал большинство результатов, особенно на MuSiQue. Отдельный шаг задаёт приоритет, а выбор токенов не даёт сохранять его целиком без необходимости.
Меняет ли StepKV планы агентных команд
Работу проверяли на Qwen2.5-7B-Instruct и Llama-3.1-8B-Instruct в задачах HotpotQA, 2Wiki, MuSiQue и BrowseComp-Plus. StepKV сравнивали с полным кешем и токенными методами H2O и TOVA. Проверка охватывает многошаговые ответы на вопросы и веб-поиск, но не обычные чаты или генерацию кода.
При бюджете в 50% кеша StepKV сокращал разрыв с полным кешем, тогда как токенные варианты теряли заметную часть качества ответов. На BrowseComp-Plus метод работал с историями длиннее 100 000 токенов, уменьшал итоговый кеш и задержку, а по доле точных ответов и качеству совпадения иногда превосходил полный кеш. Авторы связывают это с удалением повторного контекста, который мешает дальнейшему рассуждению.
Менять архитектуру продукта только по этой работе рано, но единицу управления памятью стоит пересмотреть уже на этапе проектирования. Если агент явно разделяет рассуждение, действие и наблюдение, инфраструктура может привязать записи кеша к этим границам и обновлять их при завершении каждого шага.
Практическое внедрение потребует доступа к KV-кешу и процессу удаления записей во время вывода модели. Метод поэтому относится прежде всего к собственному контуру запуска, а не к вызову закрытой модели через API, где кешем управляет поставщик. Для таких систем работа полезна как принцип проектирования: память агента следует распределять по будущей ценности этапов, а не только по недавнему вниманию к отдельным токенам.
Источники
Иллюстрация: рисунок из статьи «StepKV: Step-Aware KV Cache Compression for LLM Agents», Boyu Feng, Jiahong Liu, Yifan Li и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


