
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Управляющую обвязку ИИ-агента научились менять под конкретную задачу без генерации нового кода. В препринте University of Illinois Urbana-Champaign и University of Michigan, который не прошёл рецензирование и приводит замеры самих авторов, STITCH повысил долю успешно выполненных задач до 12 процентных пунктов относительно фиксированных обвязок. Подход предлагает хранить проверенные механизмы отдельно и подключать только те, которые нужны текущей задаче.
Единая обвязка помогает не всем задачам
Обвязка управляет работой модели: собирает контекст, вызывает инструменты, передаёт наблюдения, хранит промежуточное состояние и решает, когда остановиться. Один и тот же механизм может улучшить результат в своей области применения, но добавить лишний контекст или действия в другой.
Например, агенту может пригодиться карта файлов и символов репозитория, если изменение затрагивает несколько модулей. Для локальной правки такой шаг способен лишь увеличить запрос и отвлечь модель. Фиксированная обвязка вынуждает команду либо включать механизм везде, либо полностью от него отказываться.
Авторы описывают этот конфликт в упрощённой математической модели. Если механизм приносит пользу части задач и штрафует остальные, обвязка с выбором по задаче превосходит любую постоянную конфигурацию. Вывод зависит от допущений модели: эффекты механизмов складываются, а любые их сочетания допустимы.
Генерировать всю обвязку заново перед каждым запуском тоже рискованно. Каждый дополнительный фрагмент кода может содержать синтаксическую ошибку, неверную логику или несовместимый интерфейс. В модели работы вероятность получить исполняемую обвязку падает по мере роста числа независимо сгенерированных механизмов.
Примитивы отделяют выбор механизма от его реализации
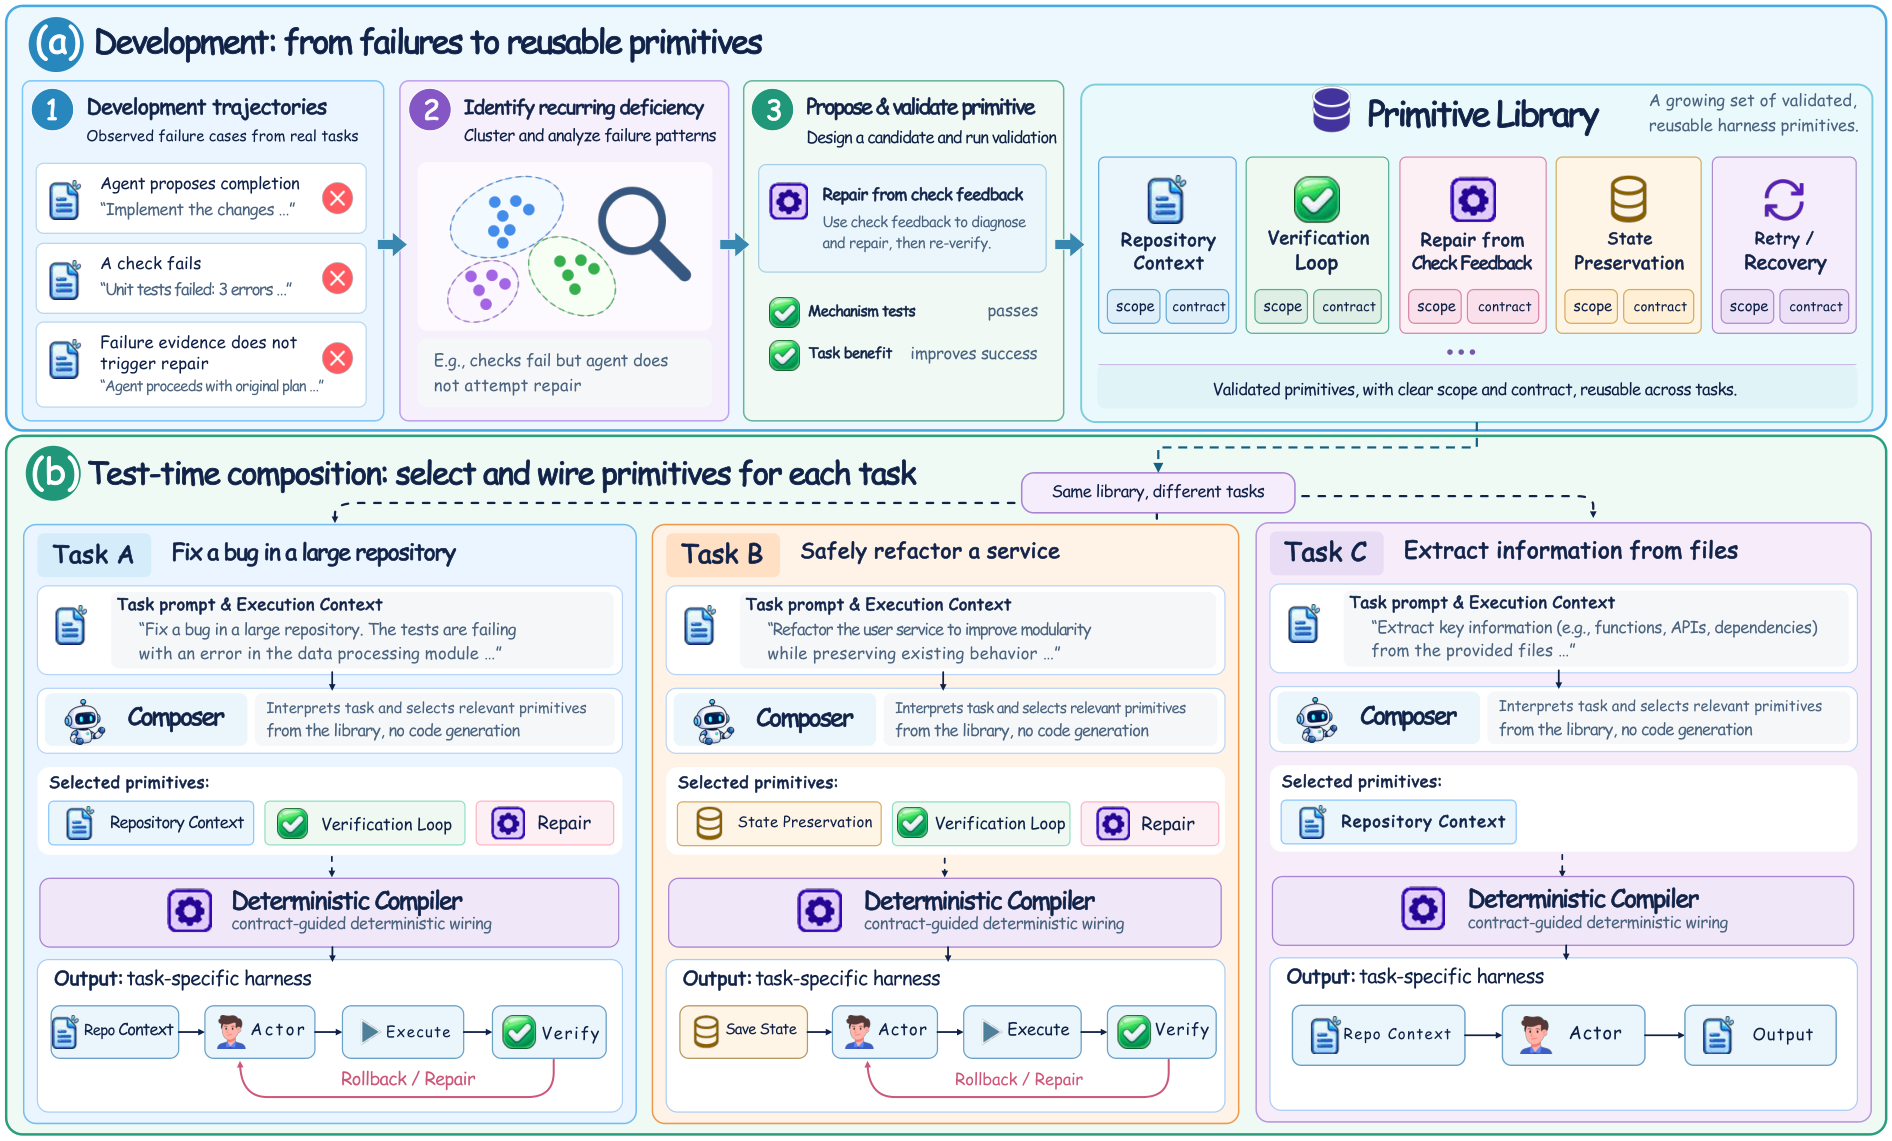
STITCH заменяет генерацию кода библиотекой примитивов — готовых операций управления агентом. Каждый примитив содержит описание области применения и контракт: какие данные он принимает, что возвращает, от каких компонентов зависит и какие требования предъявляет к среде.
Библиотеку строят заранее на неудачных траекториях агента. Модель-разработчик ищет повторяющиеся причины сбоев, предлагает механизм, реализует его и проверяет отдельно корректность работы и пользу для результата. В библиотеку принимают только примитивы, которые улучшили выполнение задач на этапе разработки.
Перед запуском компоновщик читает инструкцию, сведения о среде и описания примитивов. Он выбирает нужные операции, но не пишет их код и не соединяет компоненты самостоятельно. Затем детерминированный компилятор добавляет примитивы в базовый граф выполнения, подставляет зависимости и проверяет соединения, достижимость завершения и ограниченность циклов.
На SWE-bench Verified и Terminal-Bench 2 подход прибавил до 12 процентных пунктов к доле решённых задач и обошёл фиксированные системы, включая Codex CLI. Все выбранные примитивы активировались во время выполнения без ошибок — 100% в проведённых запусках.
На Terminal-Bench компоновка стоила 2,7% от одного запуска агента. Генерация полной реализации с нуля оказалась в 638 раз дороже даже при оптимистичном расчёте, который учитывал только вывод готового кода и исключал чтение входных данных, рассуждение и отладку. При переносе примитивов между доменами прирост на одной из конфигураций составил 11,1 процентного пункта.
Менять архитектуру стоит после повторяющихся сбоев
Работа меняет планы команд, которые обслуживают разнородный поток задач одним агентом. Вместо расширения общего системного запроса и усложнения единого цикла можно выделять повторяющиеся способы контроля в проверенные операции, а затем выбирать их по инструкции и среде.
Практическая граница проходит между выбором и реализацией. LLM решает, какие механизмы нужны, а обычный код отвечает за их подключение. Такая схема уменьшает поверхность для ошибок по сравнению с генерацией исполняемой обвязки и позволяет тестировать каждый механизм отдельно.
Проверки охватывают задачи программной инженерии и работы в терминале на удержанных частях SWE-bench Verified и Terminal-Bench 2. Примитивы также переносили между несколькими моделями и доменами; реализации и контракты сохраняли, но области применения корректировали по результатам на задачах разработки.
STITCH не отменяет затрат на создание библиотеки. Нужно собрать неудачные траектории, реализовать механизмы, проверить их эффект и описать совместимость. Эксперименты оценивают выполнение после этой подготовки, поэтому не показывают, сколько запусков потребуется конкретной команде, чтобы окупить разработку примитивов.
Для продукта с узким и стабильным сценарием фиксированная обвязка остаётся более простой конструкцией. STITCH становится кандидатом на отдельный архитектурный слой там, где требования к контексту, проверкам и инструментам заметно меняются от задачи к задаче, а одни и те же причины сбоев повторяются.
Источники
Иллюстрация: рисунок из статьи «Composing Task-specific Agent Harnesses at Test Time with Reusable Primitives», Peng Kuang, Haibo Jin, Dehao Wu и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


