
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Контекст для RAG научились сокращать по-разному для каждого найденного фрагмента, сохраняя предложения, на которых держится ответ. Метод StitchRAG разработали Minsang Kim, Junpyo Lim, Heeje Cho и Seungjun Baek из Korea University и SK Telecom, хотя препринт не рецензирован, а все числа получили сами авторы. StitchRAG показал лучший F1 на четырёх из пяти наборов вопросов, но добавил отдельные этапы обработки перед вызовом основной LLM.
Каждый фрагмент получает свой бюджет
Обычный компрессор часто оставляет одинаковую долю текста во всех найденных фрагментах. Это плохо сочетается с самим поиском: один документ может прямо отвечать на вопрос, другой — содержать только косвенную подсказку, а третий — оказаться шумом.
StitchRAG сначала просит LLM оценить, пригодится ли конкретный фрагмент для ответа. Модель сравнивает вероятности ответов Yes и No, а система превращает их в оценку релевантности.
Затем StitchRAG рассчитывает, какую долю фрагмента оставить. Целевая функция сопоставляет полезность текста и вычислительную цену: дополнительный контекст приносит всё меньше новой информации, а цена внимания растёт вместе с длиной последовательности. Поэтому релевантный фрагмент получает больший бюджет, а слабый сокращается сильнее.
Здесь важна не сама формула, а смена единицы управления. Команда задаёт не общий предел для всего контекста и не постоянный коэффициент сжатия, а отдельный предел для каждого результата поиска.
Опорные предложения остаются дословными
После распределения бюджета StitchRAG ищет якоря двух типов. Сначала LLM предлагает возможный ответ и выделяет смысловые опоры, которые могут не повторять формулировку вопроса. Параллельно TF-IDF находит редкие слова и точные названия, тесно связанные с запросом.
Система сохраняет целиком предложения, содержащие такие якоря. Если бюджет ещё не исчерпан, она добавляет предложения со словами из вопроса, а затем предпочитает более ранние фразы из фрагмента. Такой порядок защищает имена, даты и формулировки ответа, но не режет текст на отдельные токены.
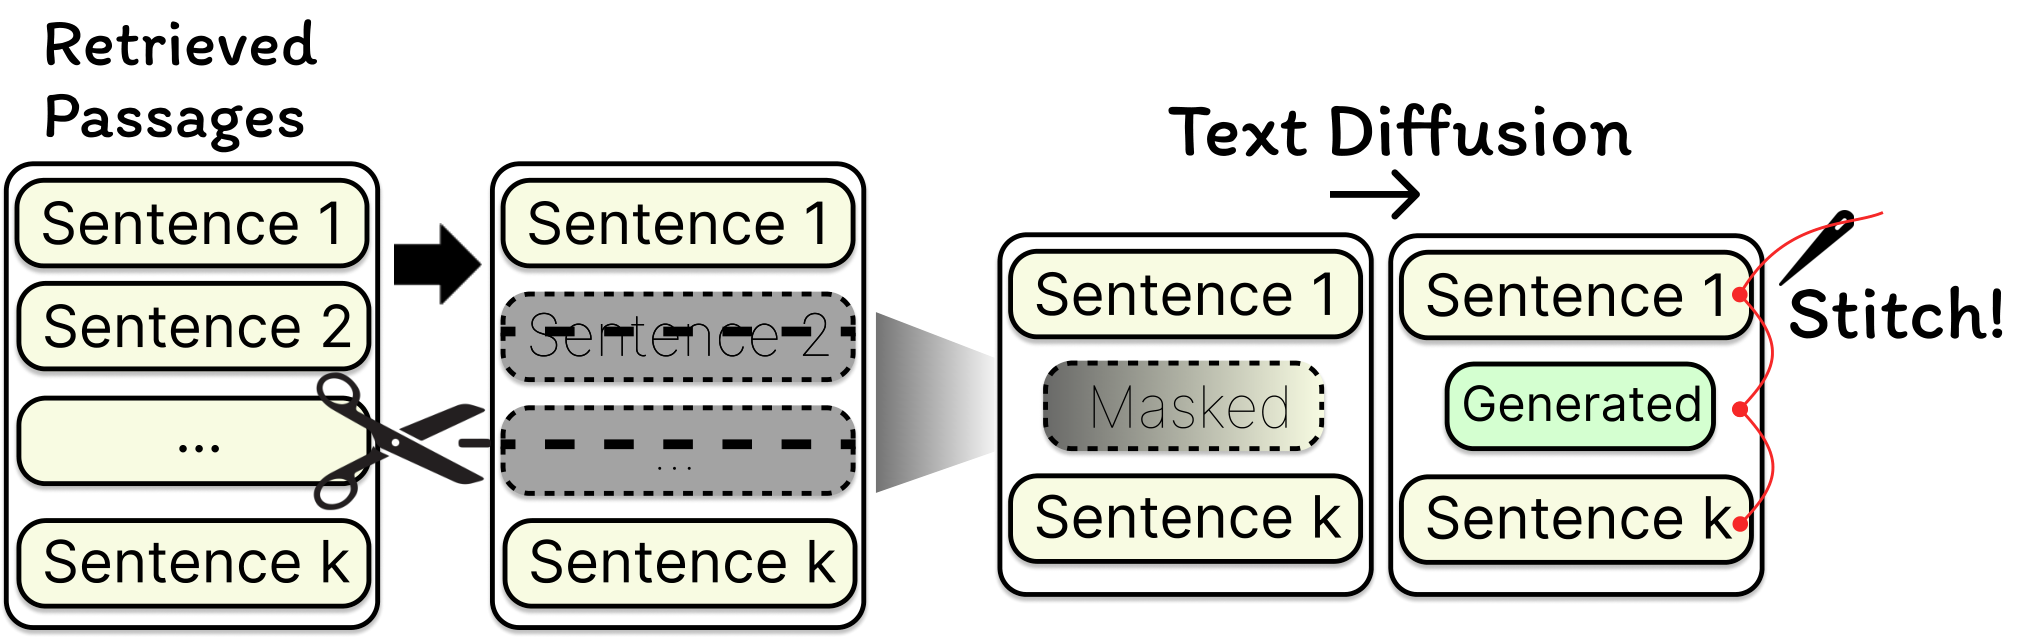
После удаления лишних предложений контекст становится рваным: соседние фразы могли находиться далеко друг от друга или прийти из разных документов. StitchRAG вставляет между ними маски и заполняет промежутки с помощью диффузионной языковой модели. Она видит текст с обеих сторон разрыва и создаёт связку параллельно, а не продолжает фразу только слева направо.
Сохранённые предложения при этом заморожены: модель меняет лишь вставленные промежутки. Это не гарантирует истинность всего итогового ответа, но не позволяет этапу склейки перефразировать выбранные доказательства.
Метод проверяли на пяти наборах открытых вопросов: HotpotQA, Natural Questions, TriviaQA, PopQA и 2WikiMultiHopQA. Для каждого брали по 500 примеров и сравнивали StitchRAG со стандартным RAG, компрессорами LongLLMLingua, RECOMP и Selective Context, а также многошаговыми системами. F1 учитывает точность и полноту совпадения ответа, а точное совпадение засчитывает только полностью совпавший ответ.
Лучший F1 не означал лидерства по каждой метрике. Например, на 2Wiki метод DRAG получил точное совпадение 28,8, а StitchRAG — 27,8. Разбор отдельных компонентов всё же подтвердил конструкцию метода: постоянный бюджет уступил динамическому, один тип якорей уступил их сочетанию, а авторегрессионная склейка работала хуже диффузионной и даже варианта без склейки.
Планы меняются, если узкое место находится внутри контекста
StitchRAG предлагает промежуточный вариант между простым сокращением и многошаговым RAG. Он подходит архитектуре, где поиск уже возвращает подходящие документы, но длинный контекст приносит шум, задержку или лишние расходы. Средняя сохранённая доля текста составила 72,7%, причём система распределяла этот объём неравномерно.
Считать метод бесплатной заменой обычного RAG нельзя. На подмножестве HotpotQA с GPU A100 один запрос занимал в среднем 10,62 секунды против 7,24 у базового RAG. При этом DRAG требовал 27,39 секунды, поэтому StitchRAG занял место между однопроходной и многошаговой схемами.
Для внедрения понадобятся модель, которая отдаёт вероятности Yes и No, генерация кандидата ответа, расчёт лексических якорей и отдельная диффузионная модель. Эти вызовы можно выполнять пакетно, но конвейер станет сложнее в эксплуатации и наблюдении.
Работу проверяли на открытых вопросах по материалам Wikipedia, веб-страниц и Wikidata; среди тестов были как прямые вопросы, так и задачи, где ответ собирают из нескольких документов. Поэтому результат обосновывает эксперимент с адаптивным сжатием в вопросно-ответных системах, но не переносит автоматически выводы на корпоративные документы, диалоги и контексты из программного кода.
Практический первый шаг — отделить распределение бюджета и защиту якорей от диффузионной склейки. Исследование показывает, что основную конструкцию можно проверить без переписывания всего RAG-конвейера, а усложнять связность текста стоит только после замеров качества и задержки на собственных запросах.
Источники
Иллюстрация: рисунок из статьи «StitchRAG: Constructing Compact and Evidence-Preserving Contexts for RAG with Diffusion-Based Stitching», Minsang Kim, Junpyo Lim, Heeje Cho и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


